


Dernière mise à jour : October 2026
1 Introduction
Ce manuel présente phonokit et ses fonctions. La version la plus récente du manuel, toutefois, est celle du fichier PDF dans le liens ci-dessus phonokit est une bibliothèque Typst conçue pour simplifier la création de structures phonologiques tout en maintenant une précision typographique. Typst est un langage de programmation pour la composition typographique — un excellent tutoriel est disponible ici ainsi qu’une série d’introduction sur YouTube ici.
La bibliothèque fournit des fonctions intuitives pour la transcription API, les trapèzes vocaliques API (y compris un espace vocalique en 3D) et les tableaux de consonnes, les schémas de changements phonétiques, les diagrammes de VOT, les nuages de dispersion vocalique, les représentations prosodiques (syllabes, mores, pieds, mots prosodiques, grilles métriques), les profils de sonorité, la phonologie autosegmentale, les représentations multi-niveaux, la géométrie des traits, les matrices de traits SPE, les tableaux de la Théorie de l’Optimalité, la Grammaire harmonique, la Grammaire harmonique stochastique, les grammaires à entropie maximale, les diagrammes de Hasse, les exemples linguistiques numérotés et les symboles utilitaires. Les objectifs principaux de phonokit sont de minimiser l’effort et de maximiser la qualité.
Le dépôt GitHub de la bibliothèque se trouve à guilhermegarcia/phonokit. Commentaires, suggestions et signalements de bogues sont bienvenus — veuillez ouvrir un issue dans le dépôt.
1.1 Installation
Les bibliothèques Typst sont chargées avec la fonction #import au début de votre document typ. Remplacez X.X.X par la version souhaitée :
Importation de la bibliothèque (Typst Universe)
#import "@preview/phonokit:X.X.X": *Le manuel PDF documente la dernière version sur GitHub, qui peut être plus récente que la dernière version publiée sur Typst Universe. Si une importation depuis @preview échoue avec une erreur « package not found », utilisez la version indiquée sur la page de la bibliothèque ou chargez la bibliothèque localement.
Si vous souhaitez la version la plus récente, téléchargez ou clonez le dépôt et chargez la bibliothèque localement :
Importation locale
#import "phonokit/lib.typ": *Un lien symbolique peut être nécessaire selon la structure de vos fichiers, car Typst restreint les importations aux fichiers situés dans la racine de compilation et ses sous-répertoires.
1.2 Police
Toutes les fonctions de phonokit requièrent la police Charis pour fonctionner comme prévu (SIL International 2025). Depuis la version 0.3.7, l’utilisateur peut définir une police globale à utiliser par la bibliothèque dans l’ensemble du document :
Définir la police
#import "@preview/phonokit:X.X.X": *
#phonokit-init(font: "New Computer Modern")  // add to the top of your document
2 API
La transcription API est sans doute la fonctionnalité la plus utilisée lors de la composition de documents en phonologie. Typst prend directement en charge l’entrée Unicode ; techniquement, vous pouvez donc taper des symboles API sans package dédié. Cependant, vous préférerez peut-être utiliser un flux de travail basé sur des fonctions, surtout si vous venez de LaTeX. phonokit l’accomplit avec la fonction #ipa(), qui prend une chaîne de caractères en entrée. La fonction utilise la notation familière de tipa (Rei 1996), à quelques exceptions près (p. ex., l’accent secondaire est représenté par une virgule ,, et non par deux guillemets doubles "").
2.1 Transcription
Les symboles introduits par deux barres obliques inverses \\ ne doivent pas avoir de caractères adjacents. Pour les archiphonèmes, utilisez \\ suivi d’une lettre majuscule. Ainsi, #ipa("N") correspond à ŋ (sa valeur TIPA), tandis que #ipa("\\N") produit un N majuscule — un archiphonème — rendu avec la police de la bibliothèque, ce qui assure la cohérence typographique entre phonèmes et archiphonèmes. Voir les exemples dans Figure 1.
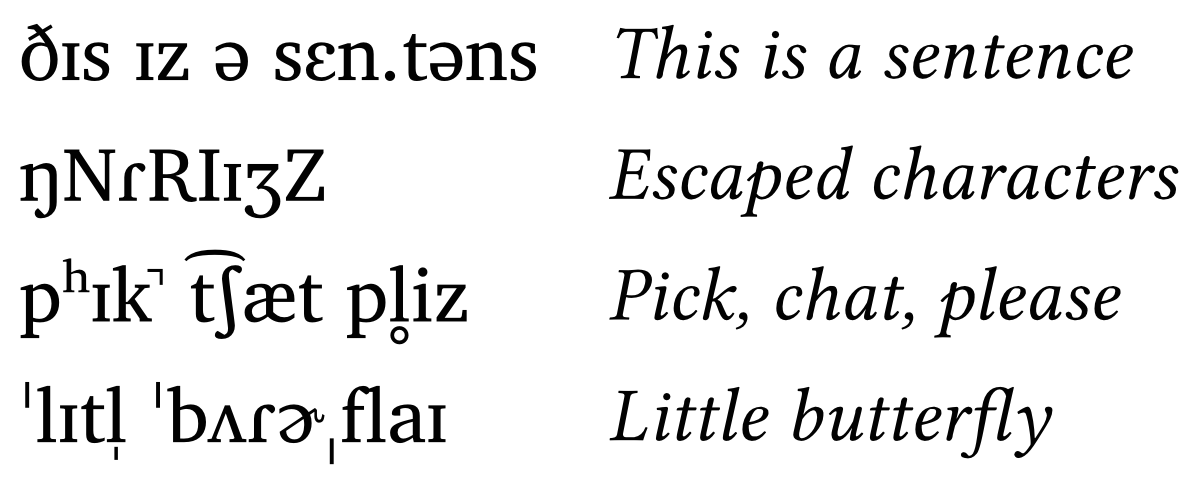
Exemples de transcription API
#ipa("DIs \\s Iz \\s @ \\s sEn.t@ns")
#ipa("N \\N R \\R \\I I Z \\Z")
#ipa("p \\h I k \\* \\s \\t tS \\ae t \\s p \\r l iz")
#ipa("'lIt \\v l \\s 'b2R \\schwar ,flaI")
Vous pouvez télécharger la fiche de référence en tant que fichier autonome ici.
2.2 Consonnes
Deux fonctions supplémentaires permettent aux utilisateurs de créer rapidement des tableaux de consonnes et des trapèzes vocaliques à partir d’une chaîne de phonèmes. La fonction #consonants() reproduit le tableau des consonnes pulmoniques du tableau API avec quelques modifications mineures. Par exemple, les affriquées sont affichées avec affricates: true, et l’argument abbreviate: true abrège les étiquettes des lignes et colonnes. Figure 2 montre l’inventaire consonantique de l’italien.
Tableau de consonnes (italien)
#consonants("italian", affricates: true, abbreviate: true)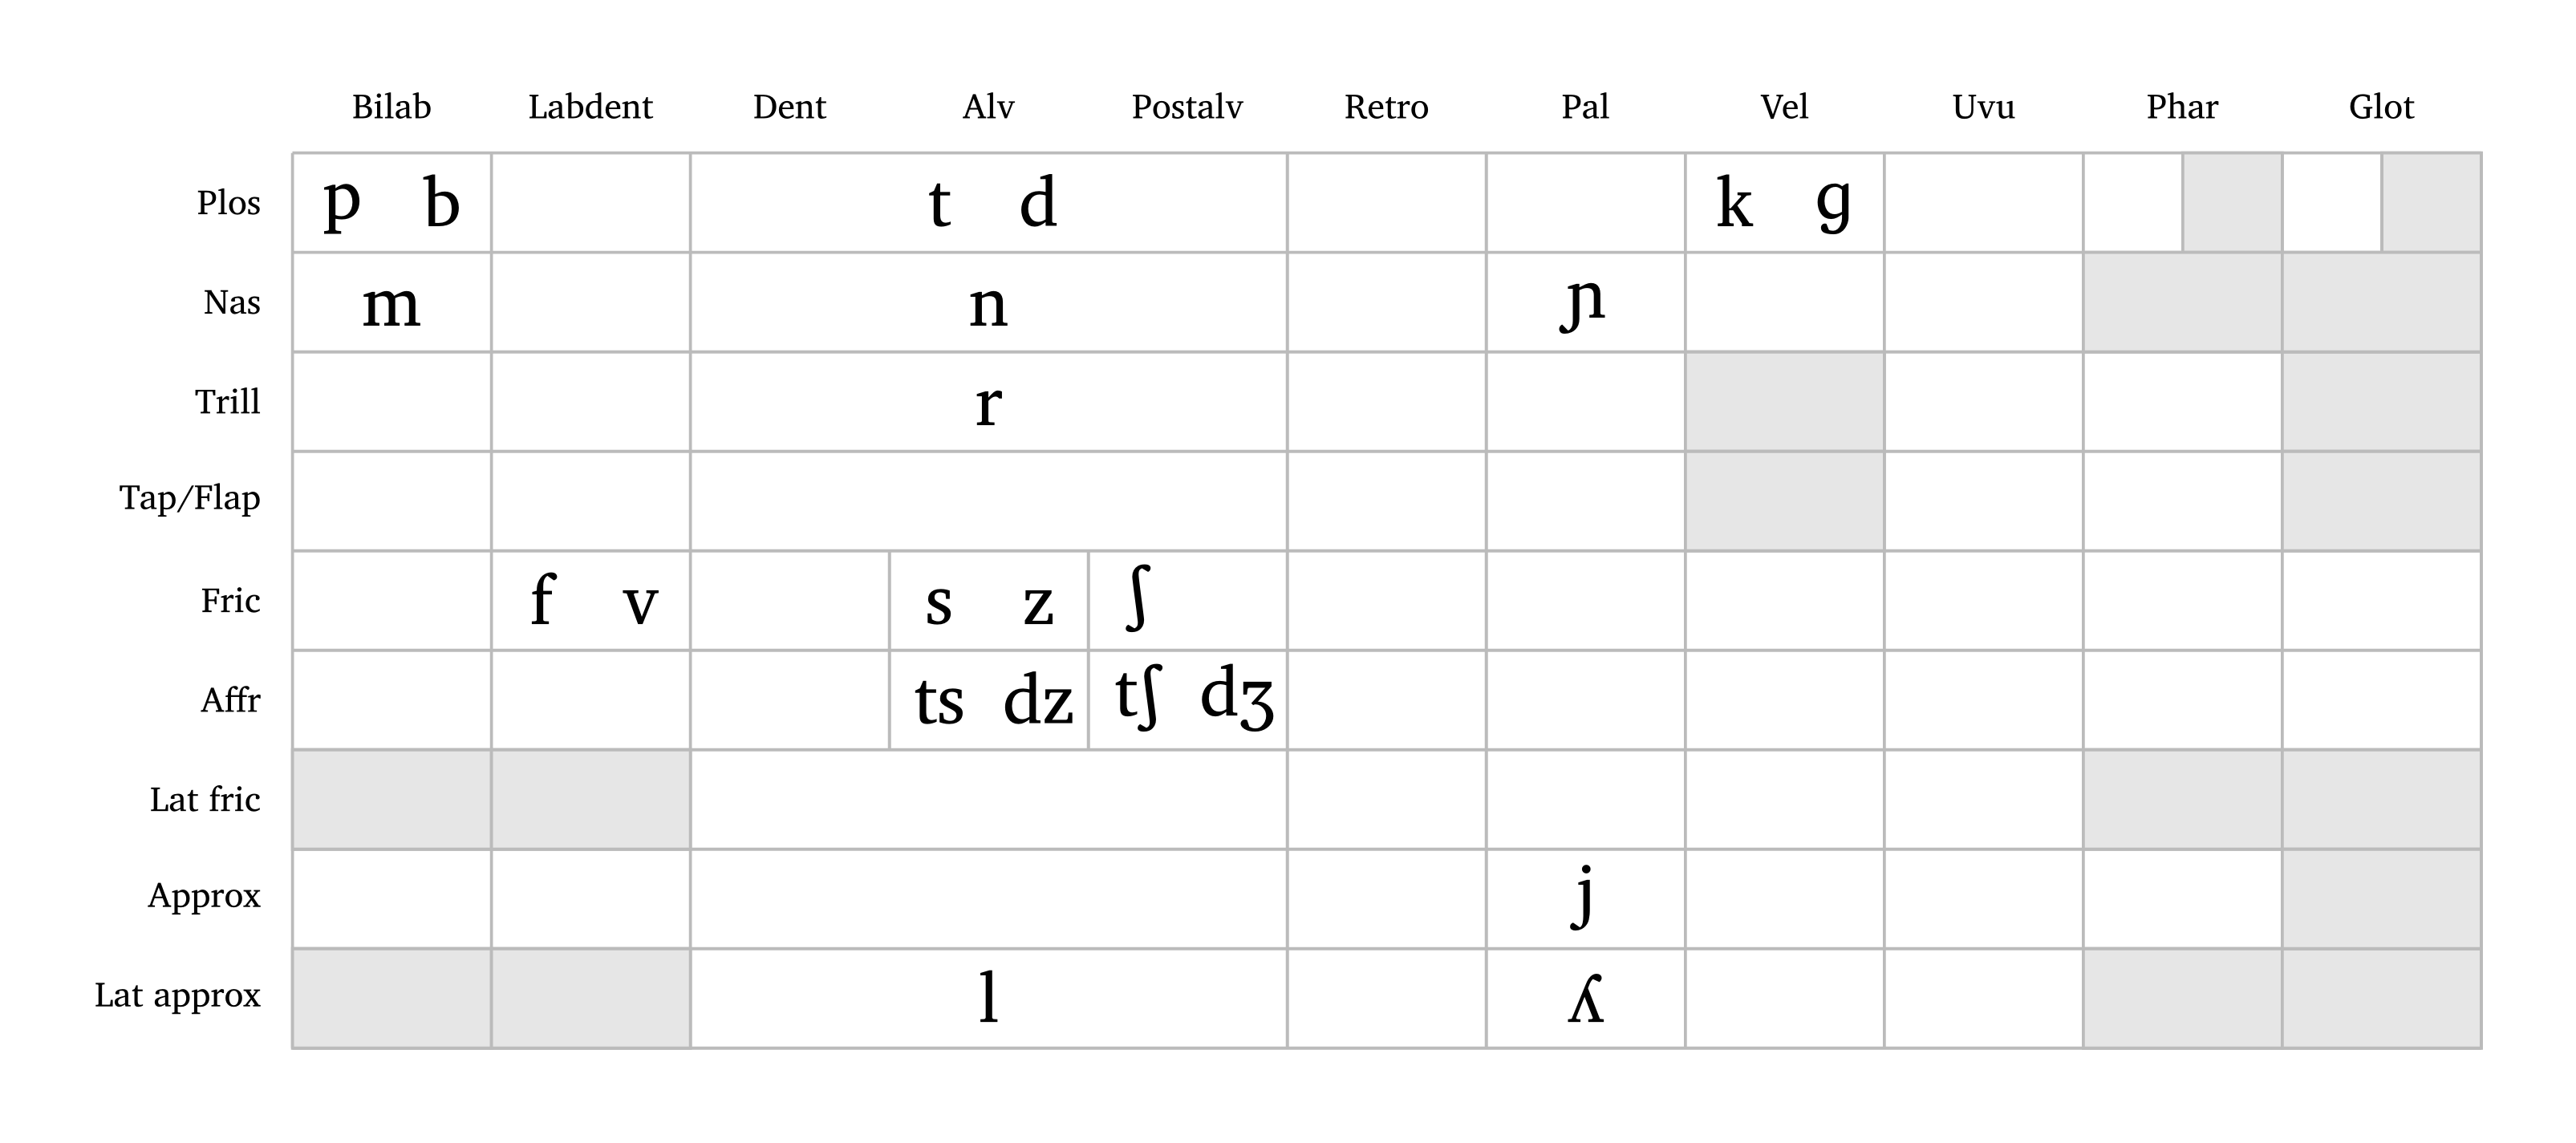
L’utilisateur peut saisir un nom de langue (Arabic, English, French, German, Italian, Japanese, Portuguese, Russian, Spanish — tous en minuscules ; aussi all pour toutes les consonnes) ou une chaîne de consonnes pour créer un inventaire personnalisé. Les consonnes personnalisées suivent le même format d’entrée que #ipa(). Les affriquées et les consonnes aspirées nécessitent des accolades et les arguments affricates: true et aspirated: true, comme le montre la légende de Figure 3. Chaque symbole peut être coloré avec phoneme-colors (p. ex., phoneme-colors: ("p": red, "t": blue)), et les étiquettes peuvent être affichées en français ou en portugais avec ui-lang: "fr" ou ui-lang: "pt" (aussi disponible dans #feat-matrix(), #geom() et #geom-group()). La fonction prend également en charge le redimensionnement flexible avec l’argument scale.
Tableau de consonnes personnalisé
#consonants("ts{ts}psS \\*r g{tS} {k \\h}", affricates: true, aspirated: true)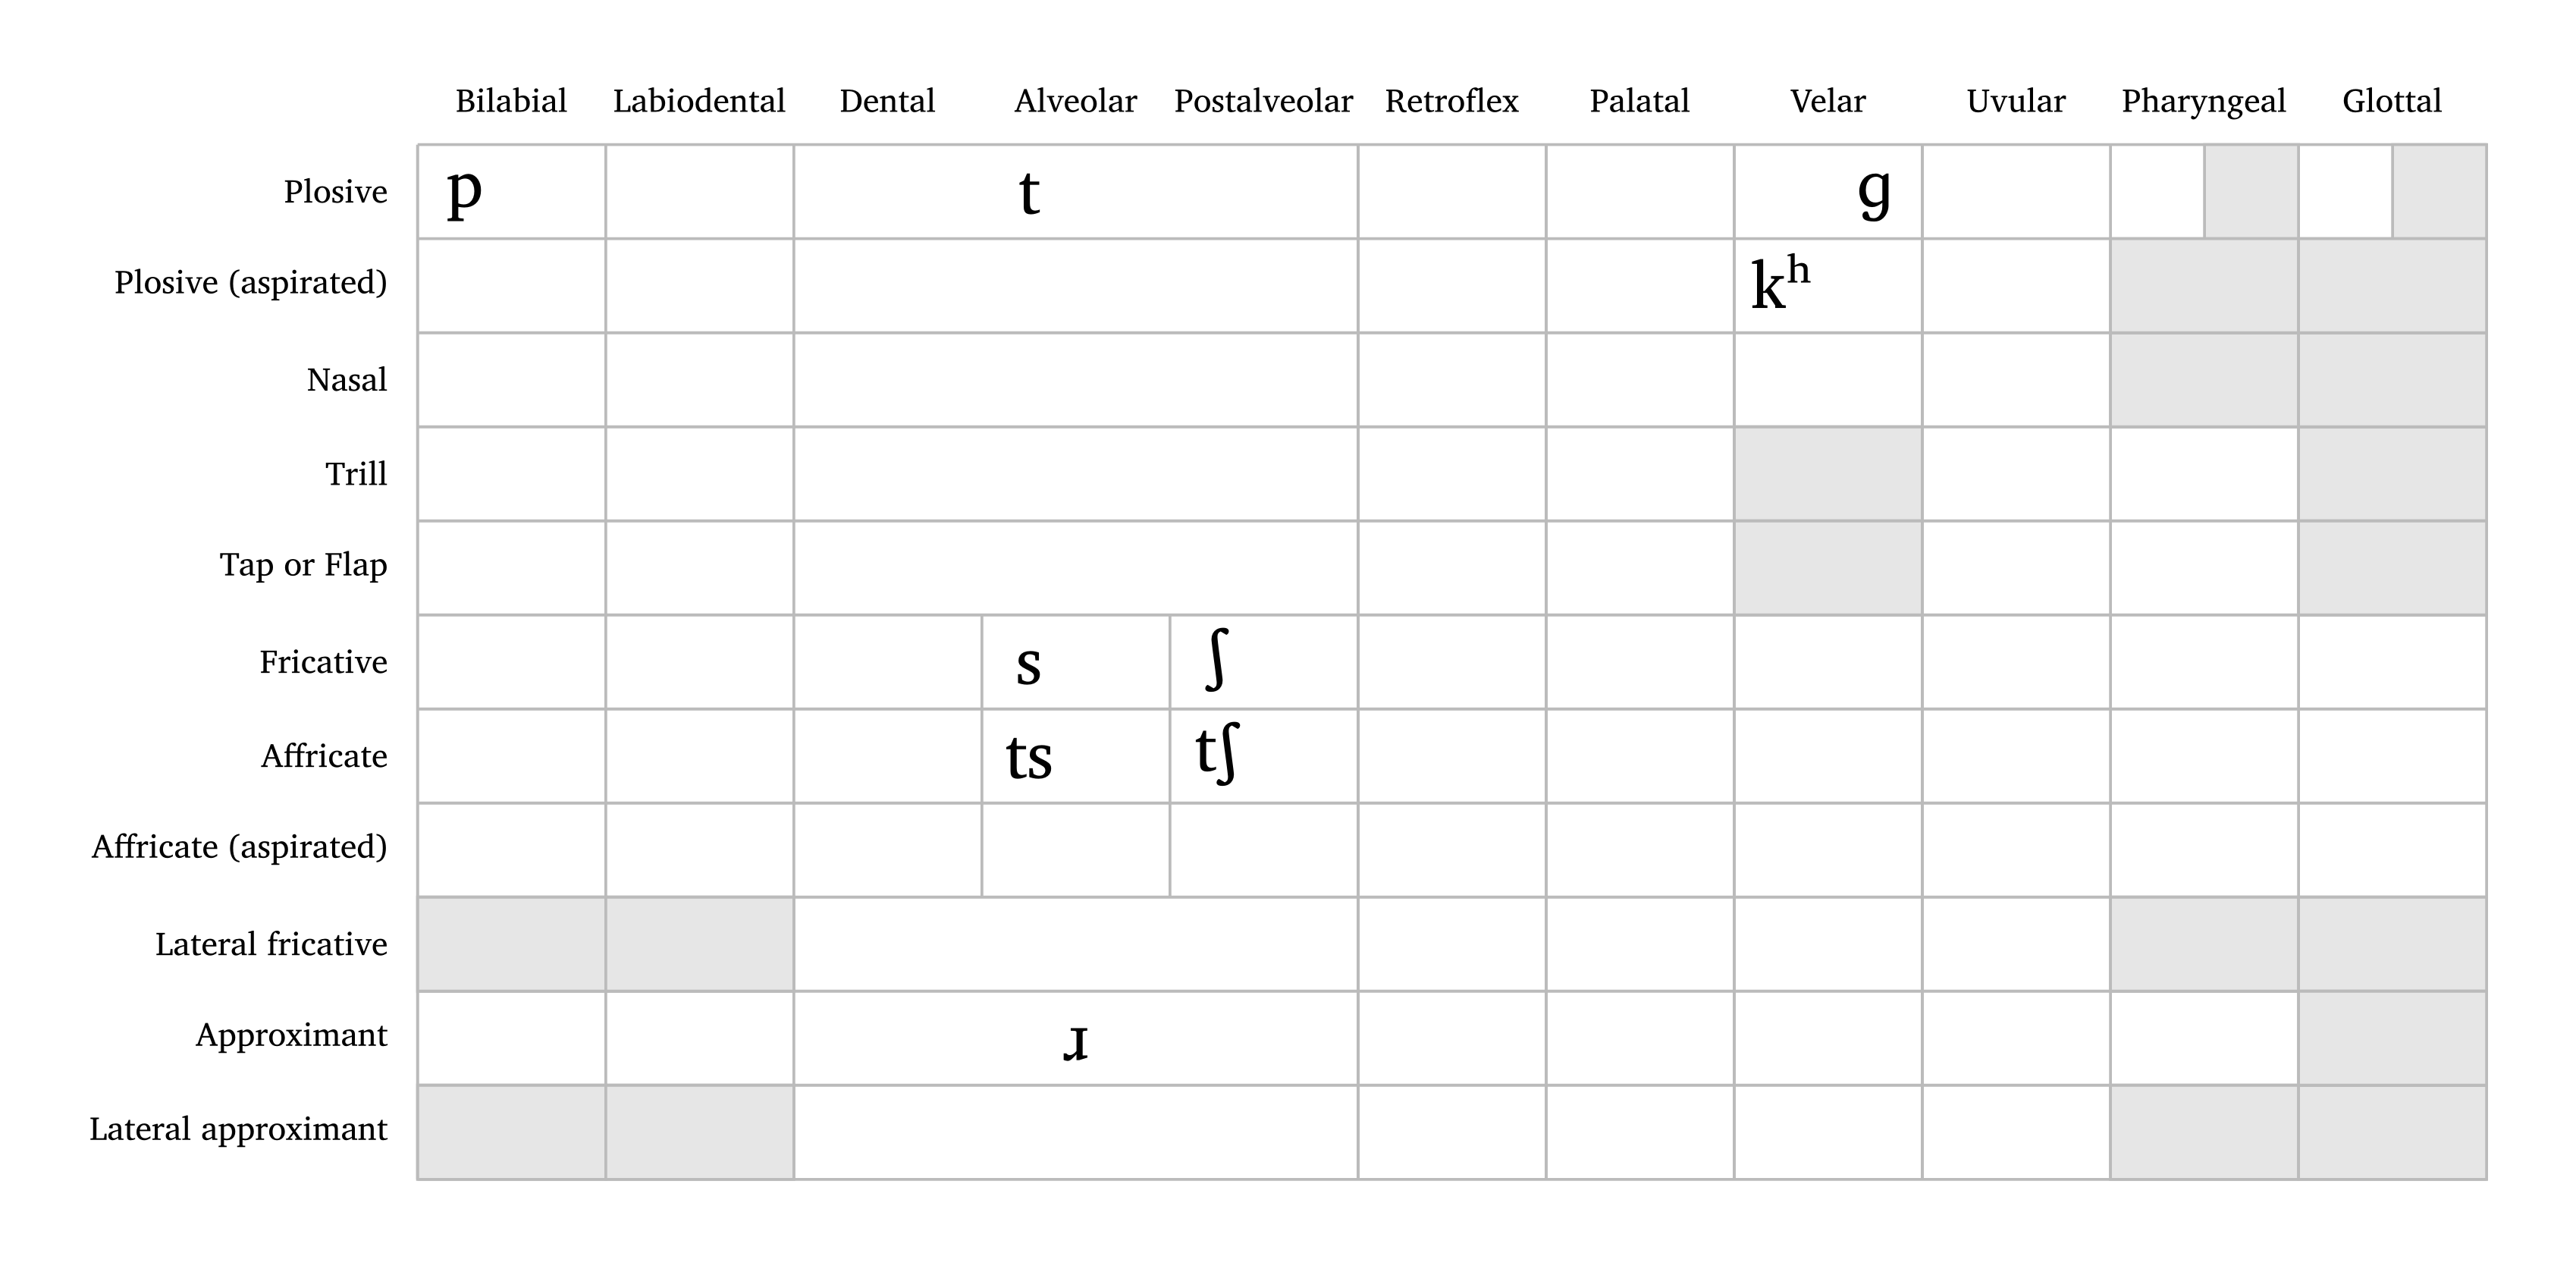
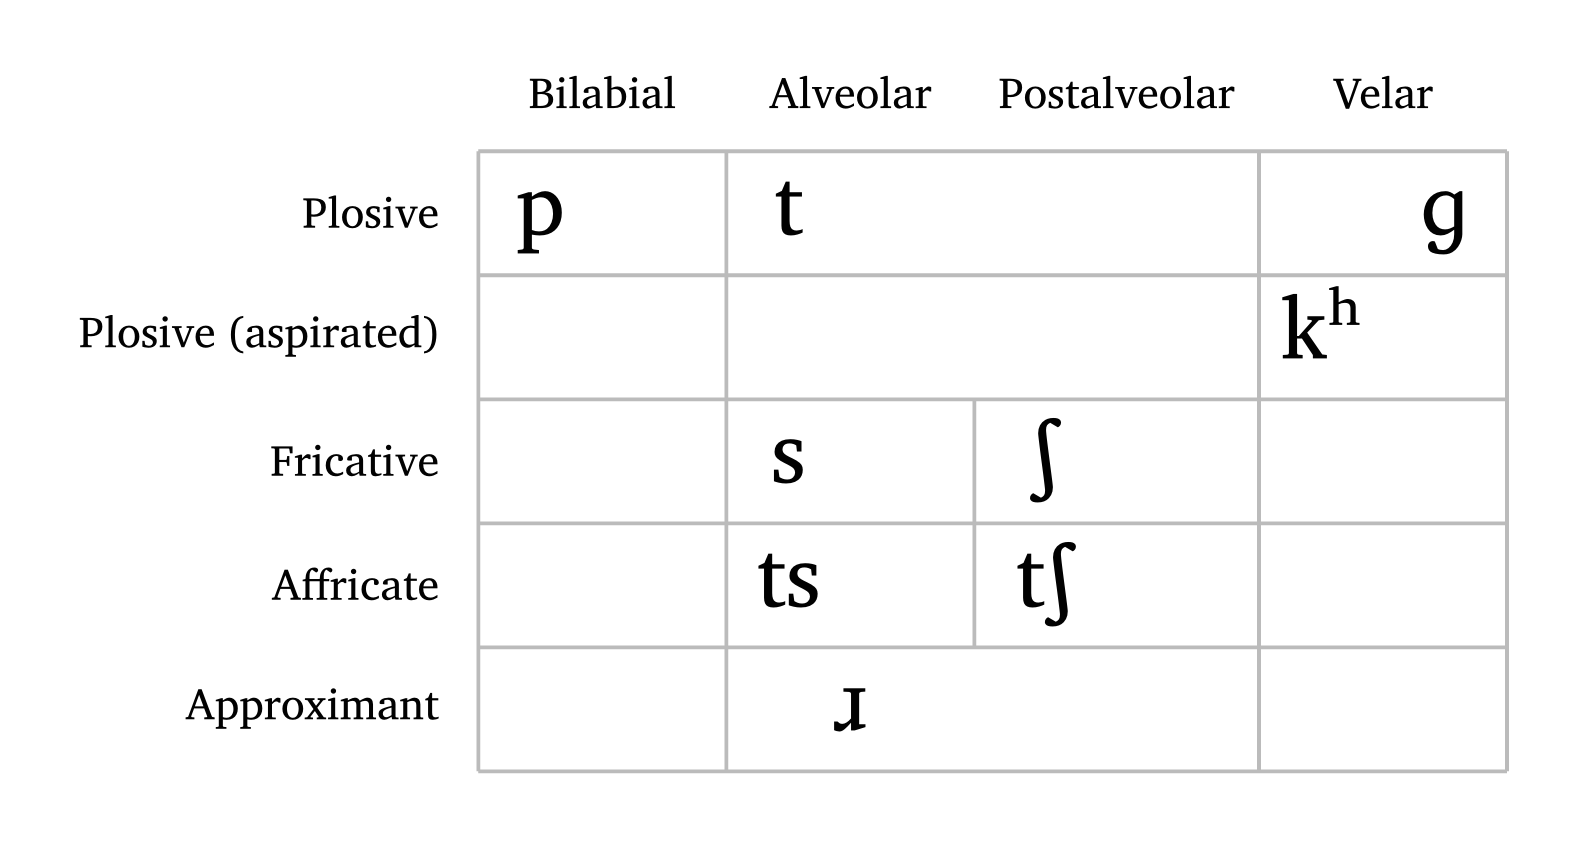
Les tableaux complets peuvent être assez clairsemés, surtout pour les petits inventaires. Avec simplify: true, les lignes et colonnes vides sont supprimées, ce qui donne un tableau plus compact. Pour un contrôle plus fin, delete-rows et delete-cols suppriment des lignes ou des colonnes précises selon leur position (à partir de 0). Figure 4 et Figure 5 reprennent les deux tableaux ci-dessus avec cette option.
Tableaux de consonnes simplifiés
#consonants("italian", affricates: true, abbreviate: true, simplify: true)
#consonants("ts{ts}psS \\*r g{tS} {k \\h}", affricates: true, aspirated: true, simplify: true)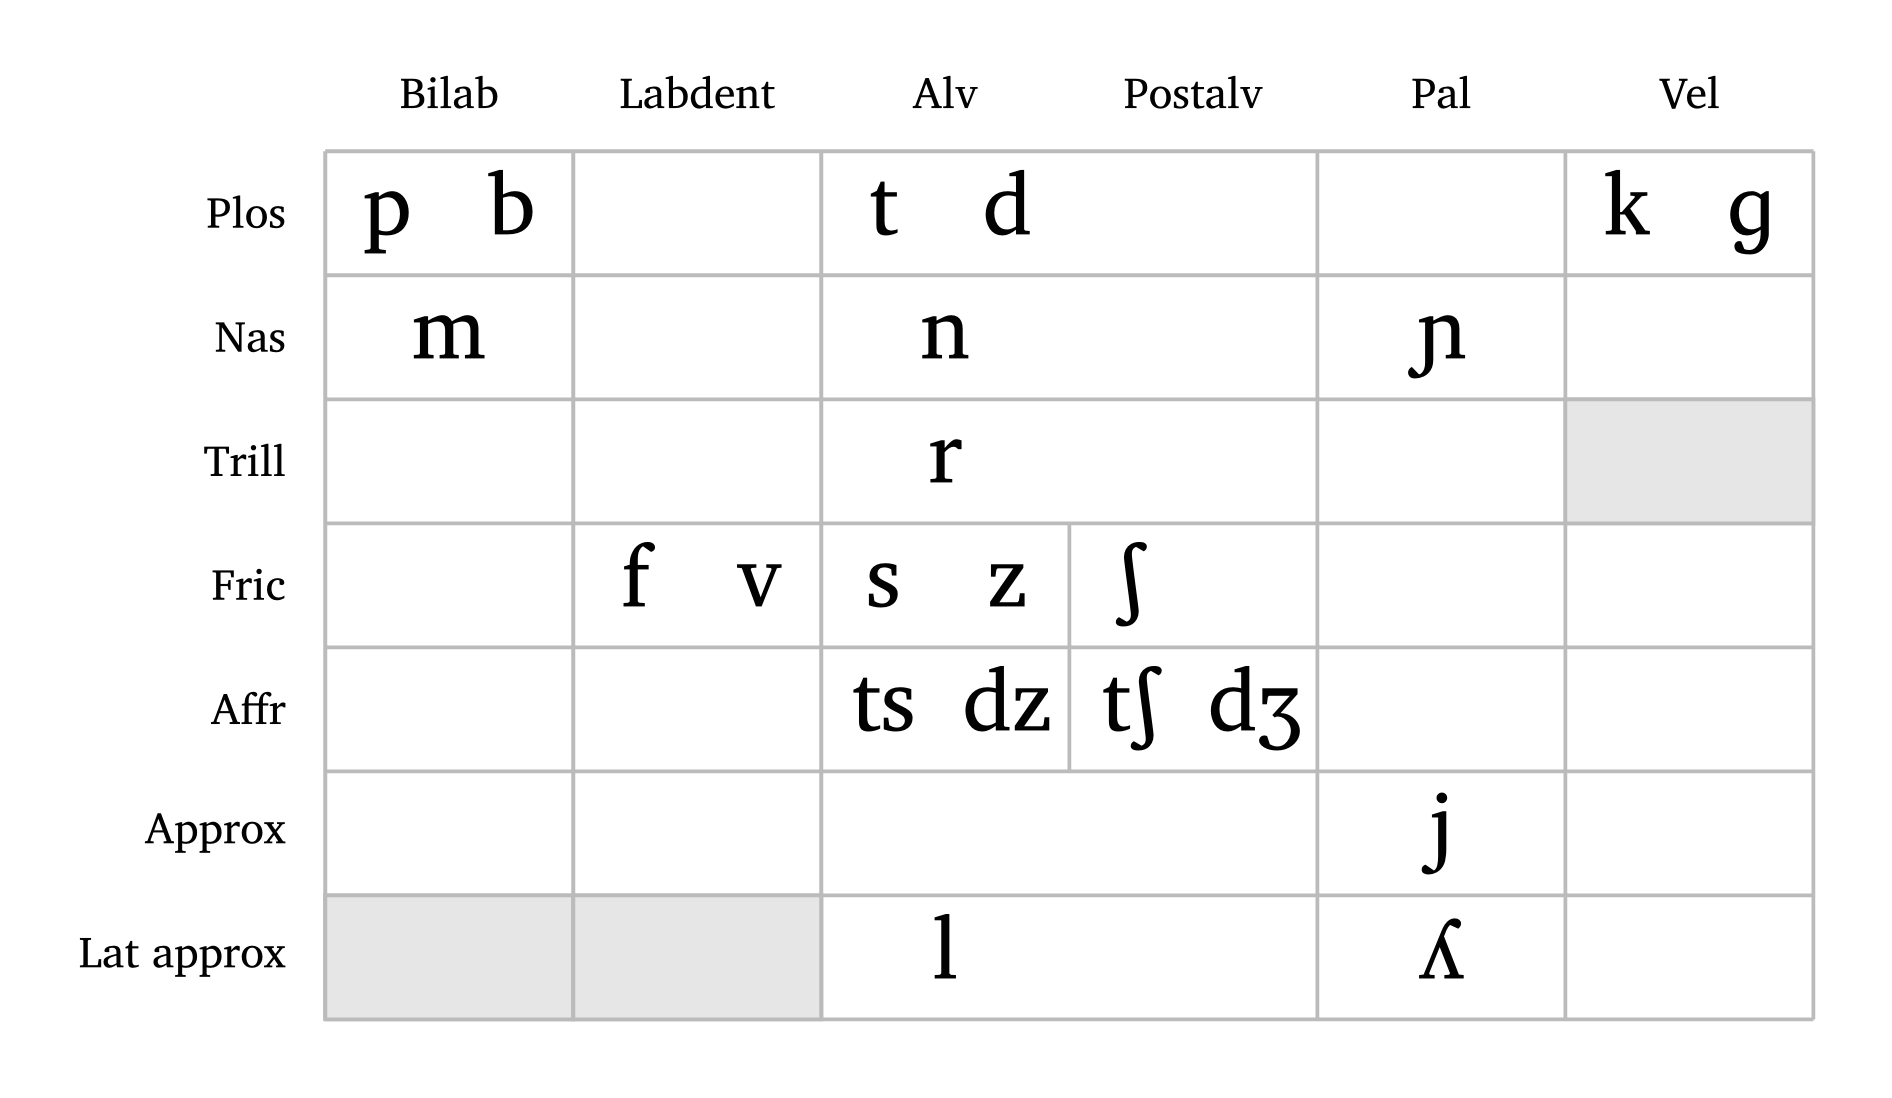
2.3 Voyelles
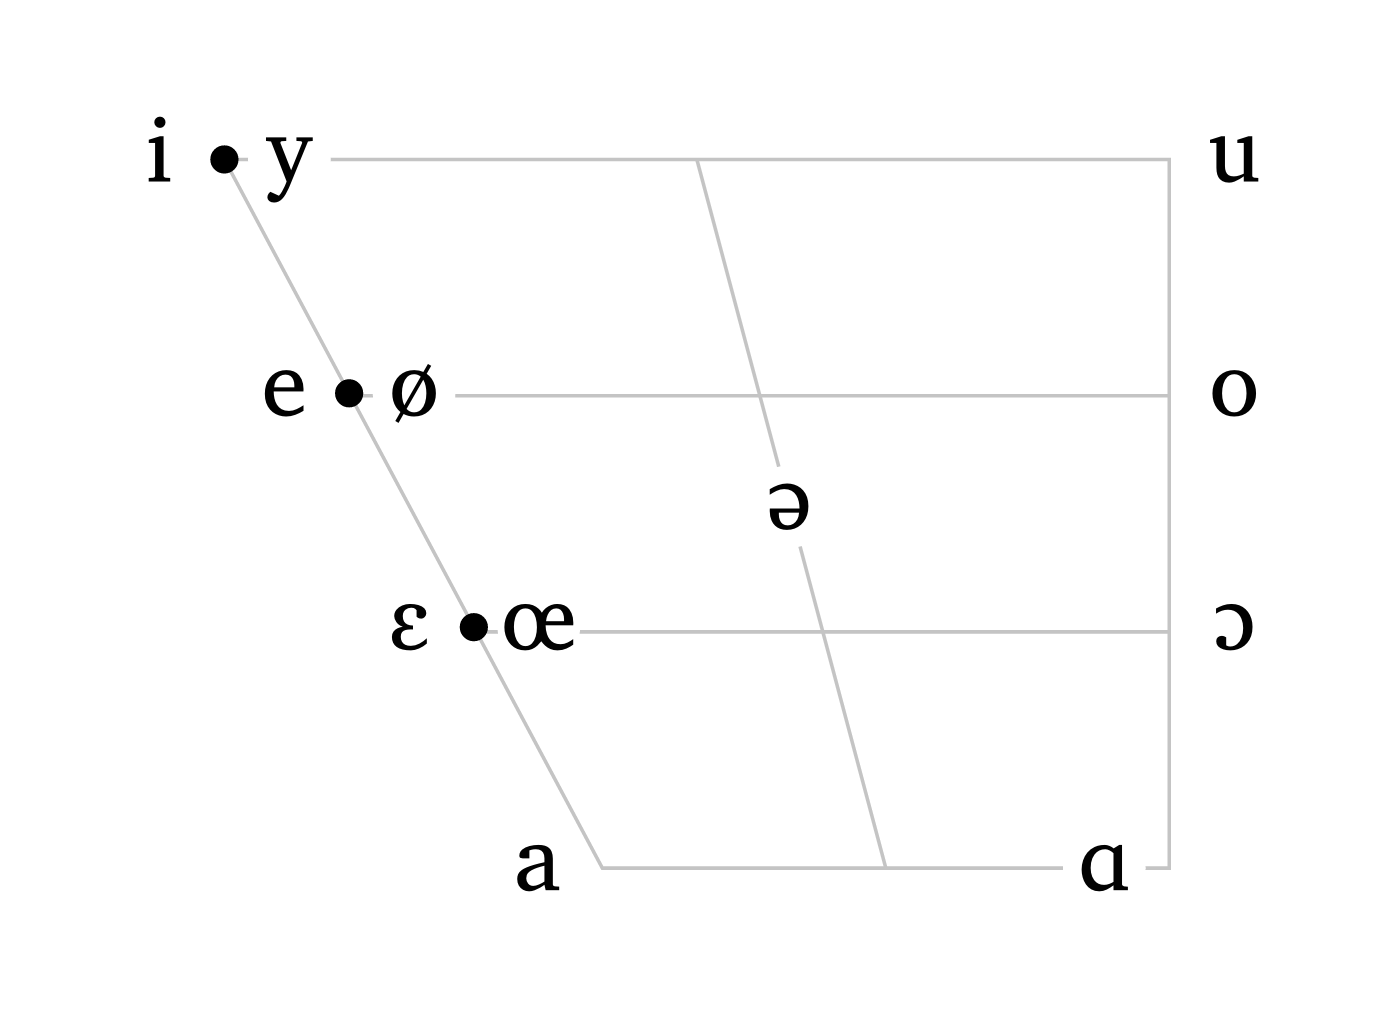
La fonction #vowels() accepte également une langue prédéfinie ou une chaîne de caractères comme entrée. L’argument scale est également disponible ici, permettant à l’utilisateur d’ajuster la taille du trapèze selon les besoins. #vowels() et #consonants() vérifient d’abord les noms de langues prédéfinies ; pour rendre l’intention explicite, utilisez lang: (p. ex., #vowels(lang: "english")). Un nom de langue inconnu ou un symbole non pris en charge affiche un message d’erreur qui liste les langues disponibles, au lieu d’un graphique. Avec nasals: true, le trapèze affiche aussi les voyelles nasales, légèrement décalées par rapport aux voyelles orales correspondantes. Parmi les langues prédéfinies, seul le français en a ; dans une chaîne personnalisée, seules les voyelles nasalisées dans l’entrée sont ajoutées, comme dans #vowels("aãioõu", nasals: true). Comme avec #consonants(), les symboles peuvent être colorés avec phoneme-colors.
Trapèzes vocaliques
#vowels("english", scale: 0.6)
#vowels("french", scale: 0.6)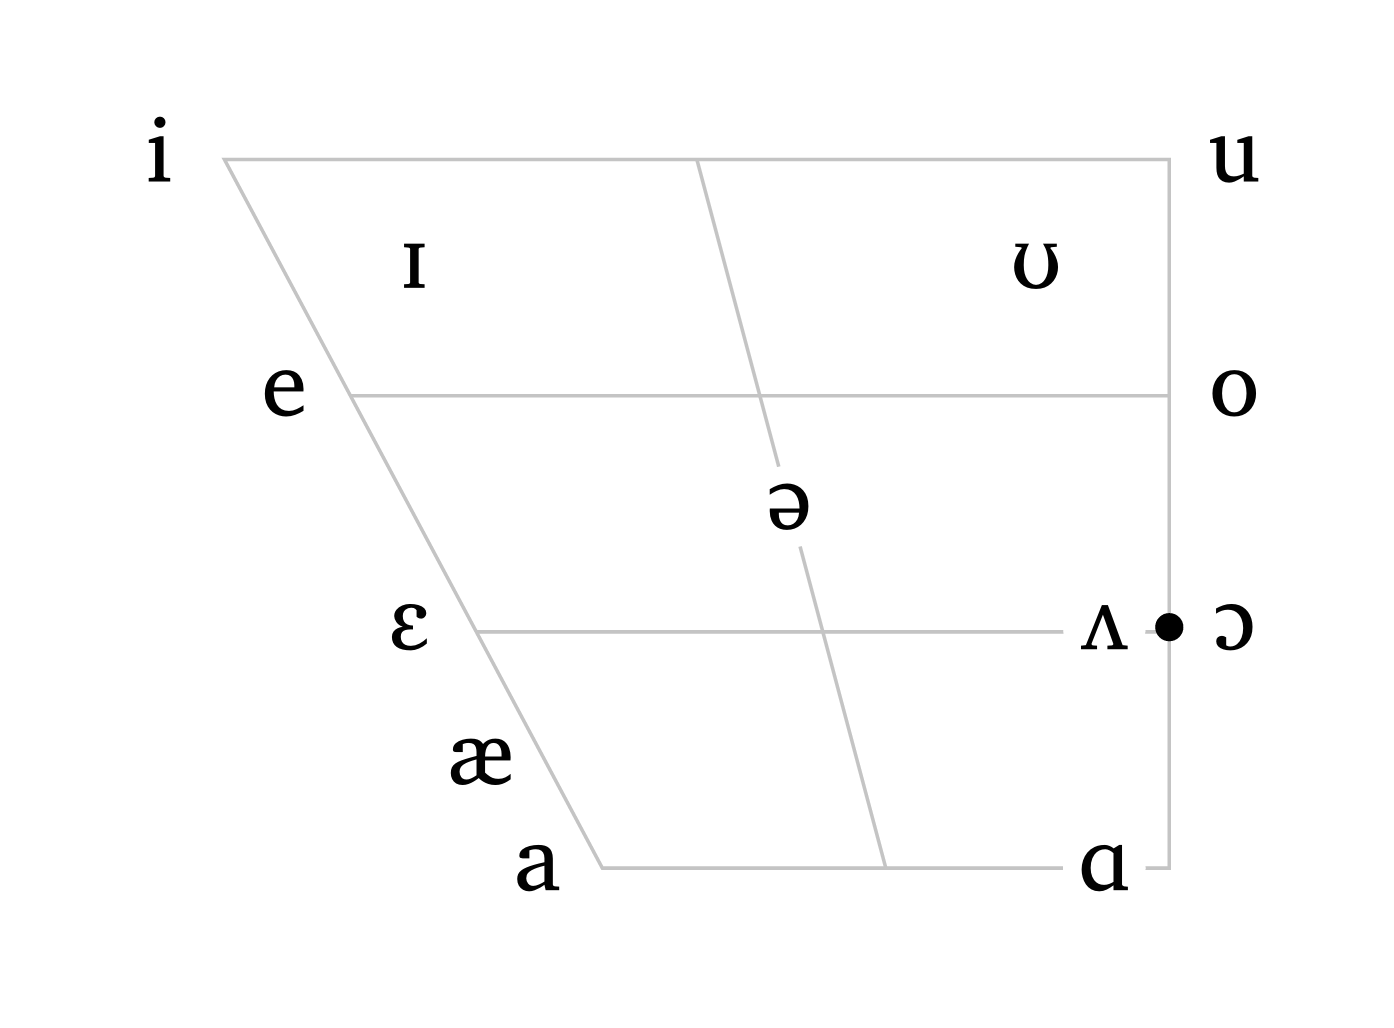
Depuis la version 0.4.5, la fonction #vowels() accepte des arguments optionnels supplémentaires pour inclure des flèches, des voyelles décalées et des surlignages. Figure 8 illustre comment arrows et highlight peuvent être utilisés pour afficher les diphtongues en anglais nord-américain. Les flèches peuvent être courbées (curved: true) ou en pointillés (arrow-style: "dashed"), et les couleurs peuvent être ajustées avec arrow-color et highlight-color. Les voyelles surlignées reposent sur un cercle de couleur, dont la taille se règle avec circle-size (par défaut : 1).
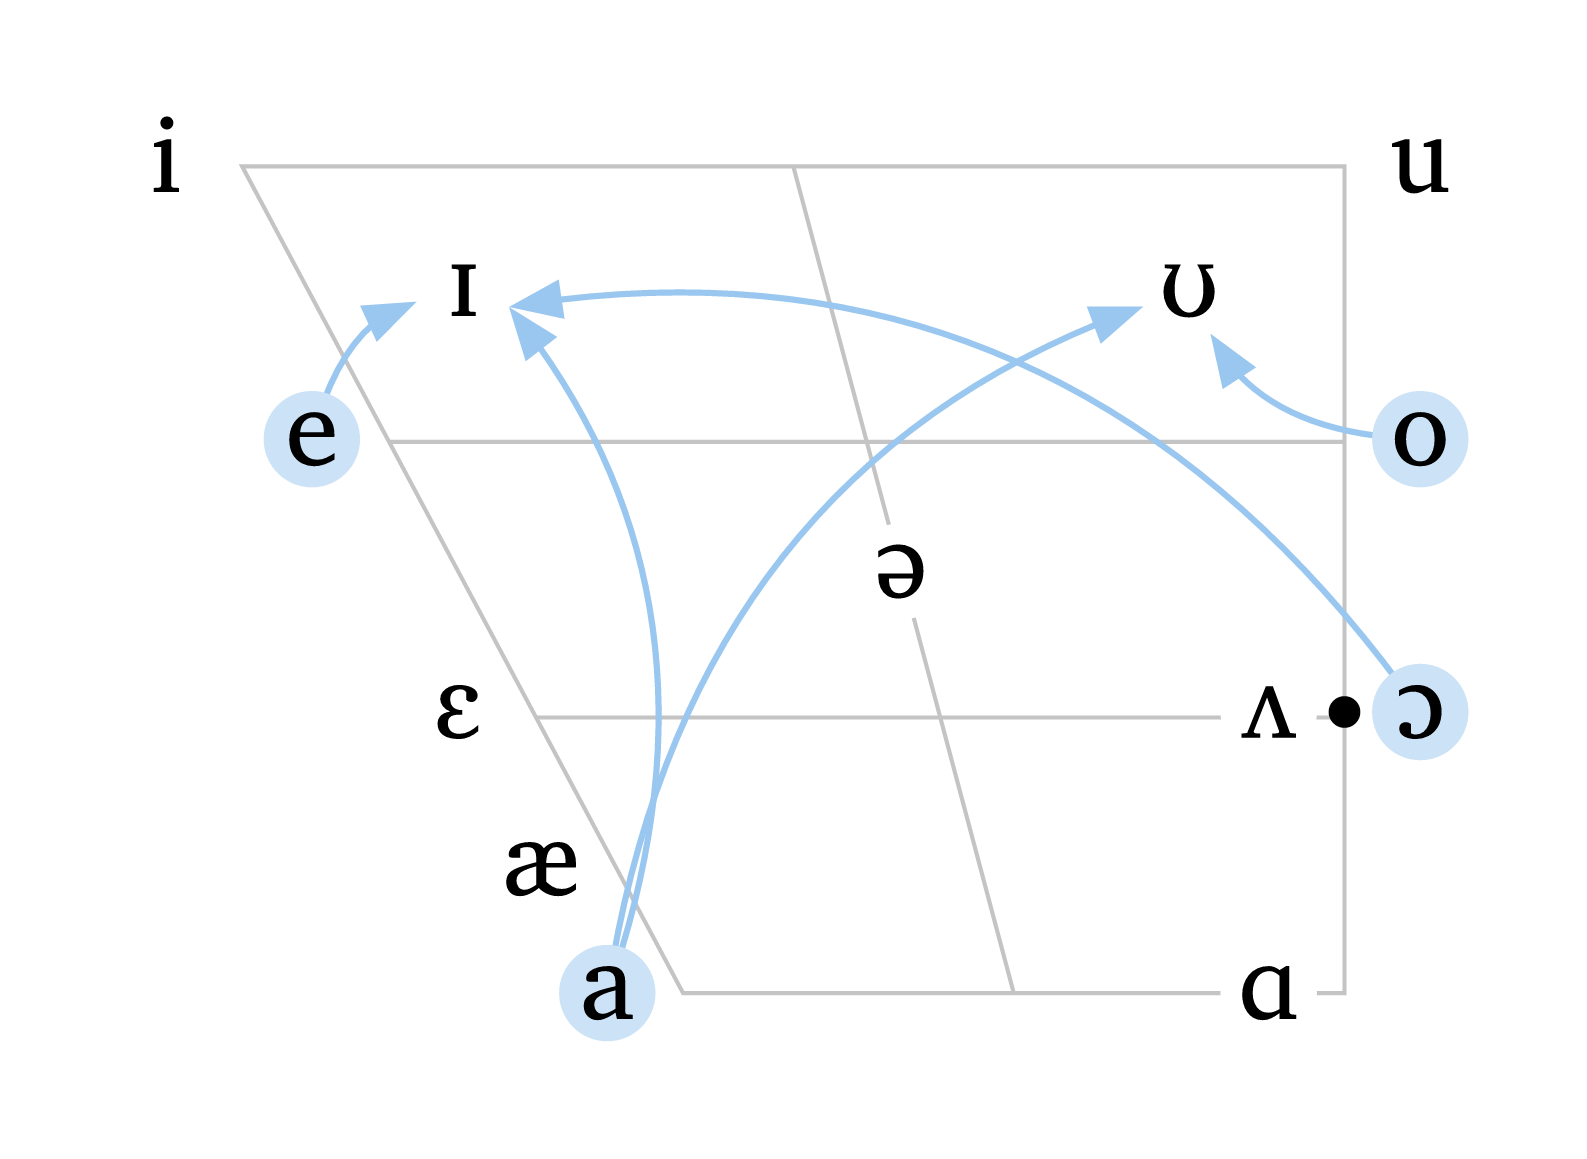
Voyelles avec flèches et surlignages
#vowels(
   "english",
   arrows: (
     ("a", "U"),
     ("a", "I"),
     ("e", "I"),
     ("O", "I"),
     ("o", "U"),
   ),
   arrow-color: blue.lighten(60%),
   curved: true,
   highlight: ("a", "e", "o", "O"),
   highlight-color: blue.lighten(80%),
)
L’argument shift permet de spécifier une voyelle et un décalage depuis sa position d’origine, offrant une bien plus grande flexibilité pour illustrer la variation dialectale. Les voyelles décalées peuvent être ciblées indépendamment par highlight, et les flèches peuvent cibler des voyelles décalées en utilisant les mêmes valeurs de décalage. La couleur et la taille des voyelles décalées peuvent être ajustées avec shift-color et shift-size. Figure 9 illustre les flèches, les voyelles décalées, et l’option de supprimer les lignes de grille (rows: 0 et cols: 0).
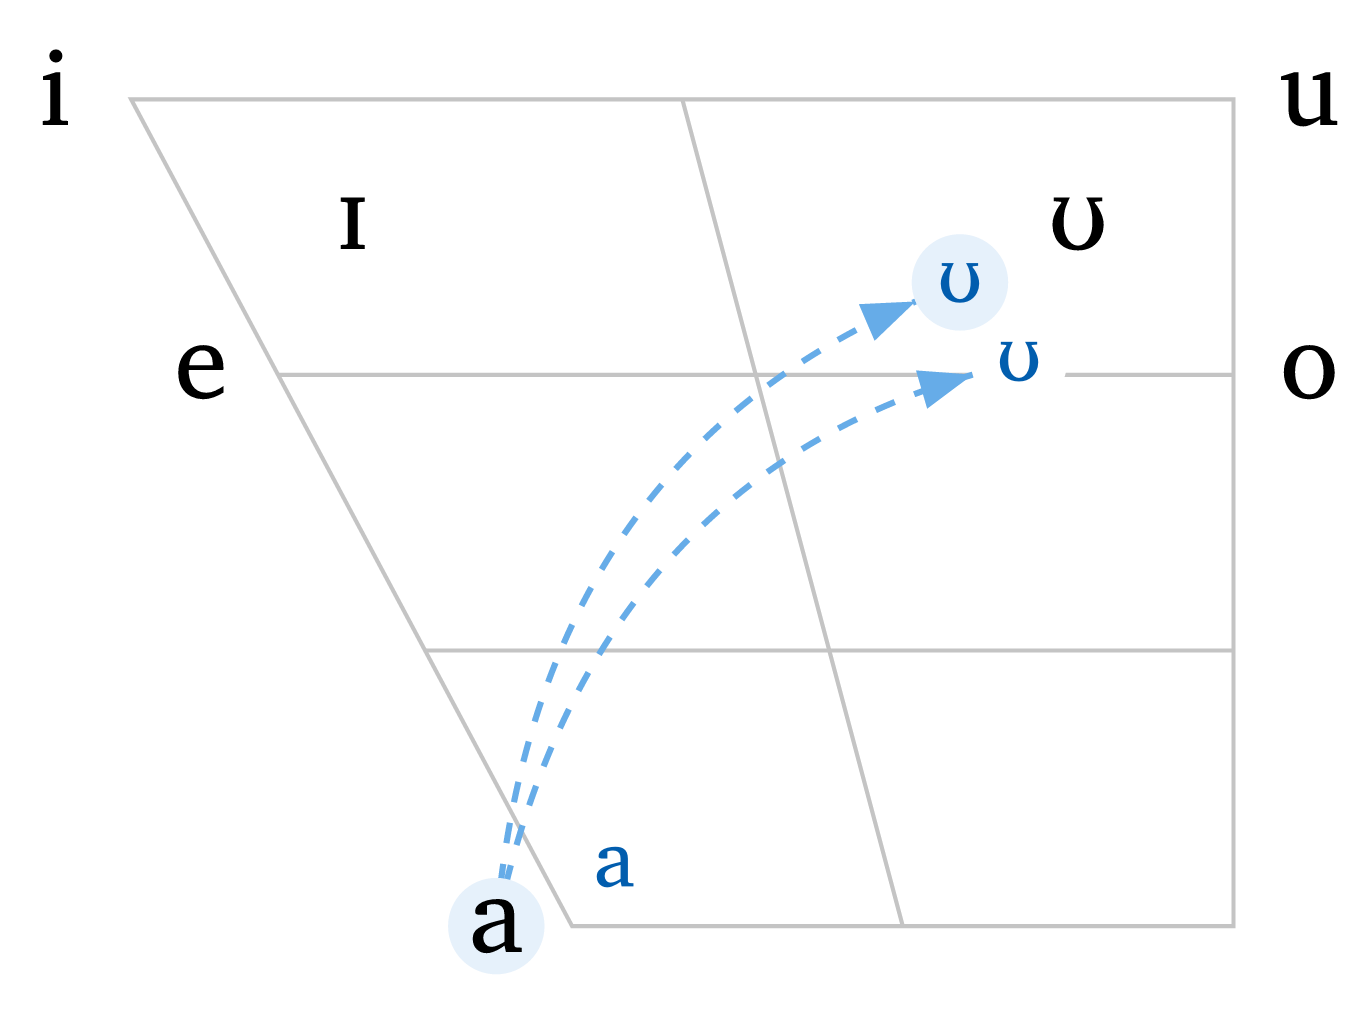
Voyelles avec décalage
#vowels(
    "aeiouIU",
    arrows: (
      ("a", ("U", -0.6, -0.3)),
      ("a", ("U", -0.3, -0.7)),
    ),
    arrow-color: blue.lighten(40%),
    arrow-style: "dashed",
    curved: true,
    shift: (
      ("a", 0.6, 0.3),
      ("U", -0.6, -0.3),
      ("U", -0.3, -0.7),
    ),
    shift-size: 1.5em,
    shift-color: blue.darken(20%),
    highlight: ("a", ("U", -0.6, -0.3)),
    highlight-color: blue.lighten(90%),
    rows: 0,  // no grid lines
    cols: 0,
  )
2.4 Espace vocalique en 3D
Depuis la version 0.6.0, la fonction #vowels-3d() ajoute une troisième dimension au trapèze : l’arrondissement. Inspiré de l’espace vocalique de Ladefoged et Maddieson (1996, 283), le trapèze devient un prisme dont la face avant est non arrondie et la face arrière, arrondie. Les voyelles antérieures se trouvent d’un côté du prisme et les voyelles postérieures de l’autre, à une profondeur qui reflète leur degré d’arrondissement : /i/ est la voyelle la moins arrondie et /u/ la plus arrondie, tandis que les voyelles basses /a/ et /ɒ/ se rejoignent à mi-chemin. Le schwa se trouve à l’intérieur du prisme.
Par défaut, la fonction affiche neuf voyelles (/i e ɛ a u o ɔ ɒ ə/) ; #vowels-3d() n’a donc besoin d’aucun argument, mais on peut aussi fournir un sous-ensemble en notation tipa, comme dans #vowels-3d("ieau"). La vue est définie par rotation (autour de l’axe vertical) et tilt (vue d’en haut ou d’en bas), qui acceptent des angles ou de simples nombres de degrés. Les arêtes cachées sont en pointillés, et les voyelles plus éloignées sont plus petites (depth-cue: false désactive cet effet). Comme la rotation n’est qu’un argument, il suffit de générer une image par angle pour obtenir l’animation de la Figure 10.
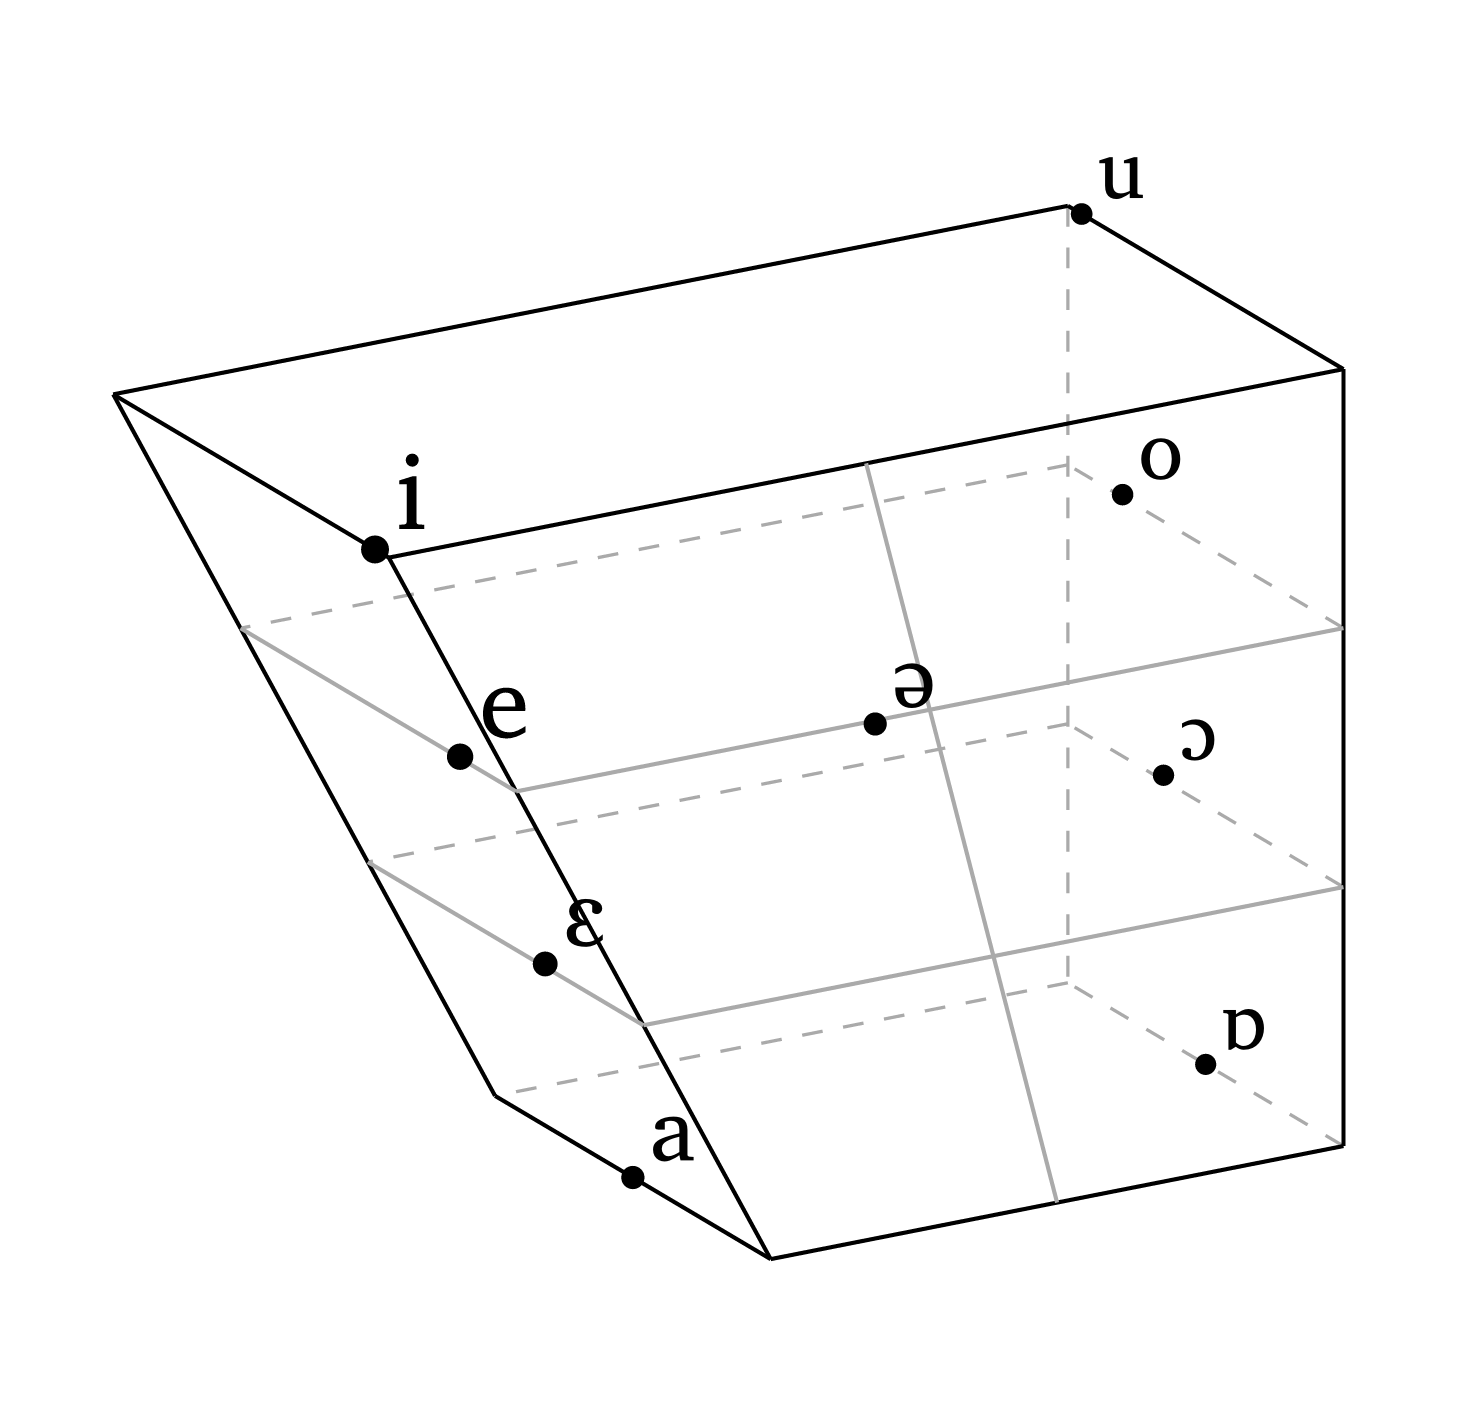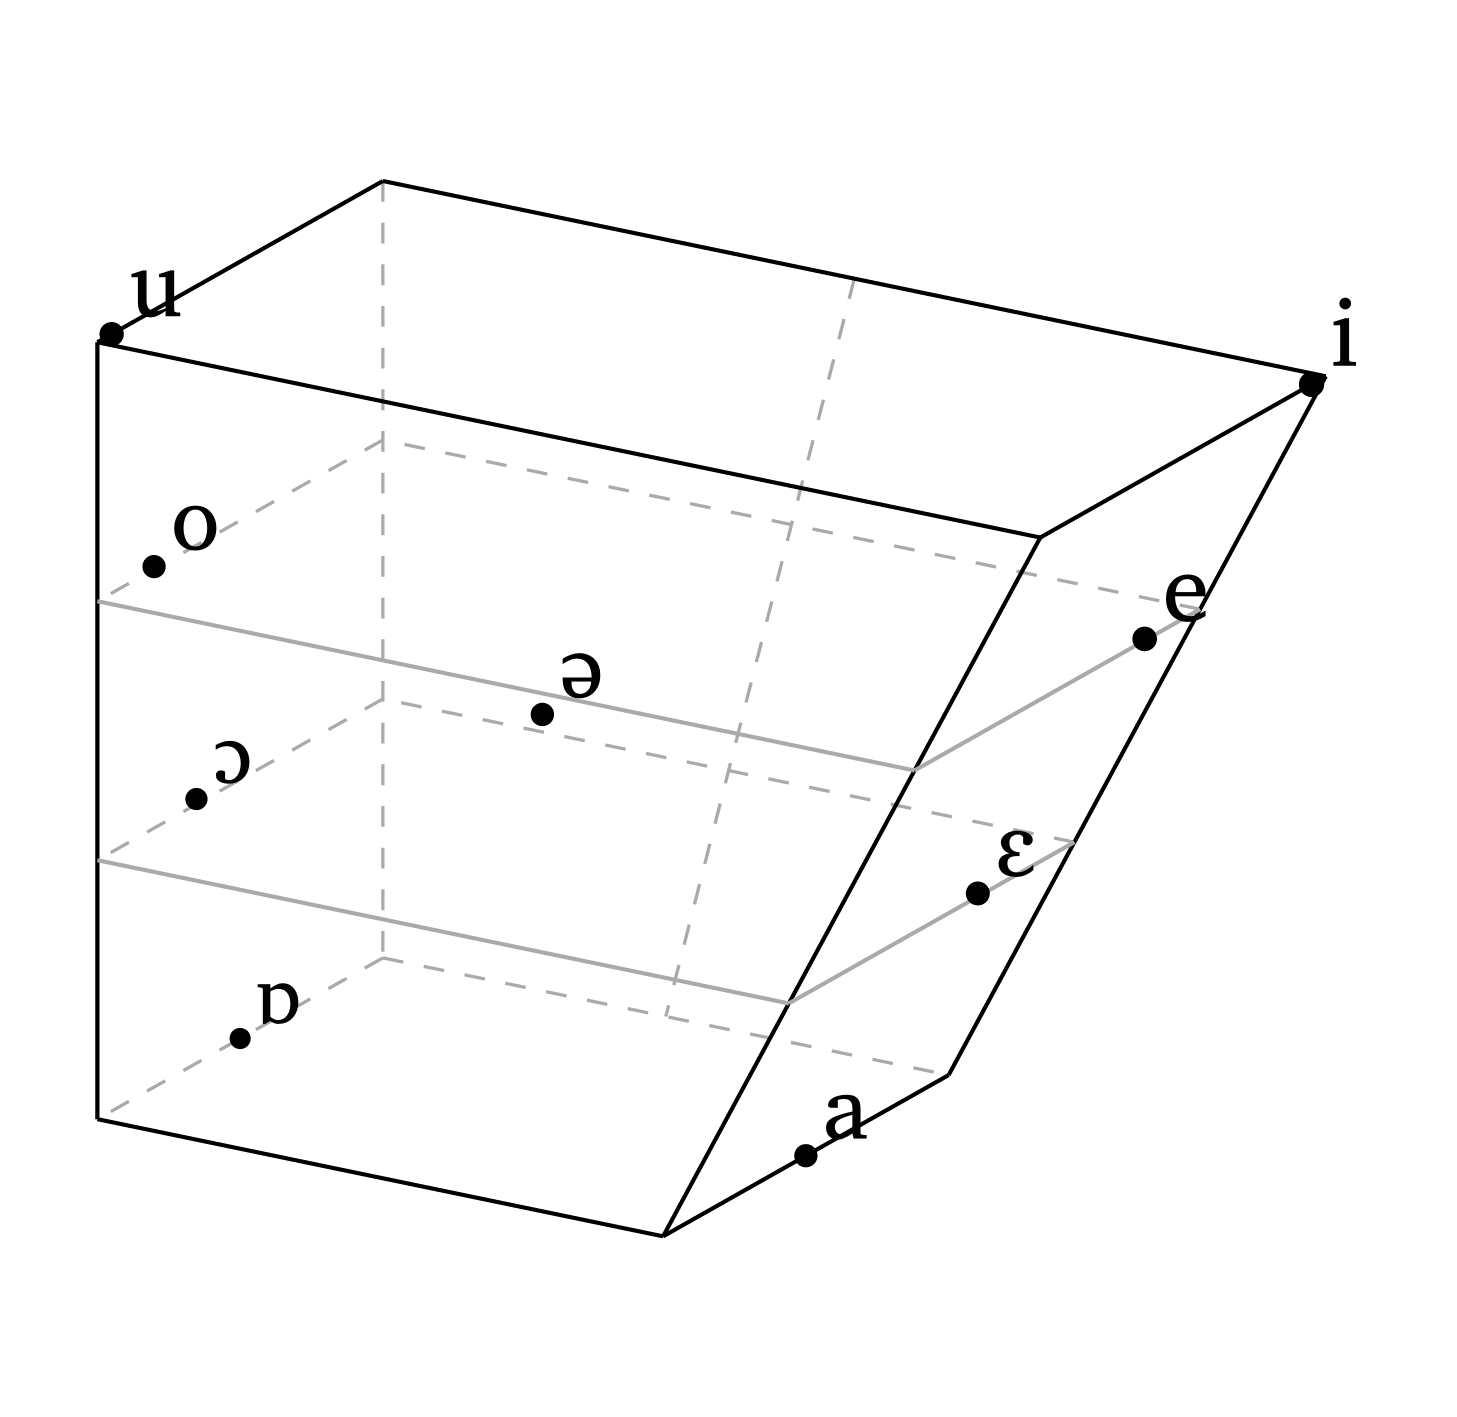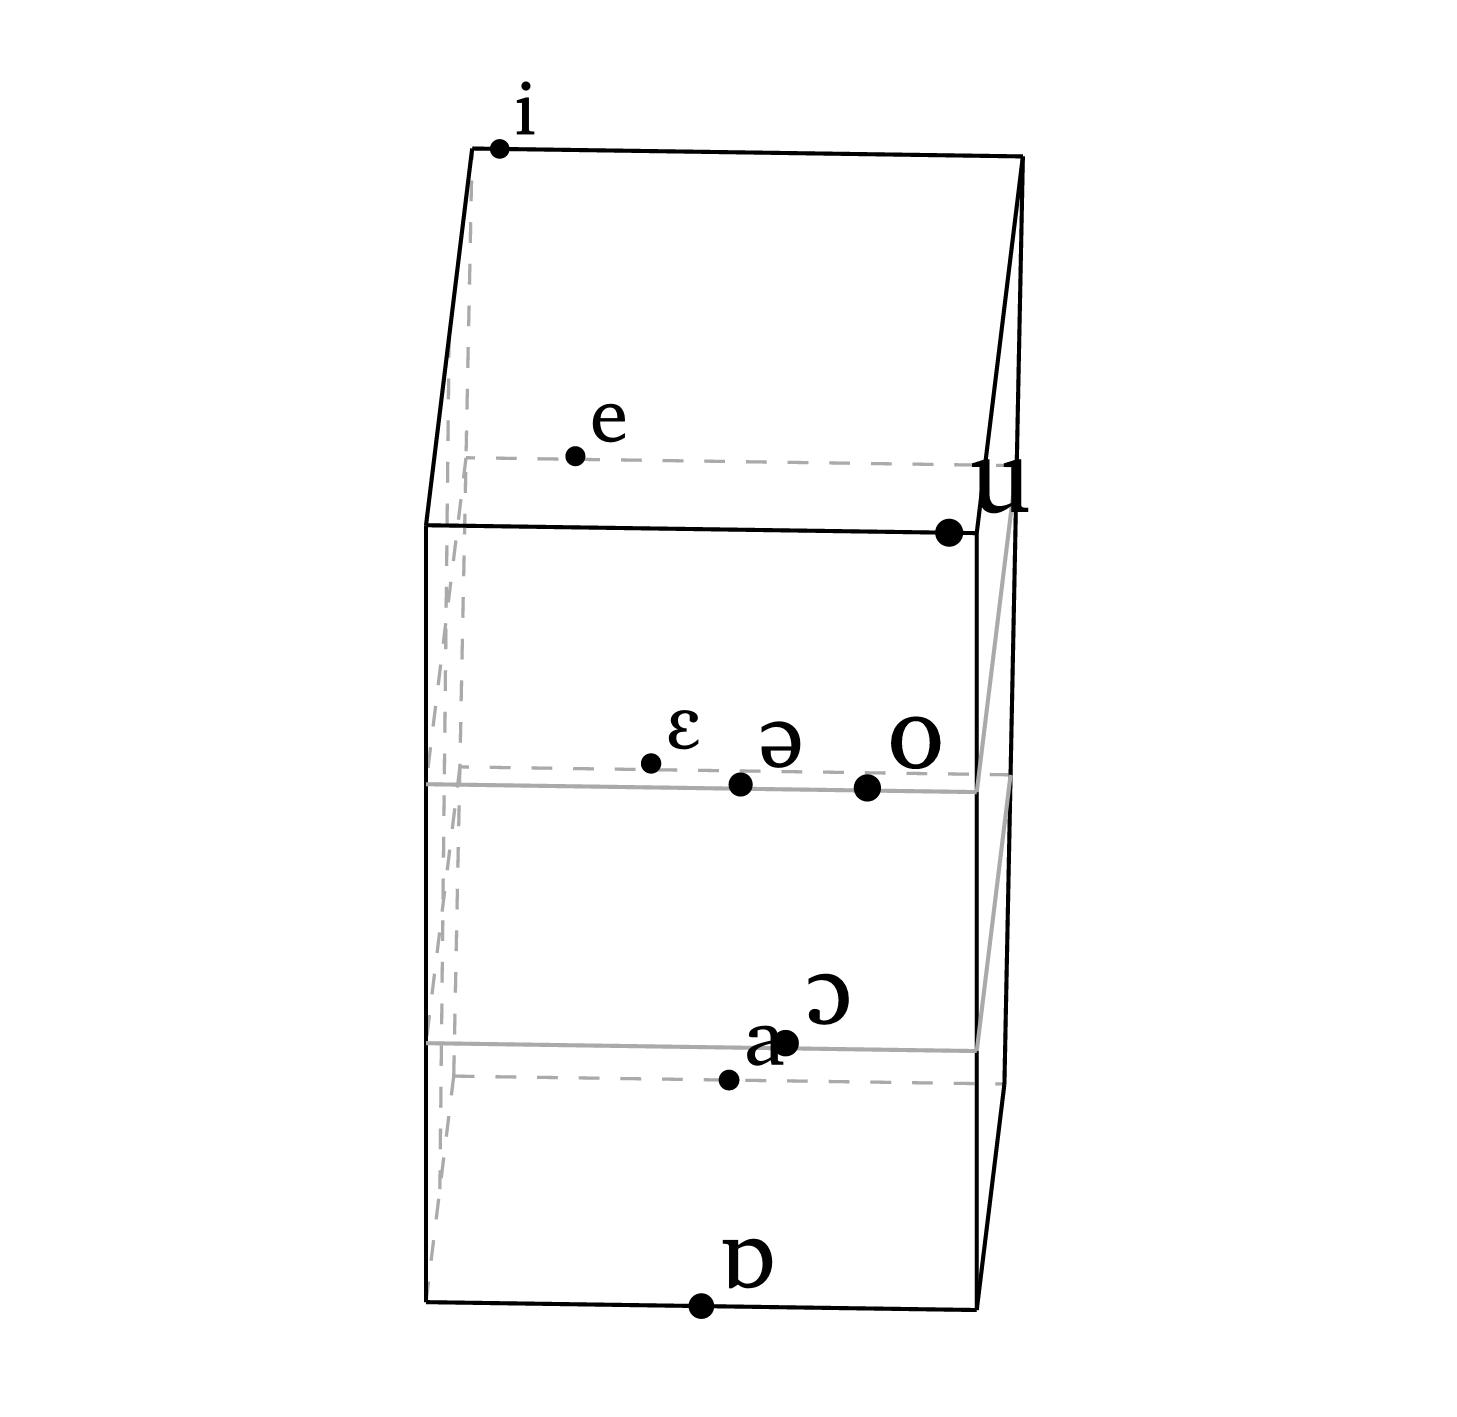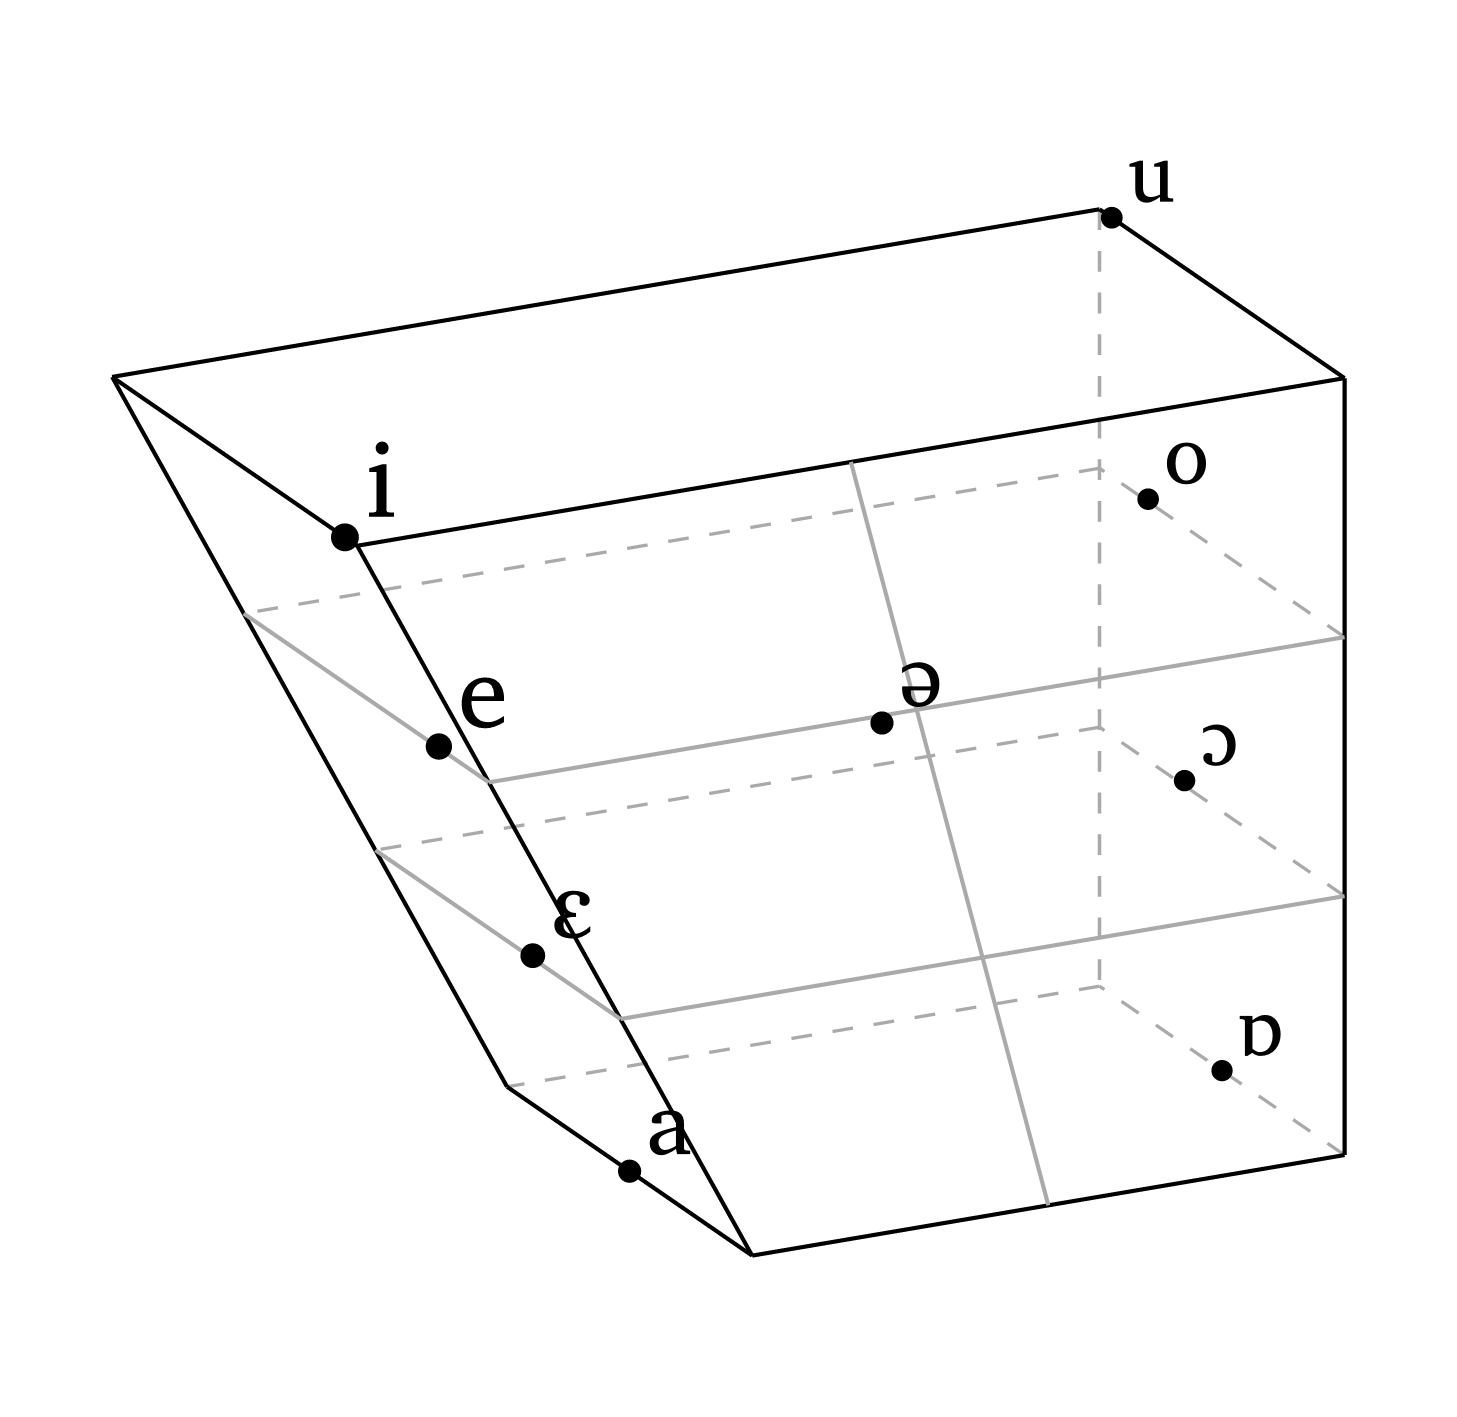
#vowels-3d(), une image tous les 3,6 degrés.
Espace vocalique en 3D
#vowels-3d()                                    // vue par défaut
#vowels-3d("ieau@", rotation: -40, tilt: 35)    // sous-ensemble et vue personnalisés
#vowels-3d(rotation: 0, tilt: 0)                // vue de face, à plat
3 Phonétique
3.1 Changements phonétiques
La fonction #sound-shift() est destinée aux cas où un trapèze vocalique n’est plus le meilleur choix, comme les changements en chaîne, les fusions ou les scissions schématiques, où les symboles doivent être placés librement dans un espace à deux dimensions. Chaque nœud est défini par une étiquette et une position, et les flèches relient les nœuds en faisant directement référence à ces étiquettes. Les flèches peuvent être courbées, les nœuds peuvent être encerclés (highlights), et toute la représentation peut être redimensionnée. Figure 11 montre une représentation schématique du Northern Cities Shift (Labov et al. 2008).
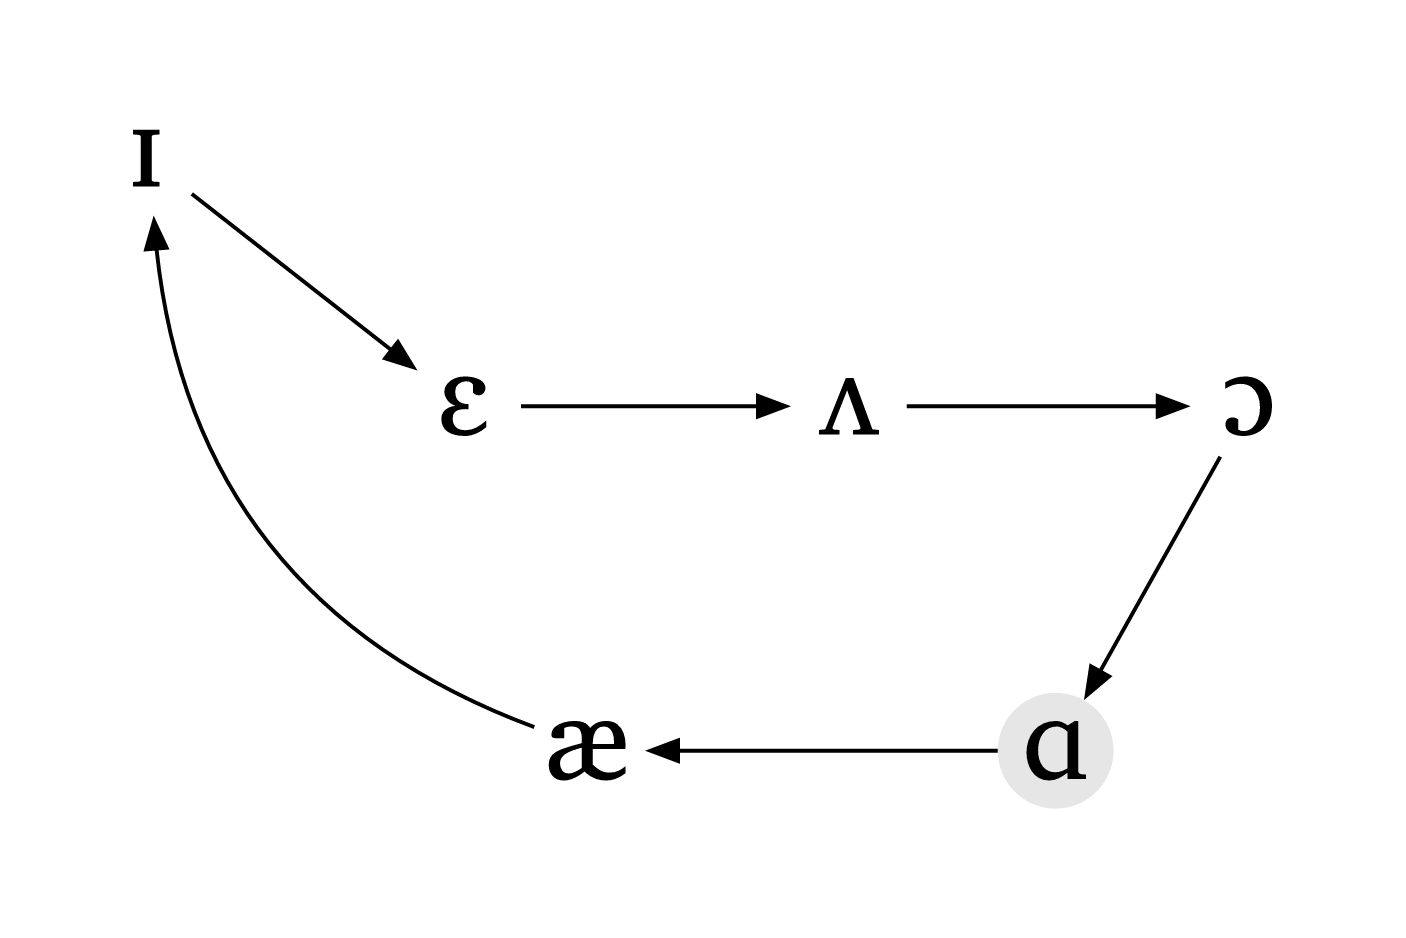
Changement phonétique
#sound-shift(
  nodes: (
    (label: "I", at: (-4.2, 2.8)),
    (label: "E", at: (-1.9, 1.0)),
    (label: "2", at: (0.9, 1.0)),
    (label: "O", at: (3.8, 1.0)),
    (label: "A", at: (2.4, -1.5)),
    (label: "\\ae", at: (-1.0, -1.5)),
  ),
  arrows: (
    ("E", "2"),
    ("2", "O"),
    ("O", "A"),
    ("A", "\\ae"),
    ("I", "E"),
    (from: "\\ae", to: "I", curved: true, curve: 0.28),
  ),
  scale: 0.7,
  highlights: ("A",),
)
3.2 Délai d’établissement du voisement (VOT)
La fonction #vot() crée des chronogrammes schématiques pour illustrer des valeurs de VOT négatives, nulles et positives. Un diagramme minimal ne requiert que la valeur du VOT, comme dans #vot(-70), mais la fonction permet aussi d’afficher les étiquettes en français ou en portugais (ui-lang), d’annoter chaque intervalle avec des segments, et de modifier l’apparence (couleurs de remplissage, ondes de voisement schématiques). Les diagrammes sont des illustrations pédagogiques, et non des tracés de mesures acoustiques.
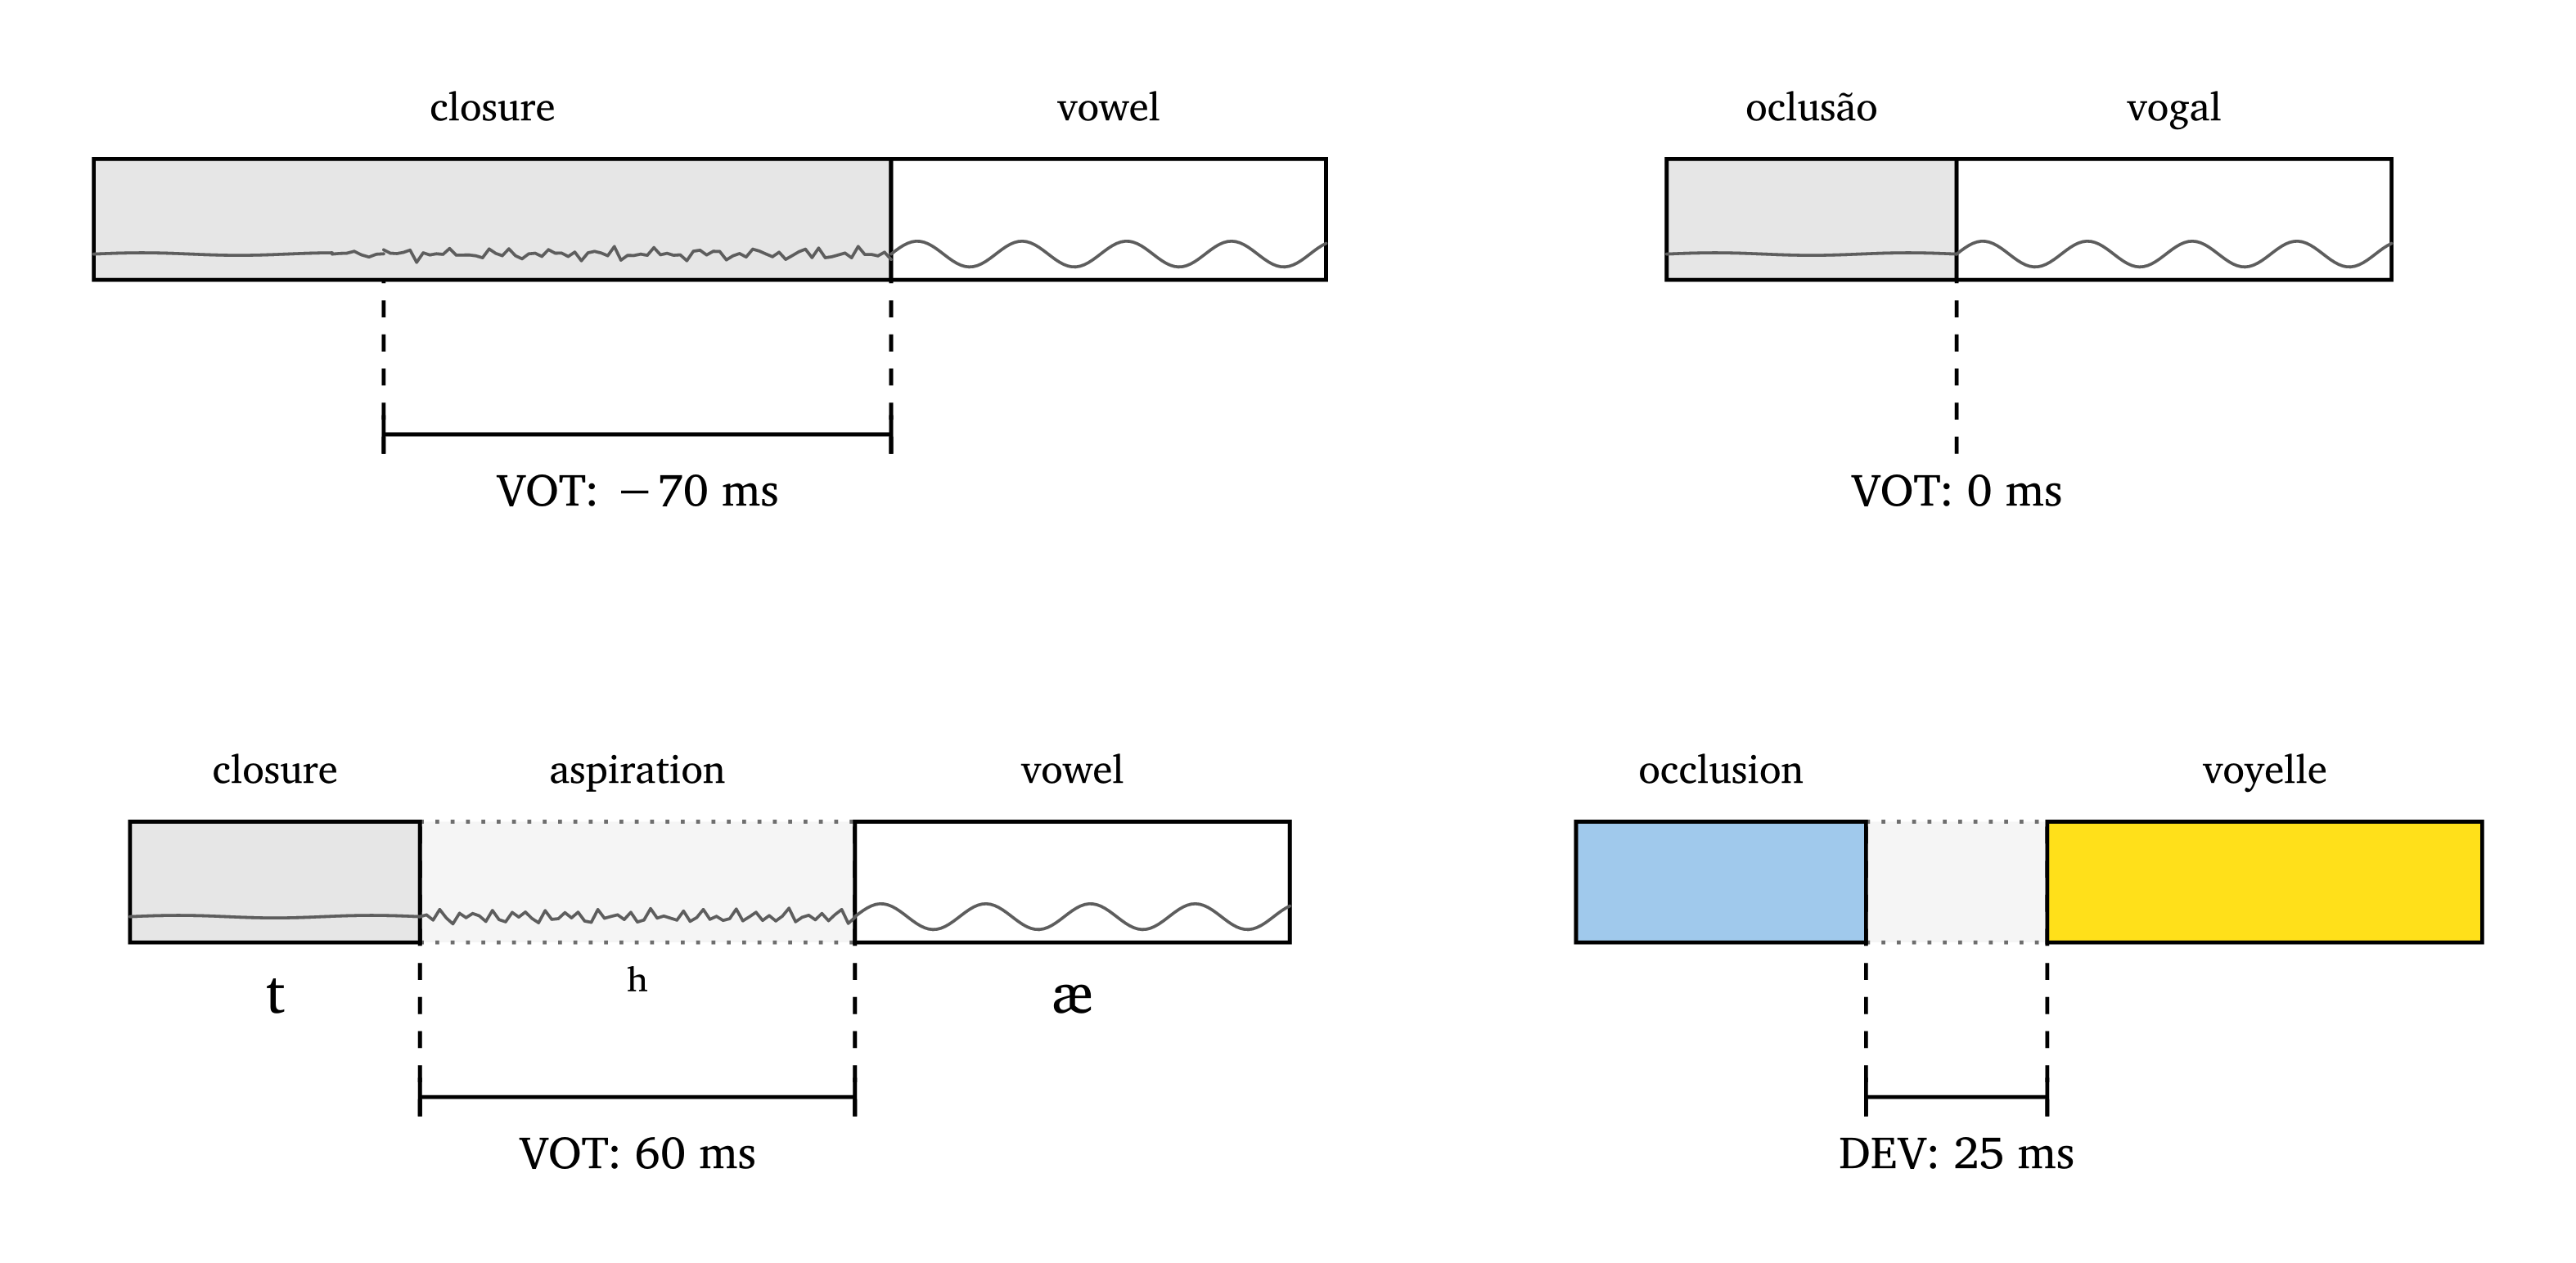
#vot().
Diagrammes de VOT
// minimalist function
#vot(-70)

// support for French and Portuguese labels
#vot(0, ui-lang: "pt")

// annotate diagram using IPA symbols
#vot(60, closure-segment: "t", interval-segment: "\\h", vowel-segment: "\\ae")

// various arguments to customize diagrams
#vot(
  25,
  ui-lang: "fr",
  voicing: false, // optionally hide illustrative waves
  fill-closure: blue.lighten(50%).desaturate(30%),
  fill-vowel: yellow.lighten(10%),
)
3.3 Dispersion vocalique
La fonction #formants() crée un graphique de dispersion vocalique à l’aide de la bibliothèque Lilaq (Mc-Zen 2025). Elle génère des occurrences synthétiques autour des valeurs moyennes de F1 et F2 : sd fixe l’écart-type de F1 (et de F2, sauf si sd2 est fourni), et le nombre d’échantillons est de 10 par voyelle par défaut. Comme avec #vowels(), des langues prédéfinies sont disponibles (Figure 13) ; leurs valeurs sont schématiques et servent uniquement à l’enseignement. Utilisez seed (par défaut : 1) pour reproduire les mêmes positions vocaliques d’une figure à l’autre. Des ellipses, la taille et la couleur des points ainsi que scale sont aussi disponibles.
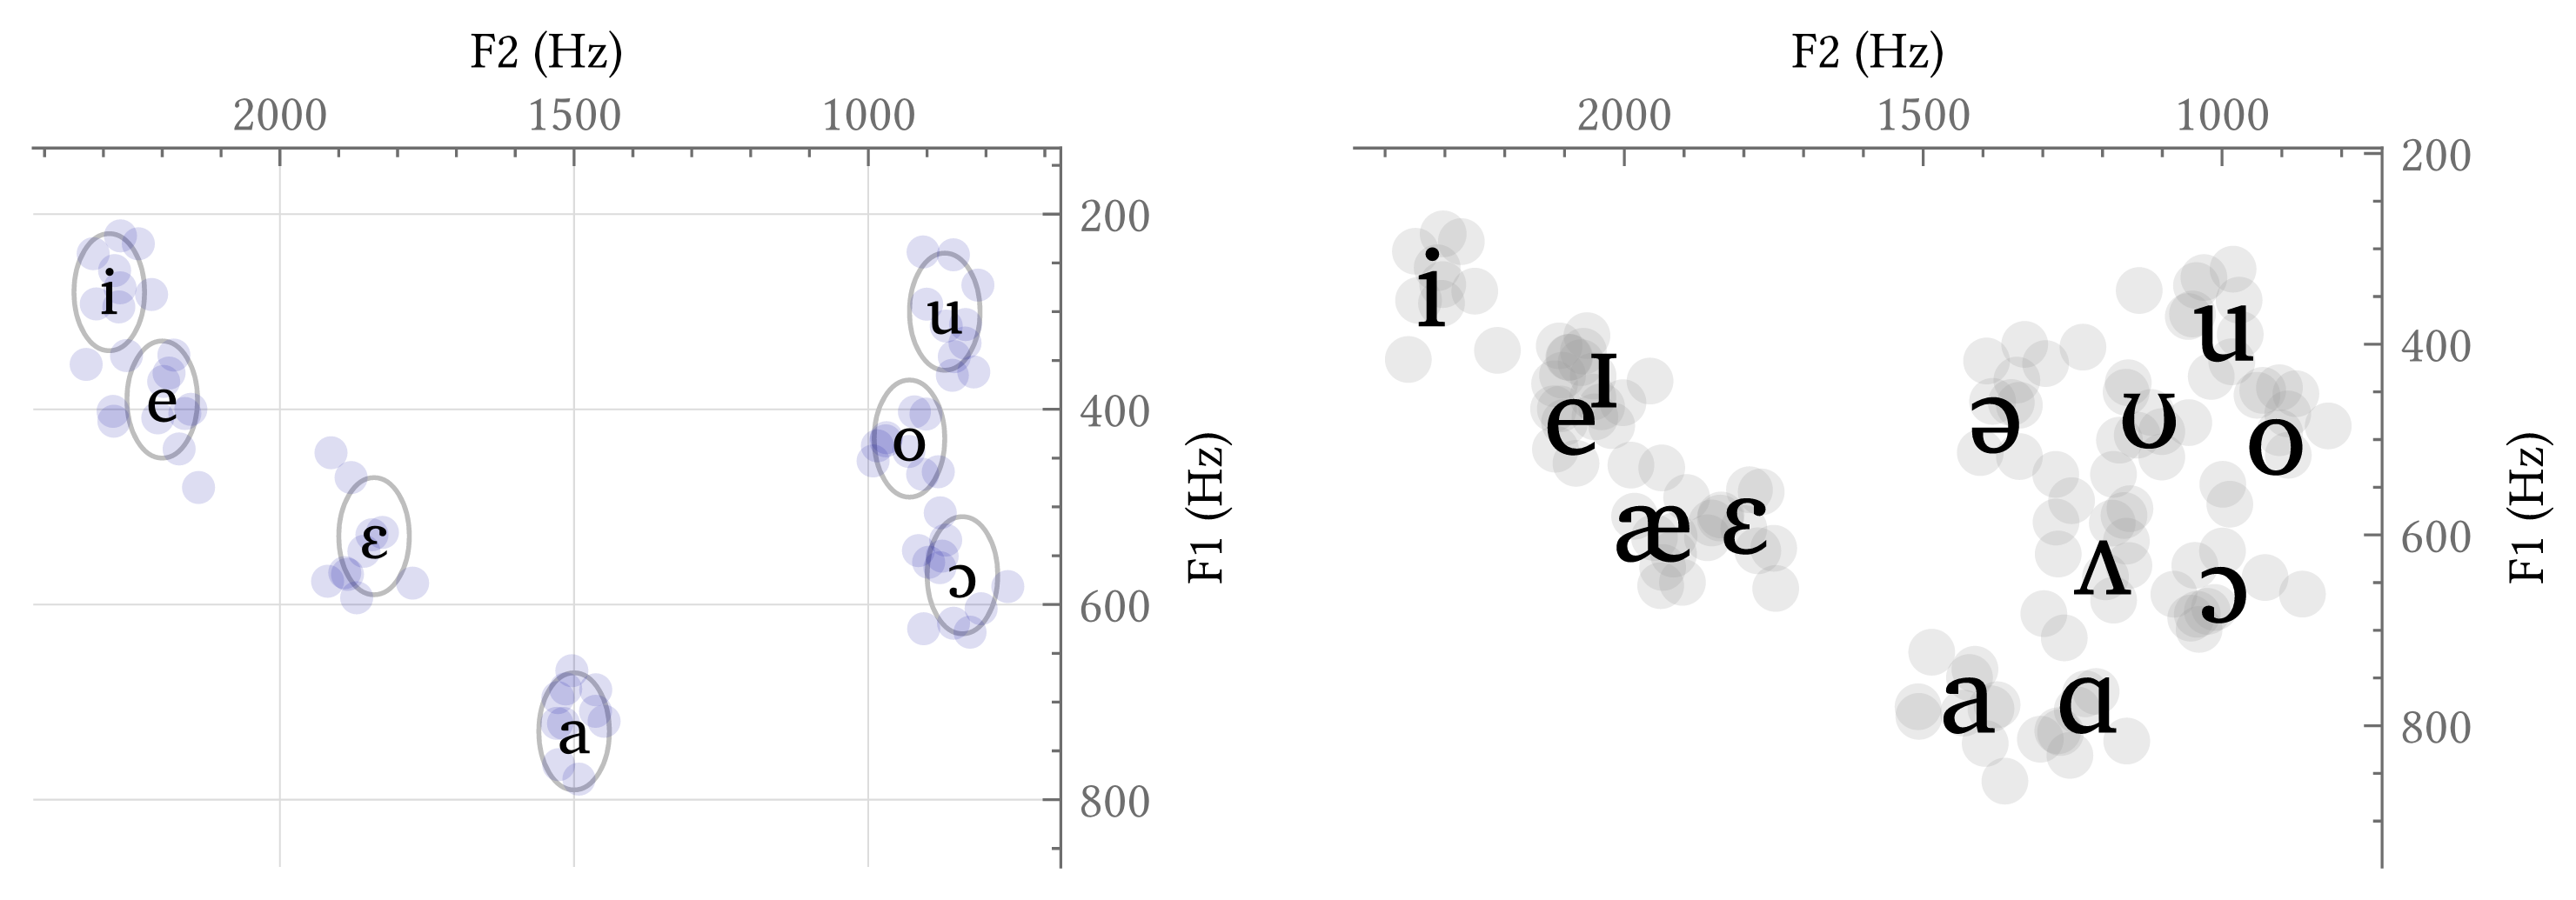
Dispersion vocalique
#formants("italian", scale: 0.6, ellipse: true, axis-size: 1.3em)
#formants("english", point-size: 100,
  point-color: luma(150),
  axis-size: 1.3em,
  vowel-size: 2.8em,
  grid: false,
  scale: 0.6
)
Pour tracer des données réelles, passez un fichier csv à l’argument source. Le fichier doit contenir un en-tête avec les colonnes vowel, f1 et f2 (les autres colonnes sont ignorées). Dans ce mode, les moyennes sont calculées à partir des valeurs observées, et les ellipses utilisent les écarts-types de l’échantillon. Le fichier formants_sample.csv, utilisé dans Figure 14, se trouve dans le répertoire extras/ du dépôt.
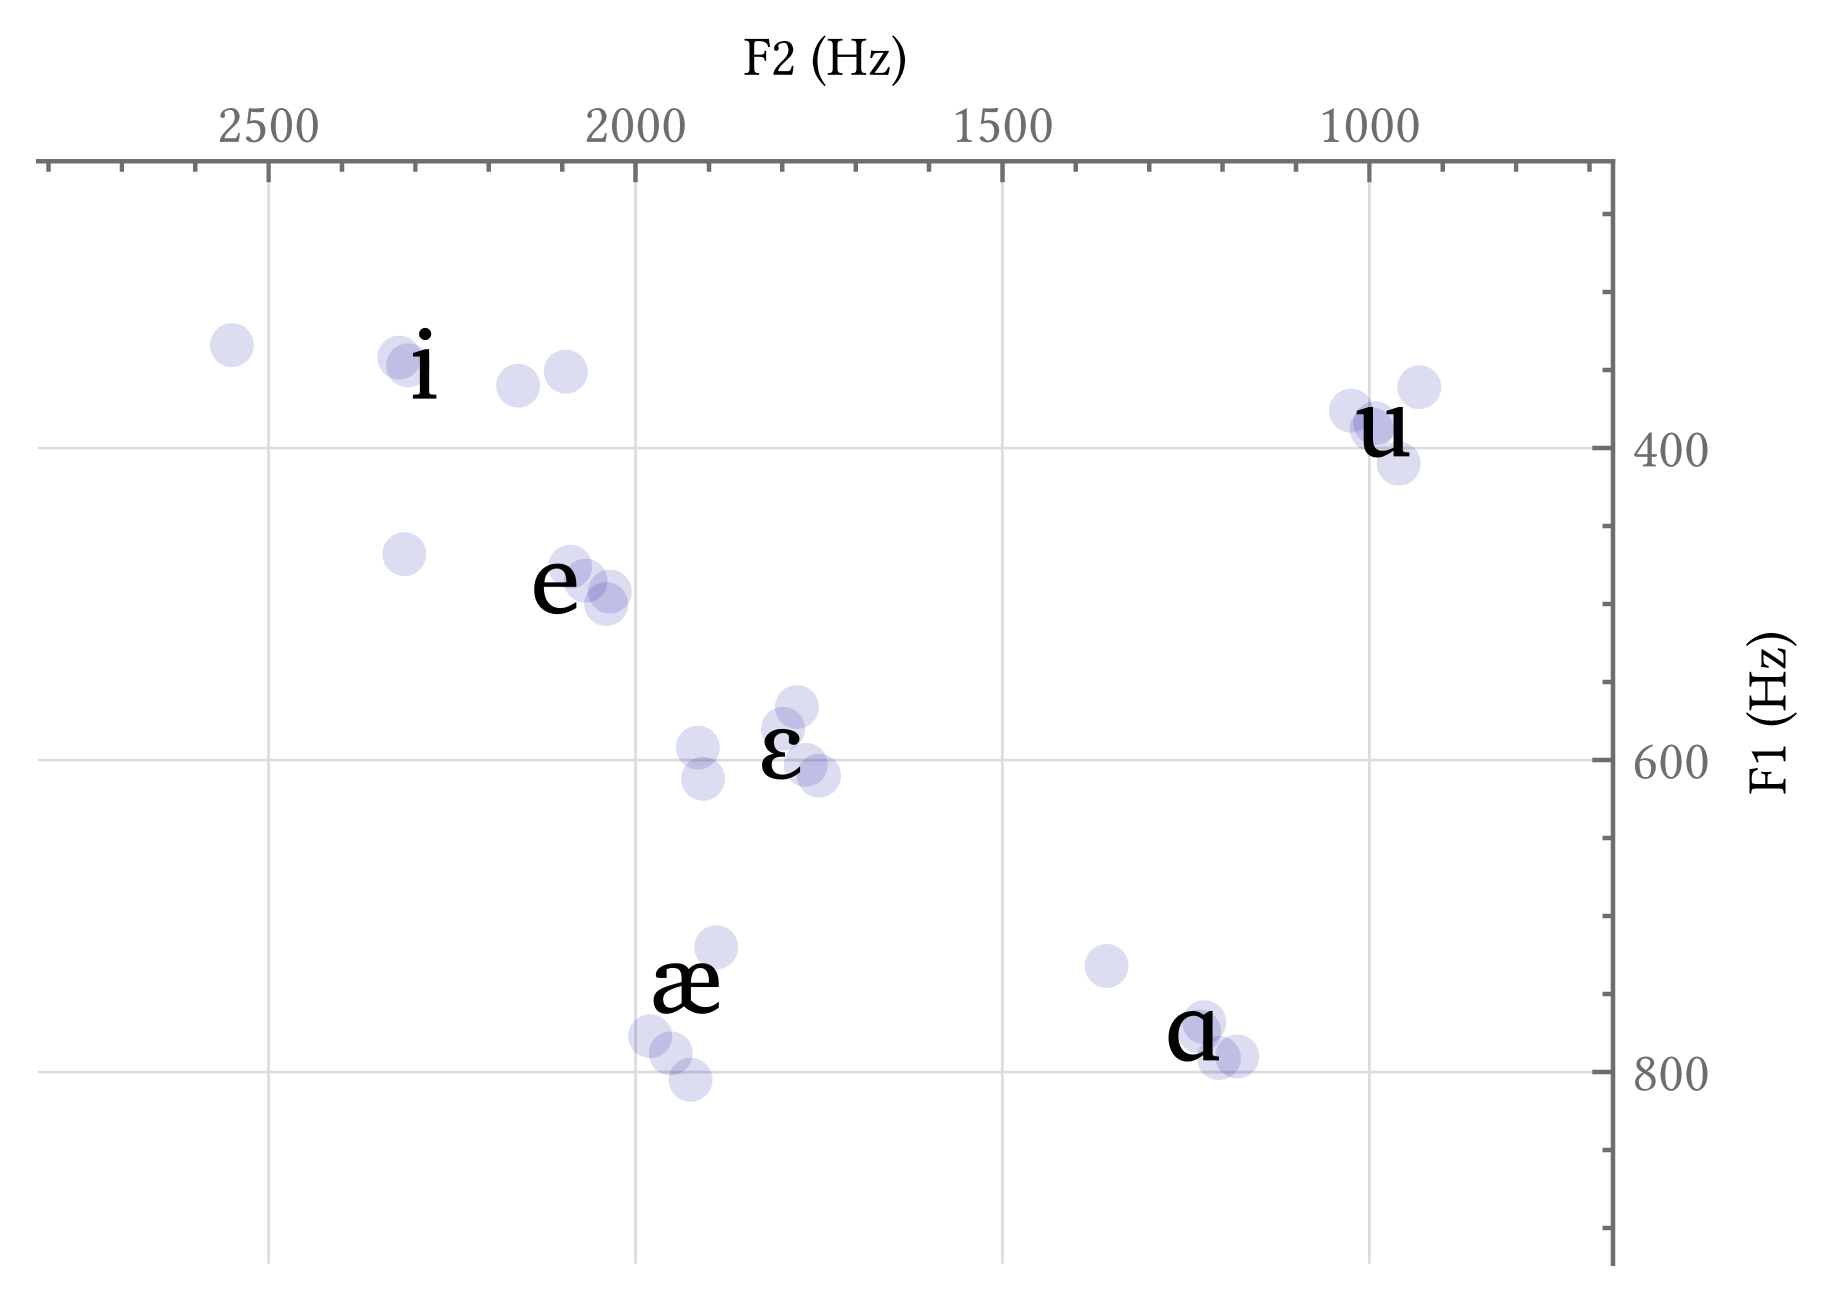
csv.
Formants à partir d’un fichier csv
// vowel,f1,f2,speaker
// i,342,2322,s1
// ...
#formants(source: csv("extras/formants_sample.csv"), scale: 0.8)
4 SPE
Les règles de réécriture peuvent être complexes, et phonokit fournit deux fonctions primitives pour les matrices de traits qui peuvent être combinées pour former des règles SPE (Chomsky et Halle 1968).
La première fonction est #feat-matrix(), qui produit la matrice de traits maximale pour un phonème donné (avec l’option pour les valeurs 0 si all: true). Cela peut être utile dans les cours d’introduction à la notion de traits distinctifs. La fonction est basée sur les traits de Hayes (2009). Figure 15 montre les matrices pour les phonèmes de « patchy ».
Matrices de traits
#feat-matrix("p") #feat-matrix("\\ae") #feat-matrix("\\t tS") #feat-matrix("i")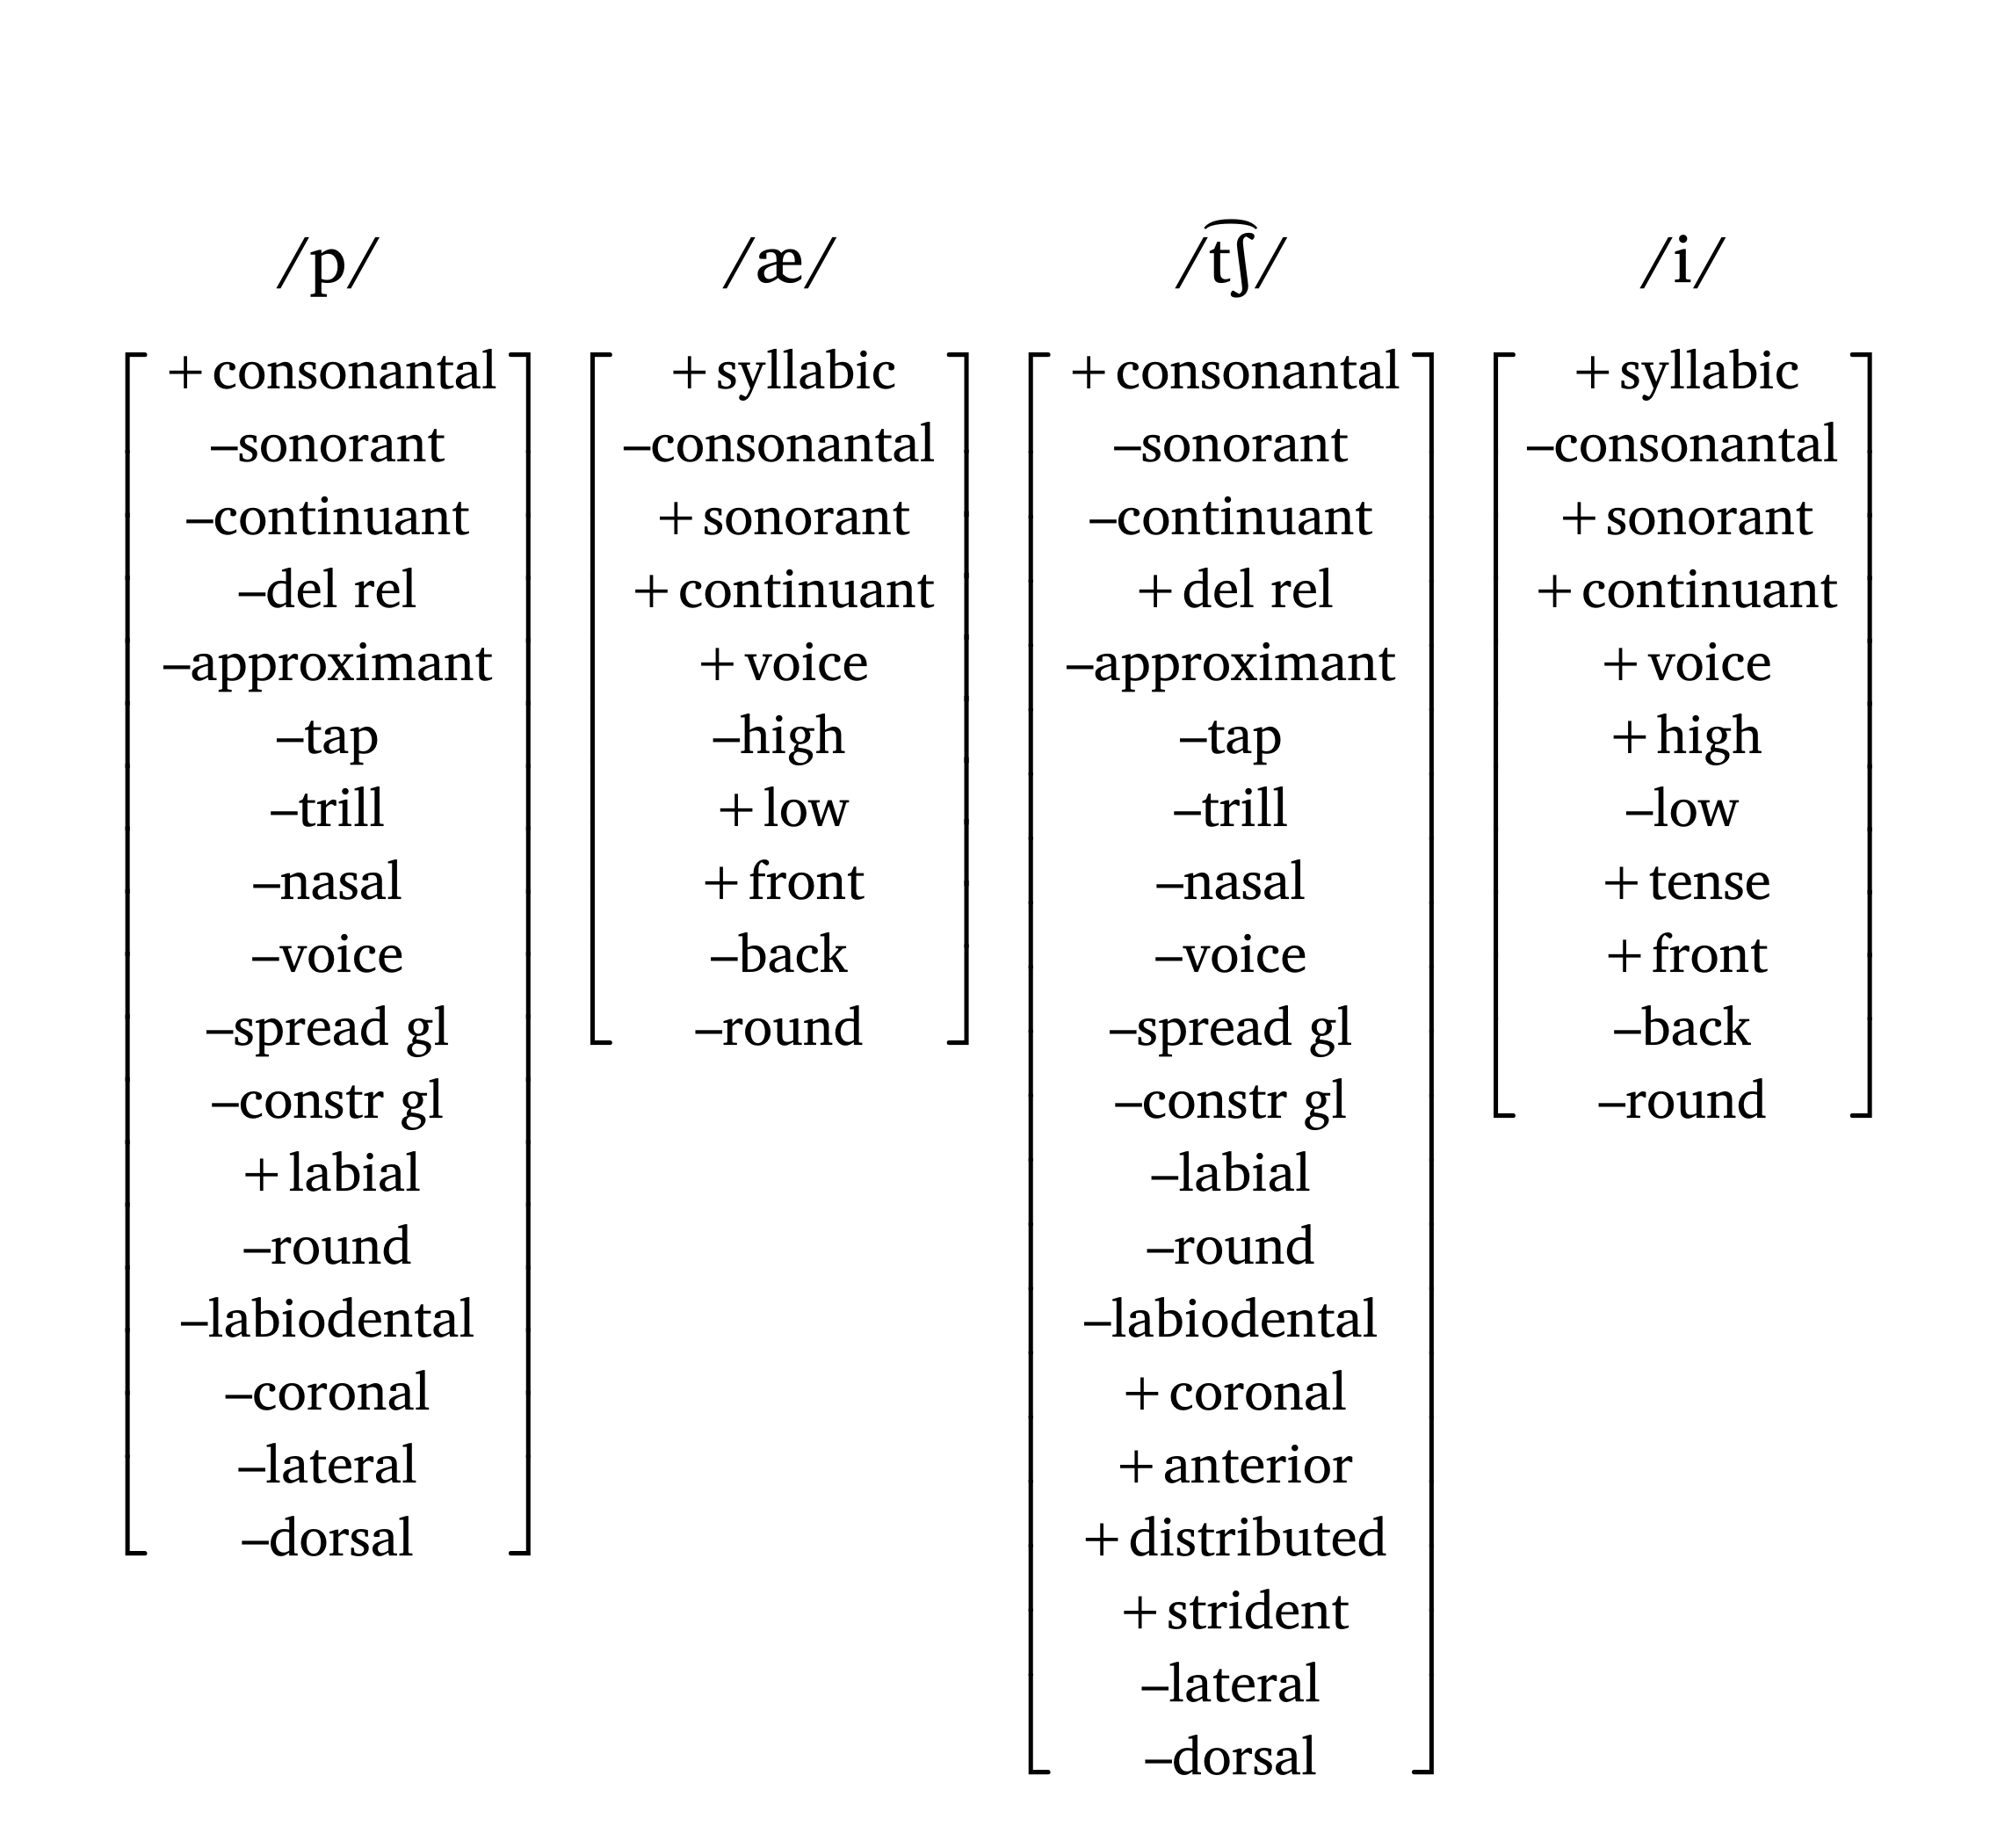
La deuxième fonction, #feat(), crée une matrice à partir d’un ensemble de traits — c’est la fonction utilisée dans une règle de réécriture. La notation alpha requiert une syntaxe spécifique : X + "feat" ou X + [smallcaps("feat")]. La fonction utilitaire #blank() ajoute un long soulignement pour le contexte d’application, et #a-r ajoute une flèche droite (autres flèches : #a-l, #a-u, #a-d, #a-lr, #a-ud, #a-sr, #a-sl, #a-r-large). Figure 16 montre une règle d’assimilation du lieu d’articulation nasal.
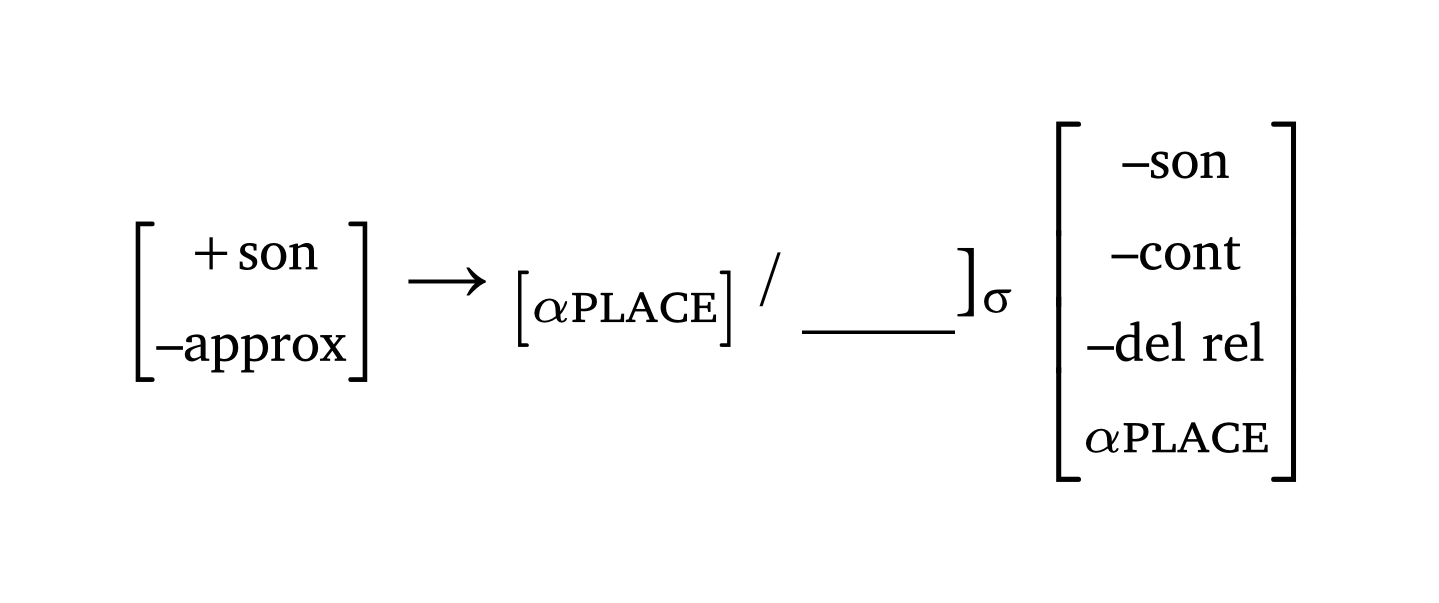
Règle de réécriture SPE
#feat("+son", "–approx") #a-r
  #feat(sym.alpha + [#smallcaps("place")]) / #blank()\]#sub[#sym.sigma]
  #feat("–son", "–cont", "–del rel", sym.alpha + [#smallcaps("place")])
5 Prosodie
5.1 Sonorité
Lors de la discussion du principe de sonorité dans les cours d’introduction, il est utile d’illustrer la sonorité relative avec une représentation visuelle. La fonction #sonority(), basée sur l’échelle de sonorité de Parker (2011, 18), trace les phonèmes et leurs profils de sonorité relatifs. Si des frontières syllabiques sont détectées dans l’entrée, la fonction alterne entre des remplissages blancs et gris pour distinguer chaque syllabe.
Profil de sonorité
#sonority("vA \\*r .sI.ti", scale: 0.7)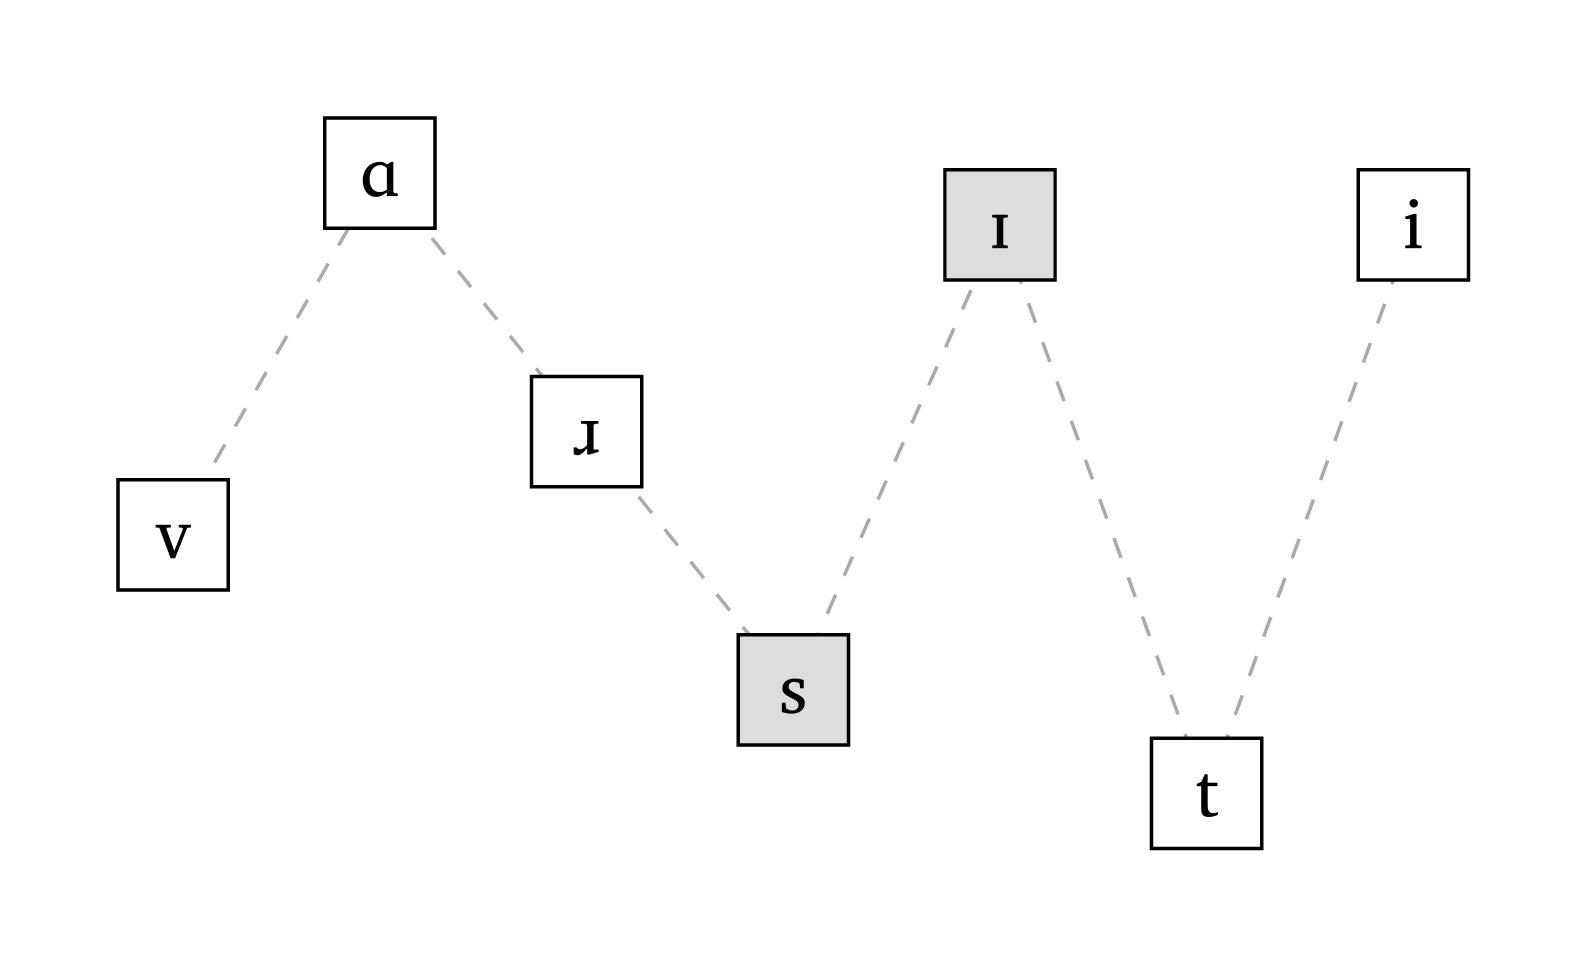
5.2 Syllabes, pieds et mots prosodiques
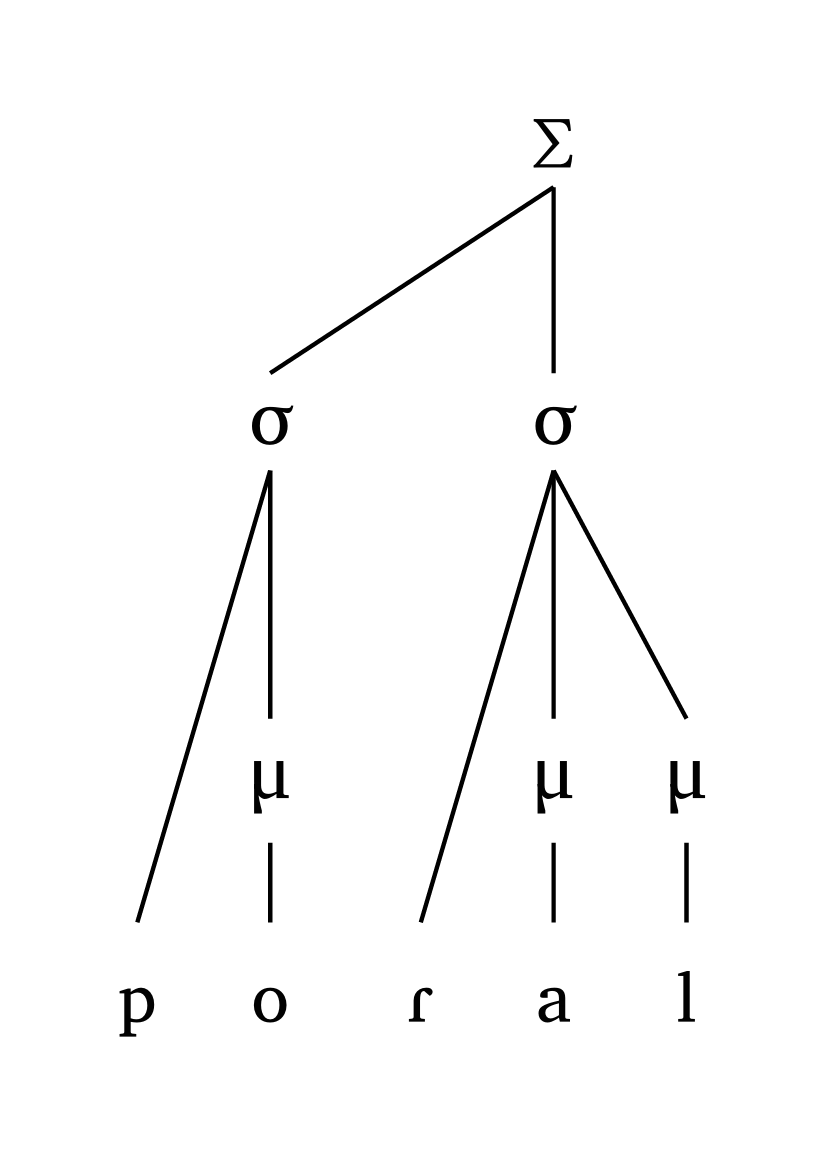
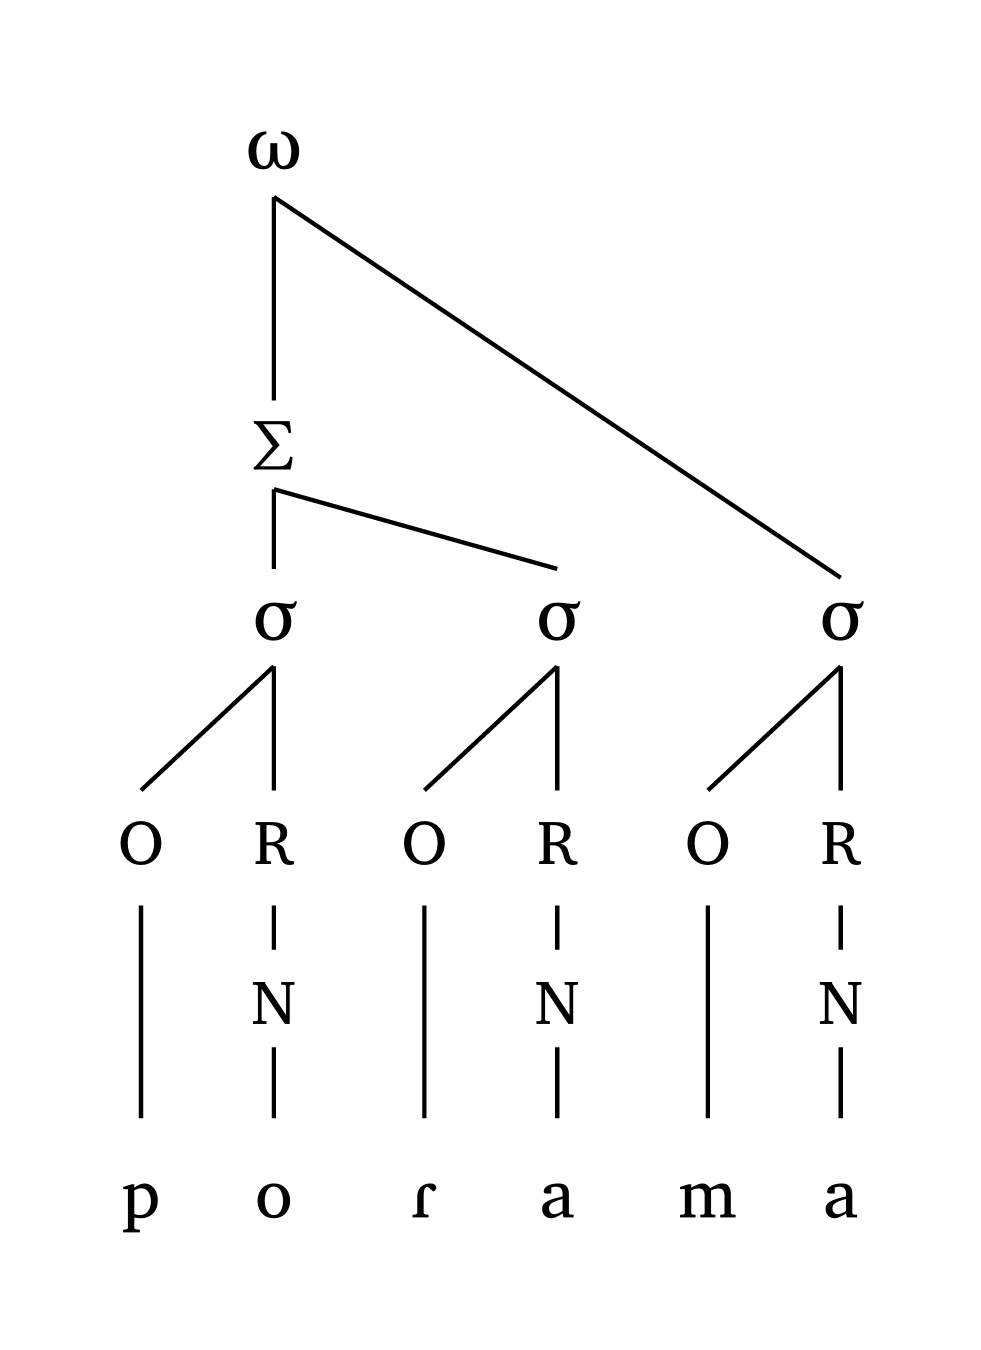
Six fonctions couvrent la structure prosodique : #syllable() et #mora() pour une syllabe (attaque-rime ou moraïque), #foot() et #foot-mora() pour un pied, et #word() et #word-mora() pour les mots prosodiques. Toutes prennent la même entrée que #ipa(), avec quelques conventions : le point . marque les frontières syllabiques, l’apostrophe ' marque la tête du pied, les parenthèses () délimitent les pieds (les syllabes hors pied se rattachent directement au mot prosodique) et : marque la longueur vocalique. Dans les représentations moraïques, coda: true rend les codas moraïques ; dans un mot qui contient plus d’un pied, foot: "L" ou foot: "R" (par défaut) détermine le pied qui porte l’accent principal. Figure 18, Figure 19 et Figure 20 montrent un exemple de chaque type.
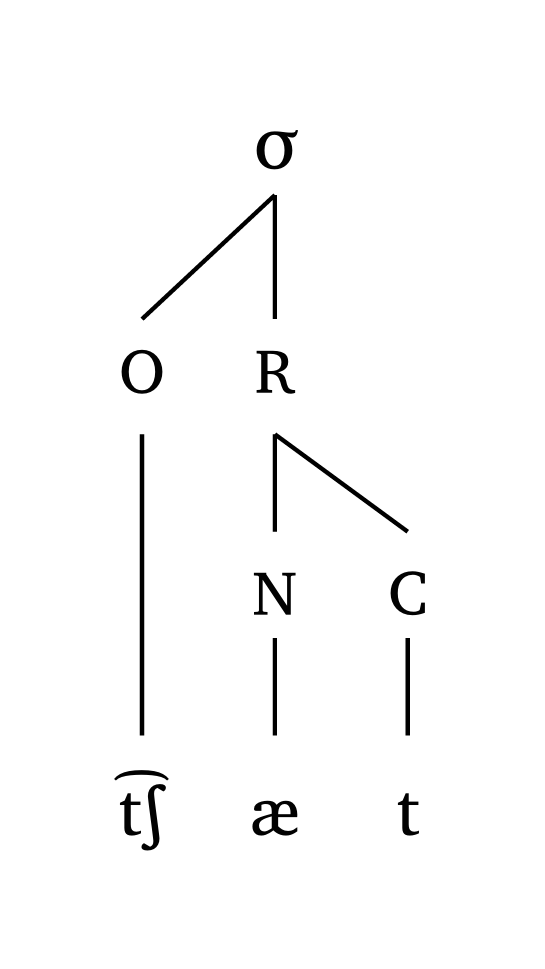
Syllabe, pied et mot prosodique
#syllable("\\t tS \\ae t")
#foot-mora("po.'Ral", coda: true)
#word("('po.Ra).ma")
Les représentations s’adaptent automatiquement à l’entrée : les attaques et codas complexes élargissent la structure, les géminées sont rattachées à la fois à la coda et à l’attaque, et la hauteur augmente au besoin pour éviter que les lignes se croisent (toutes les lignes sont droites). L’espacement vertical s’adapte par défaut à chaque représentation (spacing: "auto") ; utilisez spacing: "fixed" pour un espacement constant, et distance pour allonger ou raccourcir certains niveaux. L’argument scale redimensionne les lignes et le texte ensemble, et symbol remplace les étiquettes par défaut (ω, Σ, σ, μ) par les vôtres, p. ex. #foot("'pa.ta", symbol: ("Ft", "Syl")). Le manuel PDF contient beaucoup d’autres exemples, notamment des voyelles longues, des géminées, des dactyles et des cas extrêmes.
5.3 Grille métrique
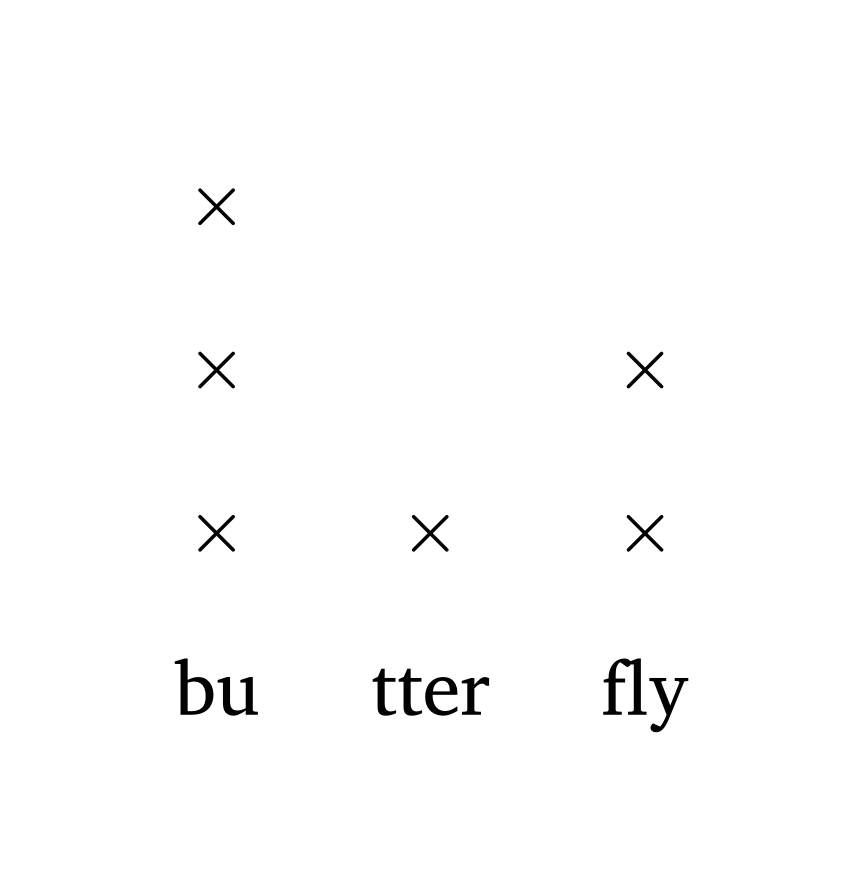
La fonction #met-grid() crée une grille métrique où \(\times\) indique la proéminence. L’entrée peut être une chaîne dont les chiffres indiquent la hauteur de chaque syllabe dans la grille, ou des tuples dont le premier élément suit les conventions de #ipa(). Figure 21 montre la grille du mot anglais butterfly.
Grille métrique
#met-grid("bu3.tter1.fly2")                           // string input
#met-grid(("b2", 3), ("R \\schwar", 1), ("flaI", 2))  // tuple (IPA) input
6 Autosegments
La fonction #autoseg() permet de représenter des traits ou des tons sur un niveau distinct, incluant la liaison, la déliaison, les tons flottants et les tons de contour. Les entrées sont des tableaux, donc chaque phonème est saisi individuellement. Cela permet des espaces vides, des symboles de frontière de domaine, etc.
6.1 Propagation de traits
Figure 22 illustre #autoseg() dans un scénario simple de propagation de traits. L’argument links est un tableau de tuples : ((2,1),) signifie « tracer un lien de l’indice 2 à l’indice 1 ». L’argument arrow ajoute ou supprime les têtes de flèches sur les lignes de liaison.
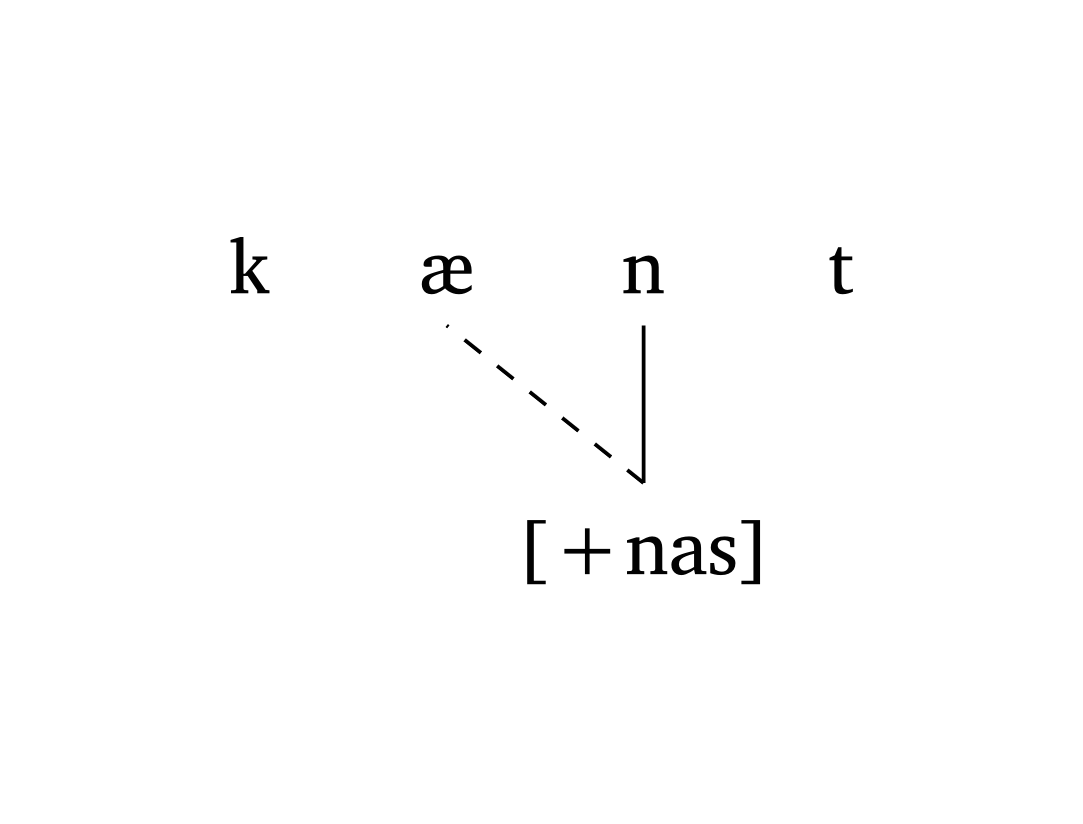
Propagation nasale
#autoseg(
    ("k", "\\ae", "n", "t"),
    features: ("", "", "[+nas]", ""),
    links: ((2, 1),),
    spacing: 1.0,
    arrow: false,
  )
Figure 23 montre un exemple de métaphonie dans le Vénète brésilien (Garcia et Guzzo 2023) où [+high] se propage du /i/ final vers /e/ (position 3) et /o/ (position 1). L’argument gloss permet une annotation rapide.
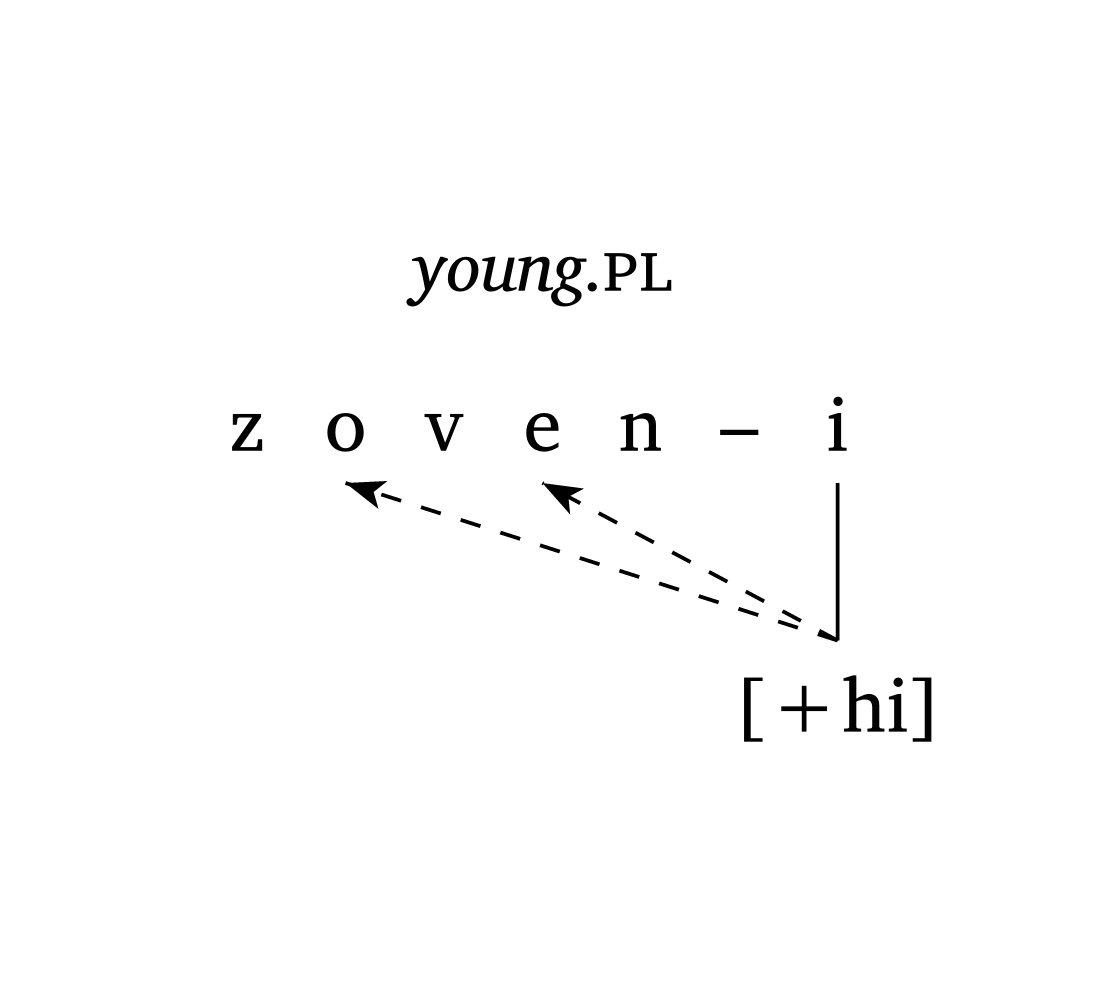
Métaphonie (Vénète brésilien)
#autoseg(
    ("z", "o", "v", "e", "n", "–", "i"),
    features: ("", "", "", "", "", "", "[+hi]"),
    links: ((6, 3), (6, 1)),
    spacing: 0.5,
    arrow: true,
    gloss: [_young_.#smallcaps("pl")],
  )
6.2 Tons
L’argument tone: true « retourne » la représentation verticalement pour afficher les tons au-dessus du niveau segmental. Figure 24 montre la propagation du ton bas sans déliaison en Nupe (Zsiga 2013).
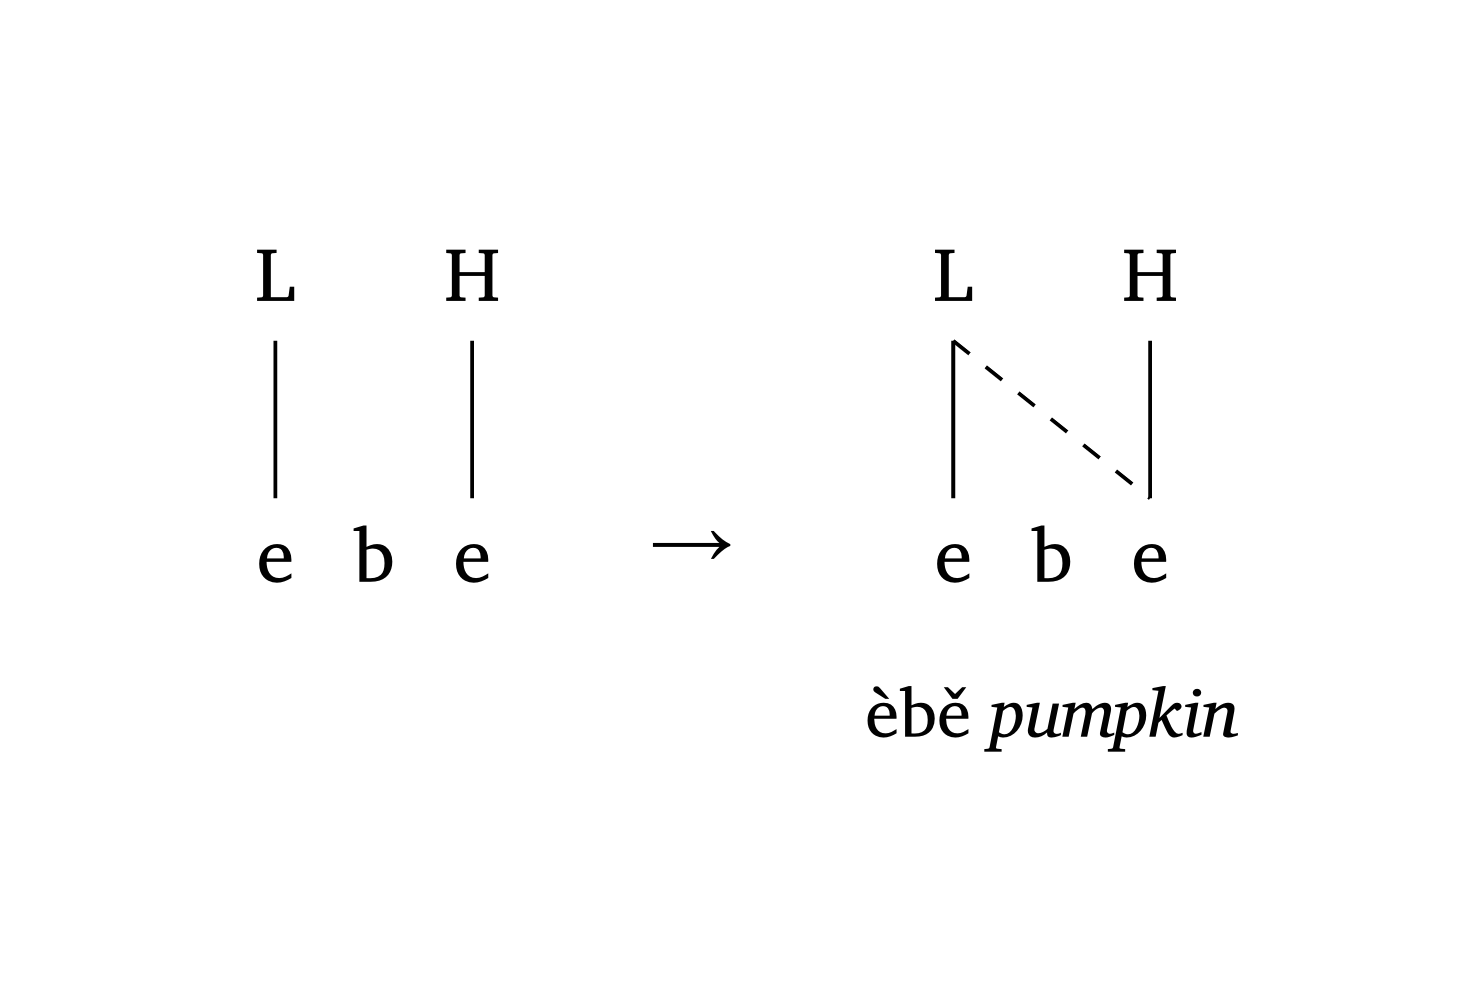
Propagation tonale (Nupe)
#autoseg(
  ("e", "b", "e"),
  features: ("L", "", "H"),
  spacing: 0.5,
  tone: true,
  gloss: [],
)
#a-r  // arrow between stages
#autoseg(
  ("e", "b", "e"),
  features: ("L", "", "H"),
  links: ((0, 2),),
  spacing: 0.5,
  tone: true,
  gloss: [èbě _pumpkin_],
)
Les tons flottants peuvent être ajoutés avec l’argument float. Figure 25 montre comment ajouter un ton flottant et dessiner un cercle autour de lui avec l’argument highlight.
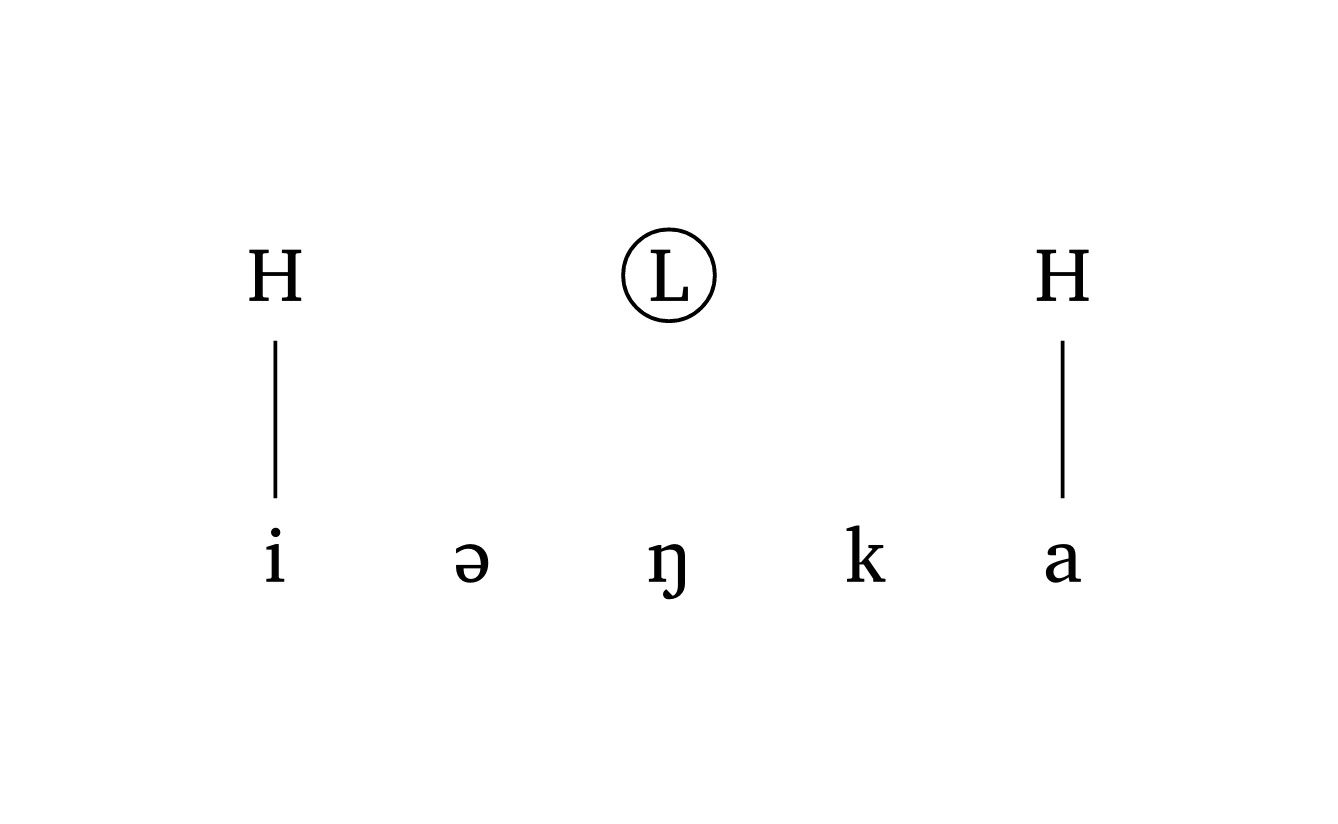
Ton flottant
#autoseg(
      ("i", "@", "N", "k", "a"),
      features: ("H", "", "L", "", "H"),
      highlight: (2,),
      spacing: 1.0,
      tone: true,
      float: (2,),
    )
La propagation à partir d’un ton de contour requiert un tuple dans features pour la voyelle liée à deux tons. L’argument links utilise des tuples imbriqués : (((2, 0), 1),) signifie « du premier ton à la position 2 (c.-à-d. H), tracer une ligne en pointillés vers le segment 1 ». Figure 26 illustre cela.
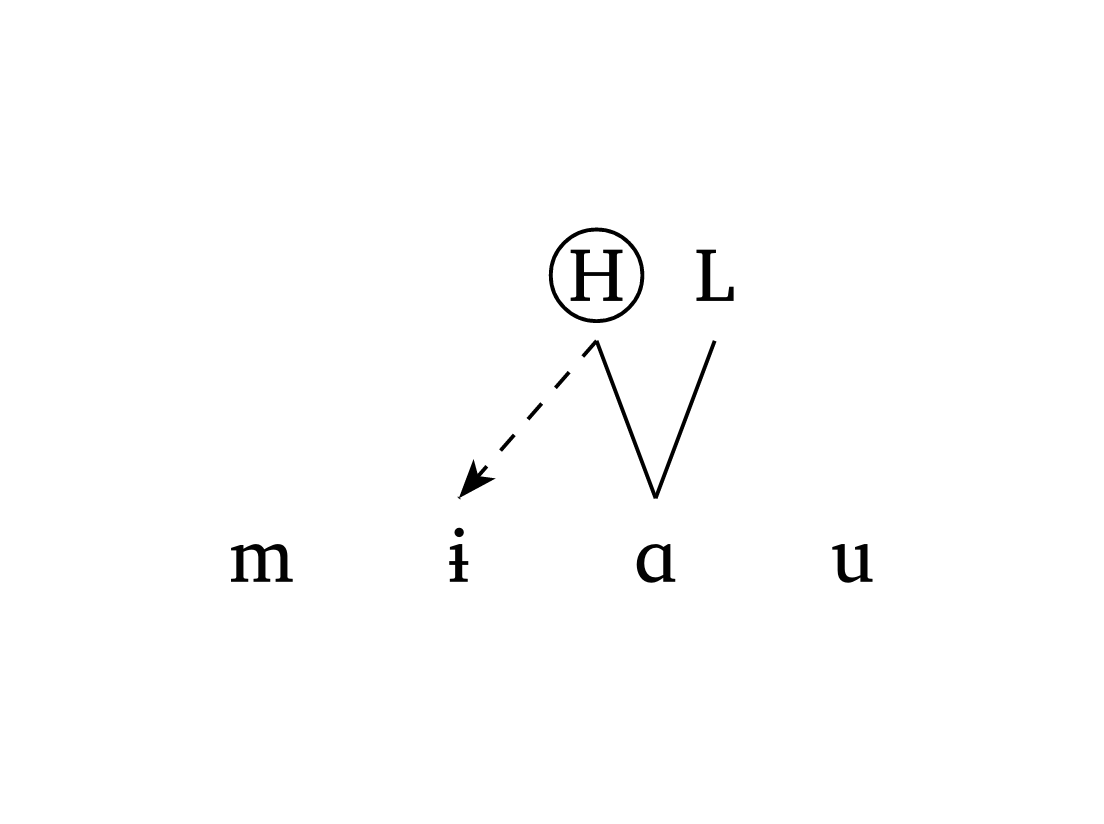
Ton de contour
#autoseg(
  ("m", "1", "A", "u"),
  features: ("", "", ("H", "L"), ""),
  links: (((2, 0), 1),),
  tone: true,
  highlight: ((2, 0),),
  spacing: 1.0,
  arrow: true,
),
Figure 27 montre un effet OCP en trois étapes dans le Vaï (Zsiga 2013), illustrant la déliaison (delinks) et les relations tonales un-à-plusieurs (multilinks). L’argument delinks: ((3, 3),) indique que le lien entre la position 3 et elle-même doit être délié. L’argument multilinks: ((6, (6, 9)),) signifie « centrer un ton sur les segments 6 et 9 simultanément ».
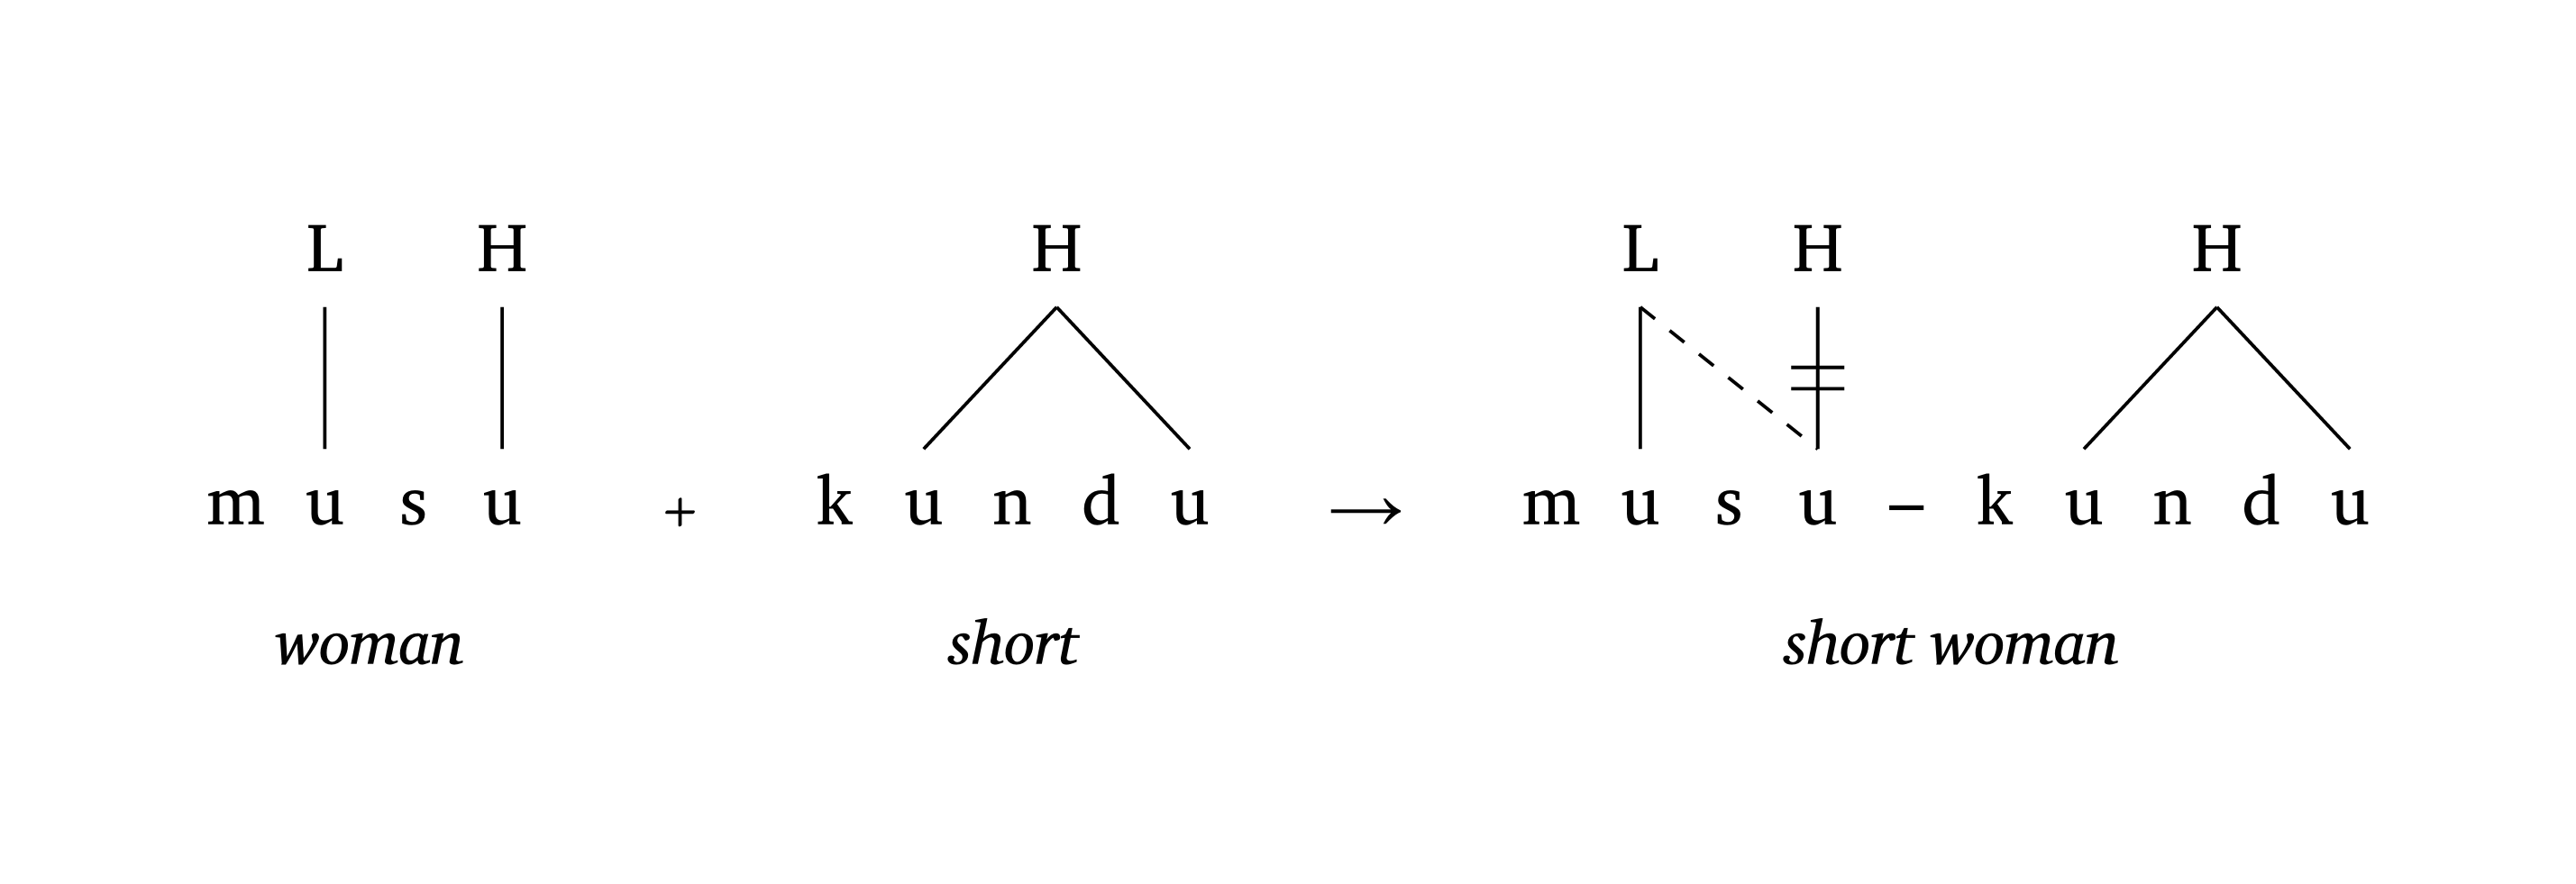
Effets OCP (Vaï)
#autoseg(
      ("m", "u", "s", "u"),
      features: ("", "L", "", "H"),
      tone: true, spacing: 0.5, baseline: 37%,
      gloss: [_woman_],
    ) +
    #autoseg(
      ("k", "u", "n", "d", "u"),
      features: ("", "H", "", "", ""),
      tone: true,
      float: (1,),
      multilinks: ((1, (1, 4)),),
      spacing: 0.5, baseline: 37%,
      arrow: false,
      gloss: [_short_],
    ) #a-r
    #autoseg(
      ("m", "u", "s", "u", "–", "k", "u", "n", "d", "u"),
      features: ("", "L", "", "H", "", "", "H", "", "", ""),
      links: ((1, 3),),
      delinks: ((3, 3),),
      arrow: false,
      multilinks: ((6, (6, 9)),),
      tone: true,
      baseline: 37%,
      spacing: 0.50,
      gloss: [_short woman_],
    )
6.3 Prosodie avec ToBI
L’ajout d’étiquettes ToBI aux chaînes peut être réalisé avec la fonction #int(). L’argument line: false désactive la tige verticale (p. ex., pour les tons de frontière). Par défaut, la taille de police des tons est 0.8em.
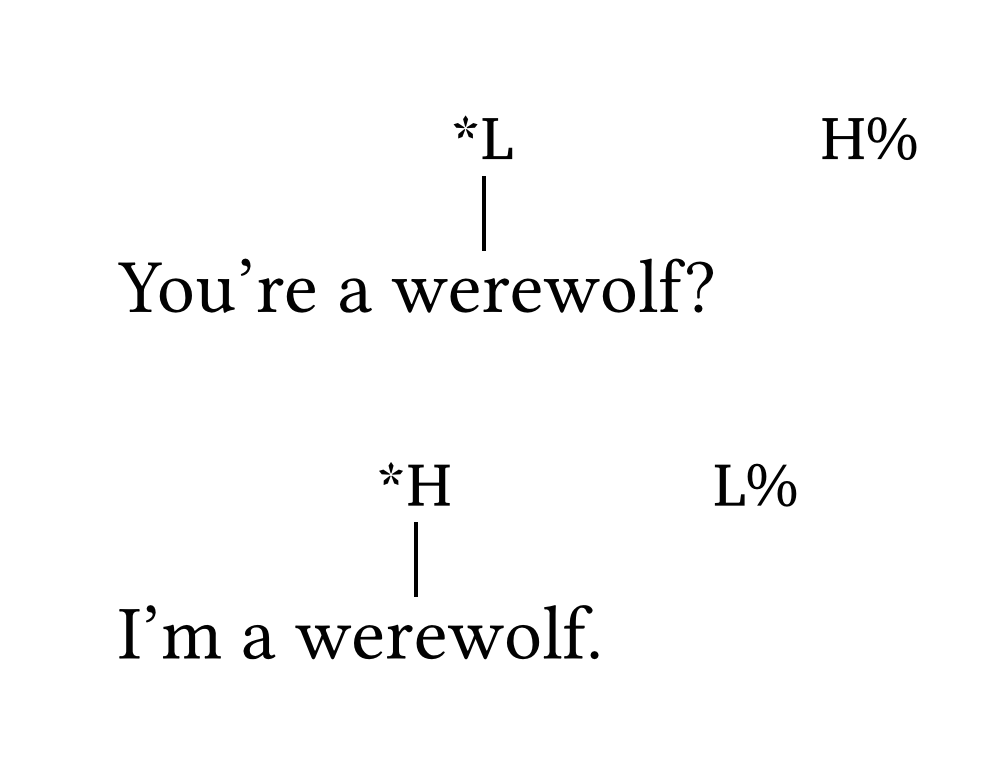
ToBI en ligne
You're a we#int("*L")rewolf?#h(2em)#int("H%", line: false)

I'm a wer#int("*H")ewolf.#h(2em)#int("L%", line: false)
Notez que #int() n’est pas destiné à être utilisé dans les listes numérotées/non numérotées. Dans la grande majorité des cas, les chaînes avec des étiquettes ToBI apparaîtront dans des exemples numérotés — voir la section Exemples numérotés.
6.4 Multi-niveaux
La fonction #multi-tier() offre la liberté de créer une large gamme de structures non linéaires qui ne peuvent pas être générées par des fonctions à usage unique. L’argument principal est levels, un tableau de rangées, où chaque rangée est un tableau d’éléments. Les éléments sont automatiquement liés à l’élément du niveau inférieur ; des liens supplémentaires peuvent être spécifiés avec l’argument links.
Figure 29 reproduit une figure de Booij (2012, 159) sur l’interface de la phonologie et de la morphologie. Figure 30 montre la même figure avec show-grid: true pour aider à visualiser les positions.
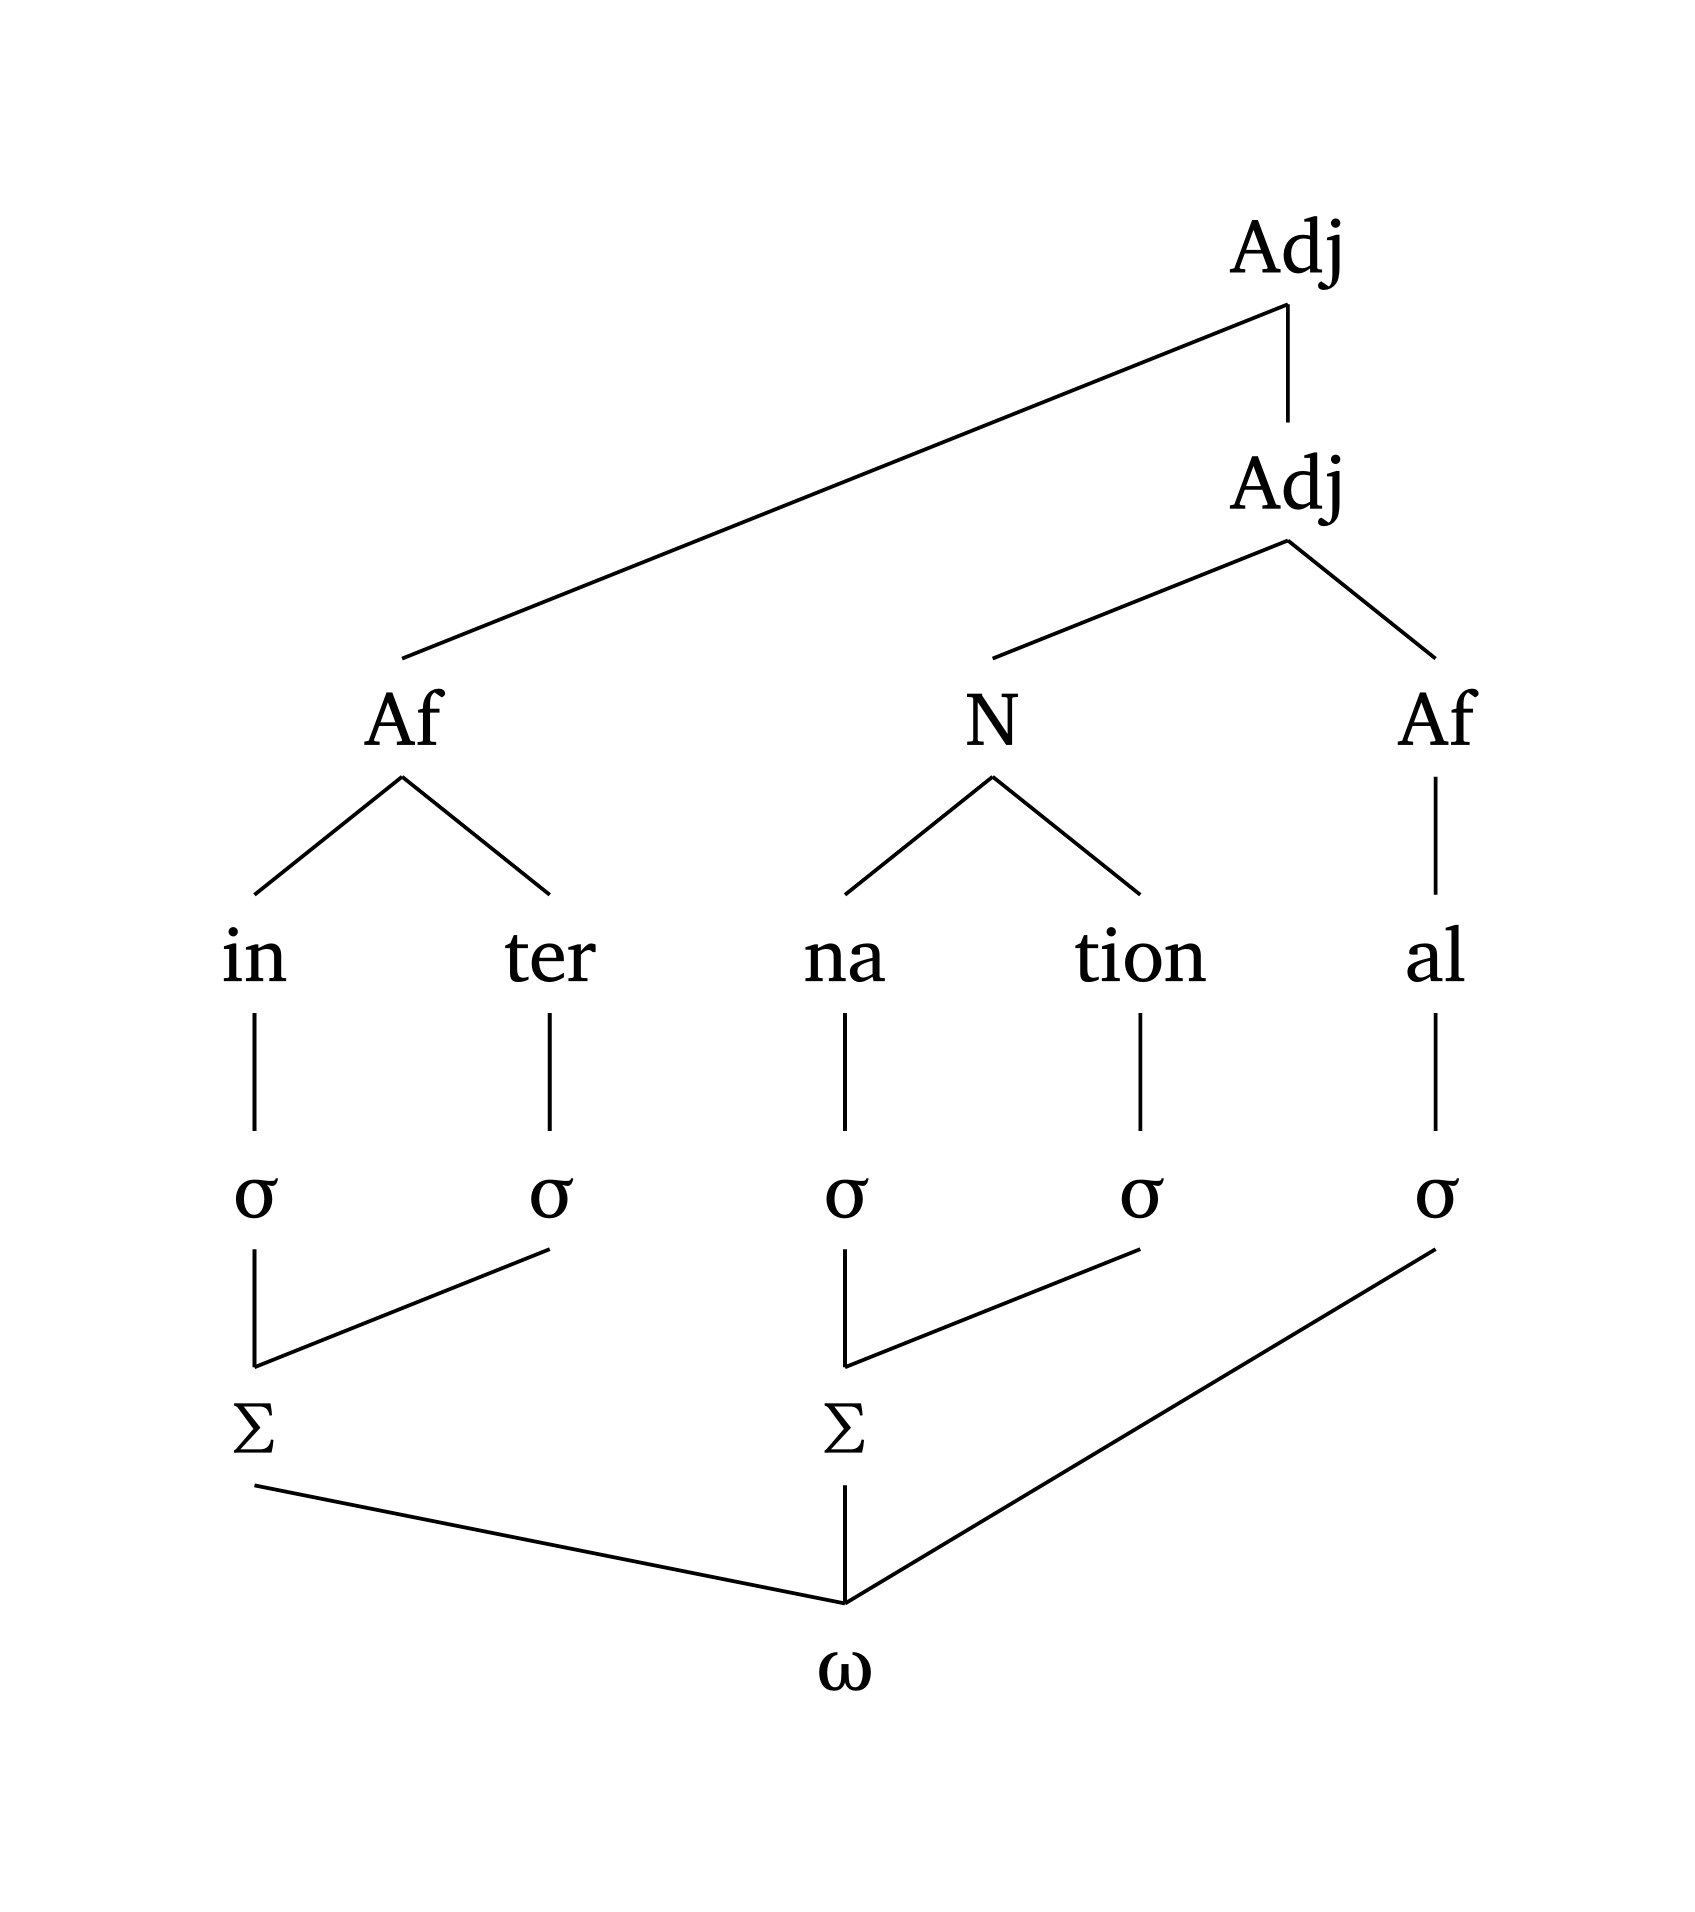
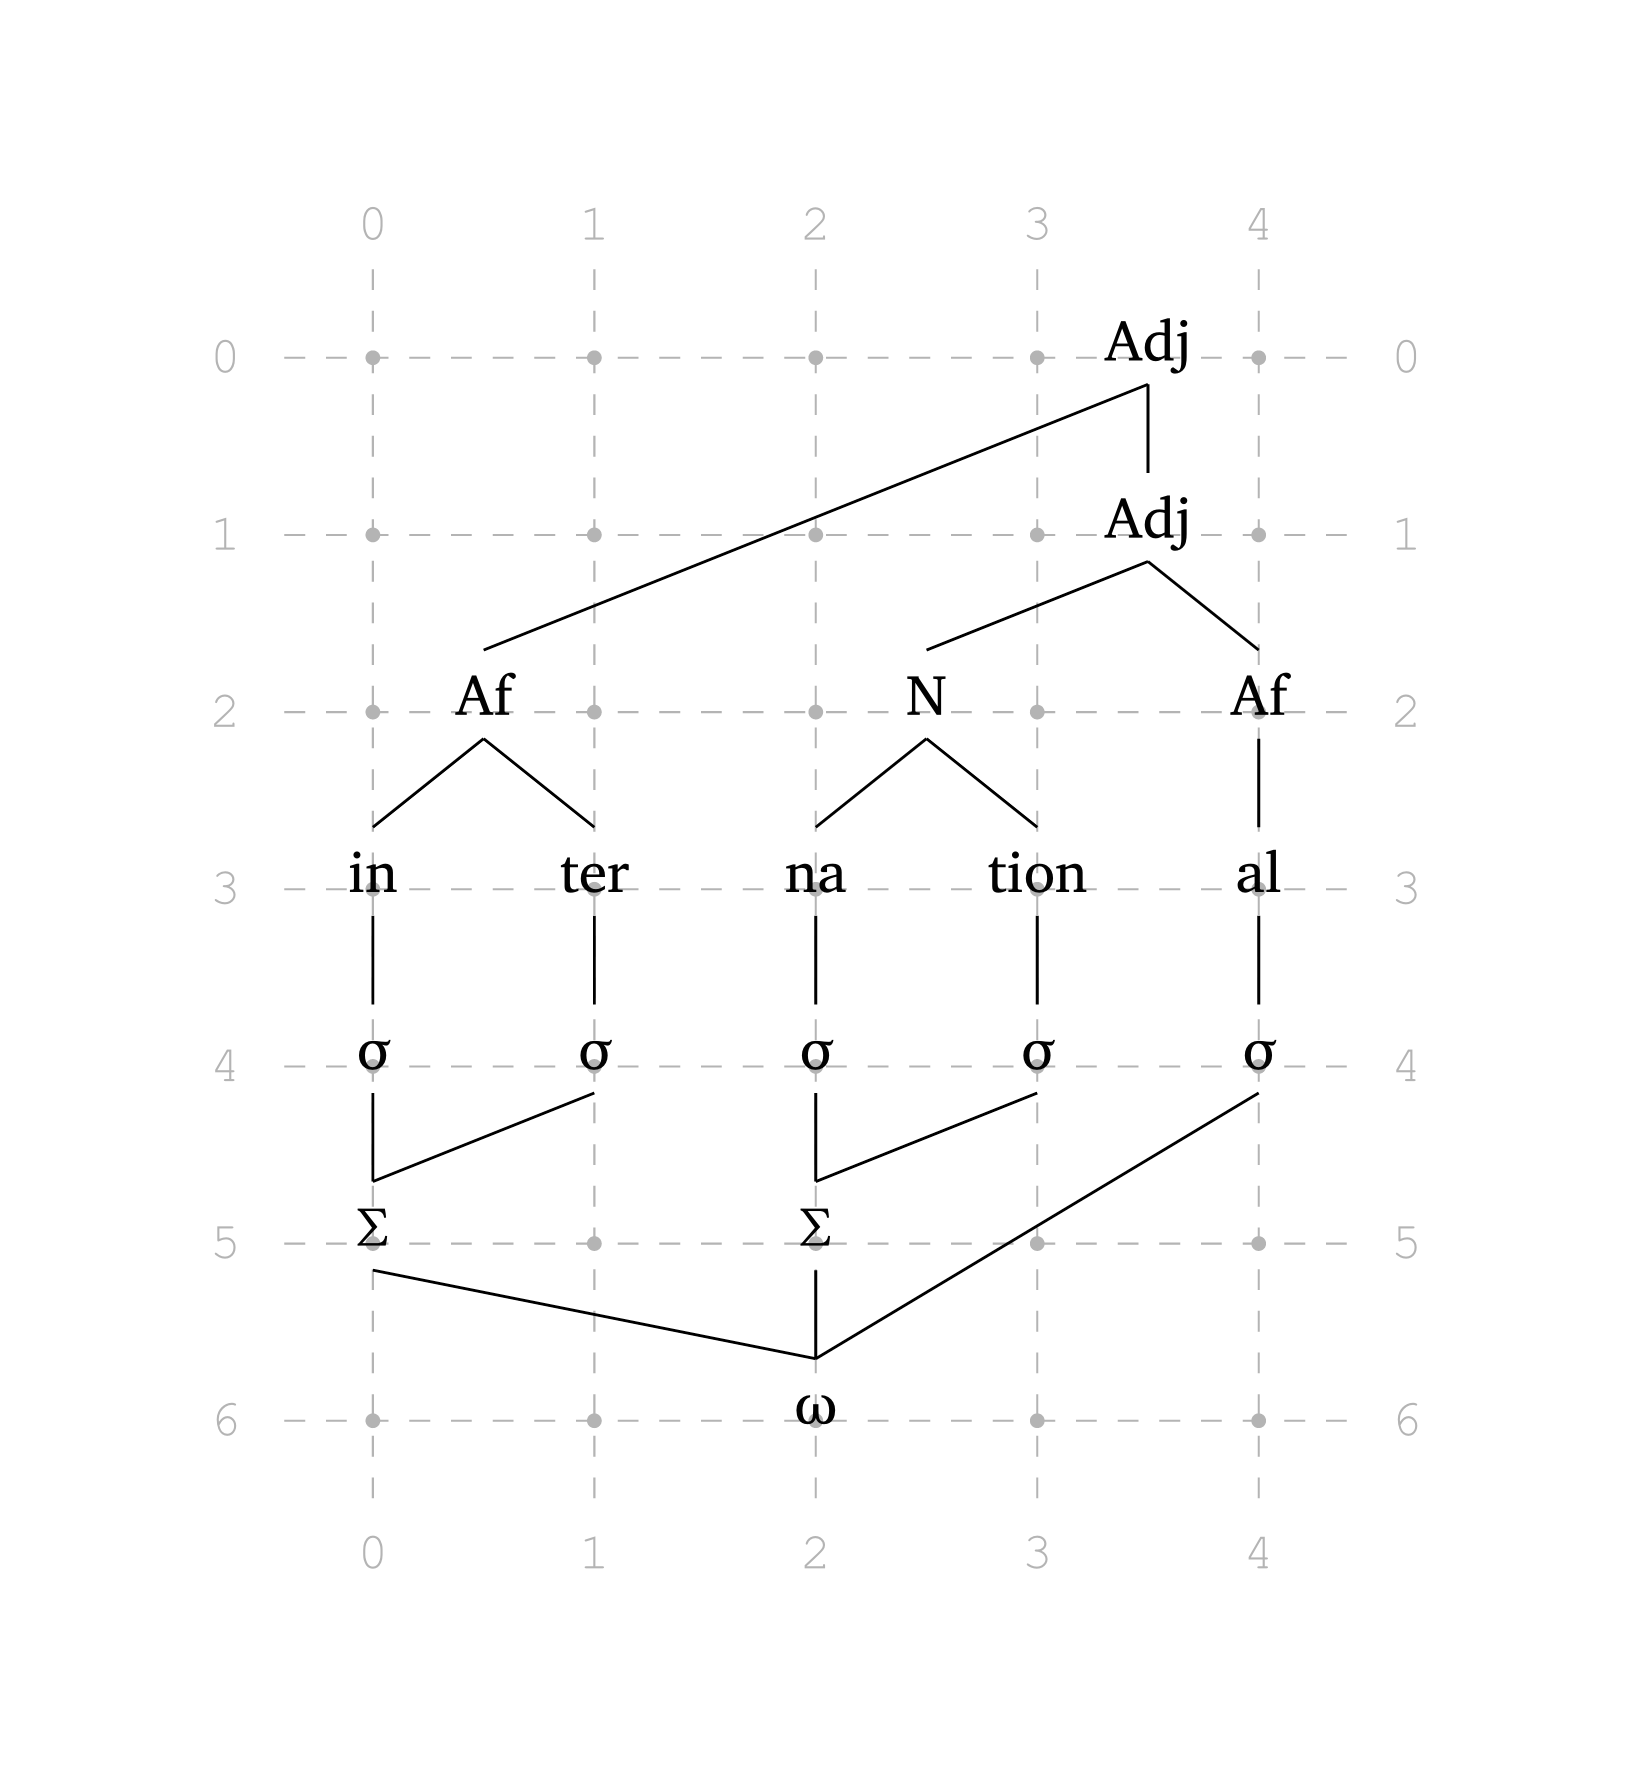
Multi-niveaux (morphophonologie)
#multi-tier(
  show-grid: true, // <- to help you see the grid
  levels: (
    ("", "", "", "", ("Adj", 3.5)),
    ("", "", "", "", ("Adj", 3.5)),
    ("", ("Af", 0.5), "", ("N", 2.5), "Af"),
    ("in", "ter", "na", "tion", "al"),
    ("sigma", "sigma", "sigma", "sigma", "sigma"),
    ("Sigma", "", "Sigma", "", ""),
    ("", "", "omega", "", ""),
  ),
  links: (
    ("adj1", "af1"),
    ("adj2", "n1"),
    ("af1", "in1"),
    ("n1", "na1"),
    ("sigma2", "sigma6"),
    ("sigma4", "sigma7"),
    ("sigma5", "omega1"),
    ("sigma6", "omega1"),
  ),
)
Depuis la version 0.5.7, les étiquettes non vides (chaînes) reçoivent automatiquement un nom dans l’ordre de lecture (adj1, adj2, sigma3, etc.), de sorte que les liens peuvent désigner les nœuds par leur nom, comme dans le code ci-dessus. Les noms ne tiennent pas compte de la casse : sigma et Sigma deviennent tous deux sigmaX, où X est la ne occurrence de sigma. Les coordonnées ((rangée, colonne), à partir de 0) fonctionnent toujours et peuvent être plus claires pour les étiquettes en API, car la normalisation rend parfois les noms moins transparents (/p@lis/ devient p-lisX). Les nœuds de contenu (entre crochets) ne reçoivent pas de nom automatique et doivent être désignés par leurs coordonnées. Pour voir la référence exacte de chaque nœud, utilisez show-refs: true (version 0.5.8), qui l’affiche sous le nœud pendant que vous complétez vos liens.
Les éléments spécifiés comme ("N", 2.5) sont placés à des positions fractionnaires sur la grille. La fonction détecte également automatiquement les lettres grecques : "sigma" est rendu comme \(\sigma\), "Sigma" comme \(\Sigma\), "omega" comme \(\omega\). Les chiffres dans les éléments sont automatiquement rendus en indice.
#multi-tier() peut également créer des représentations de Phonologie du gouvernement et de Phonologie CV. Figure 31, adapté de Goad (2012, 355), montre comment les flèches et arrow-delinks fonctionnent. Il est également possible d’étiqueter les niveaux, comme le montre Figure 32, adapté de Carvalho (2017).
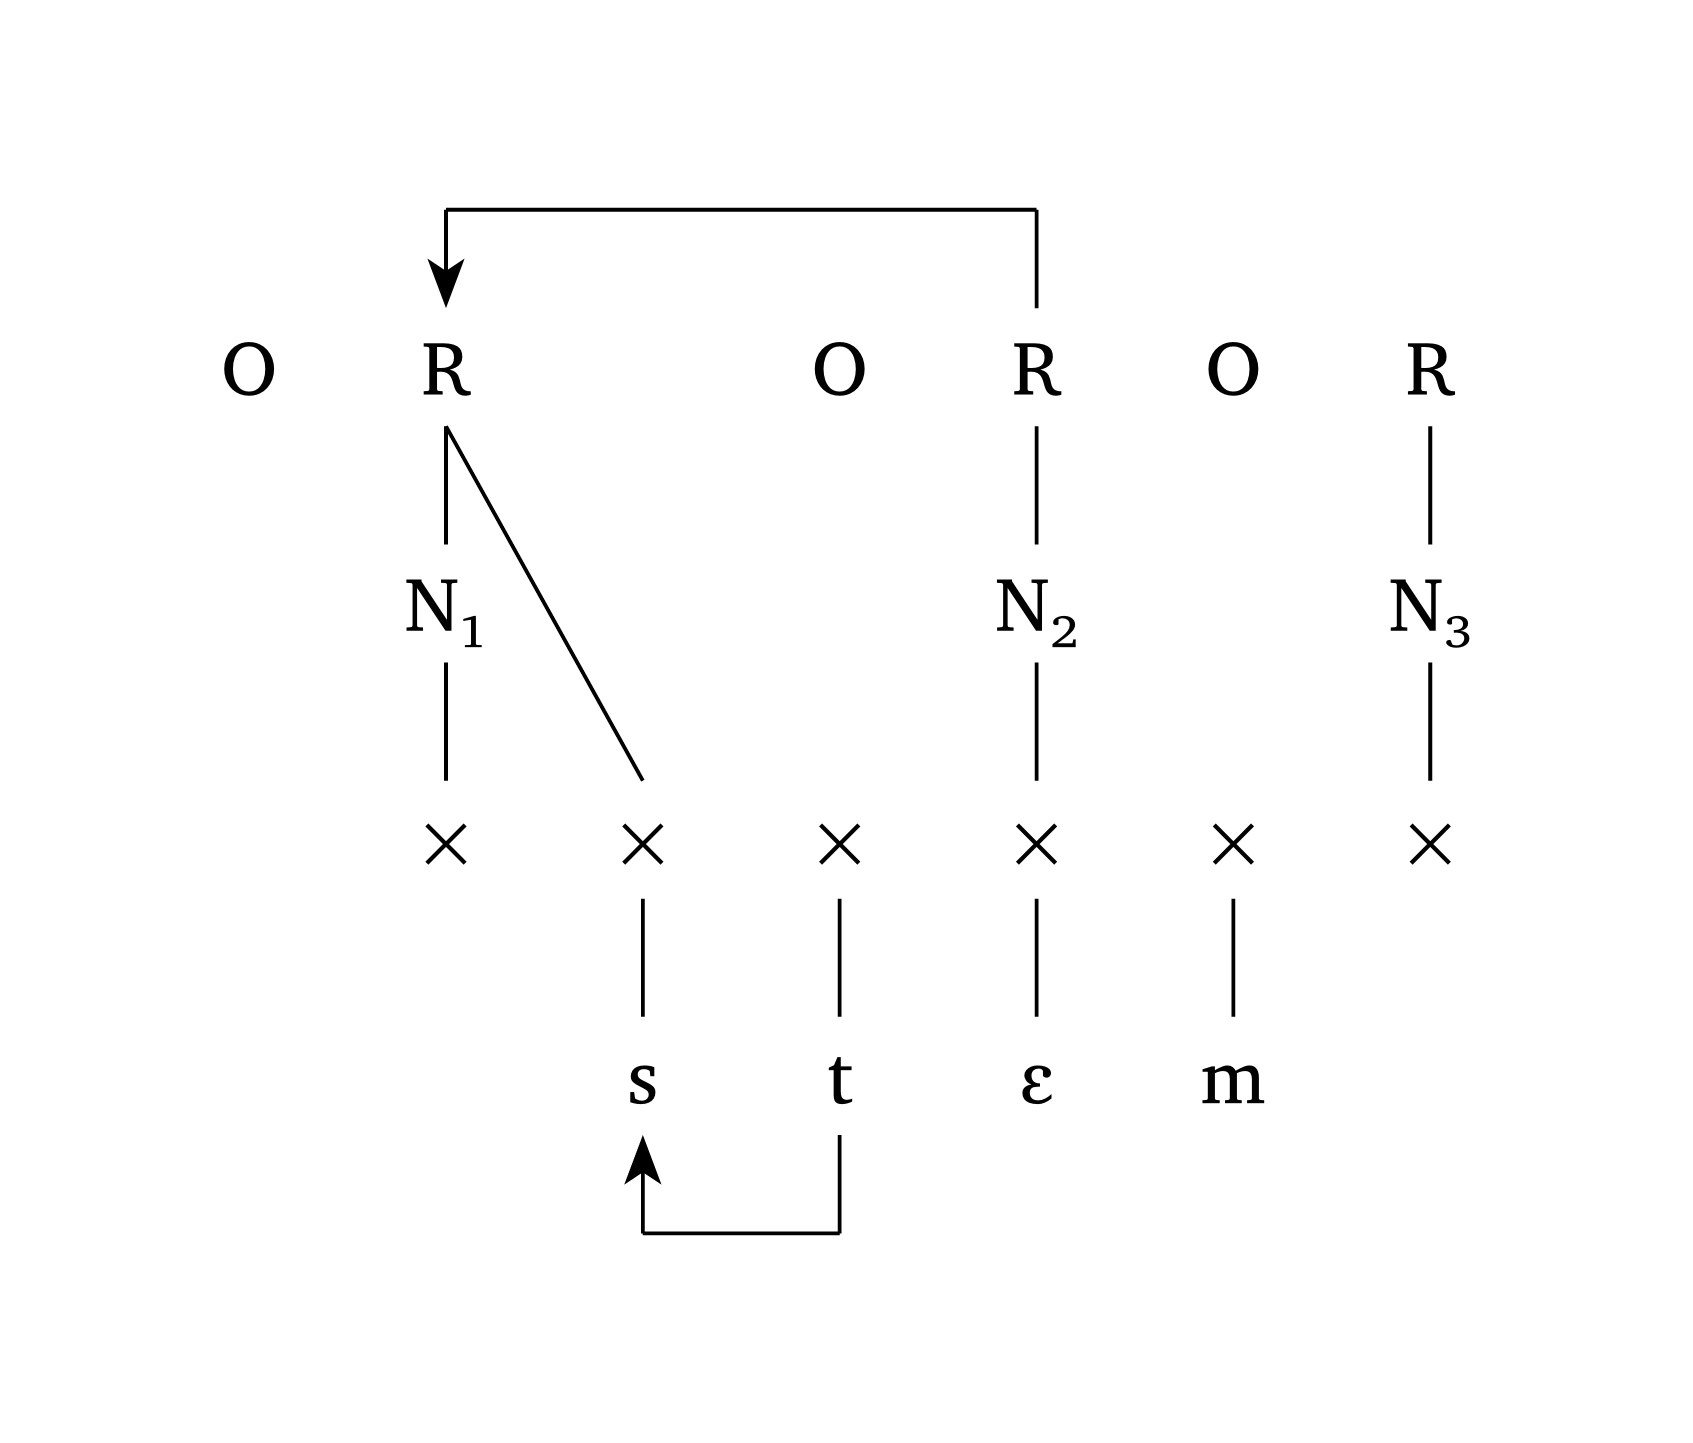
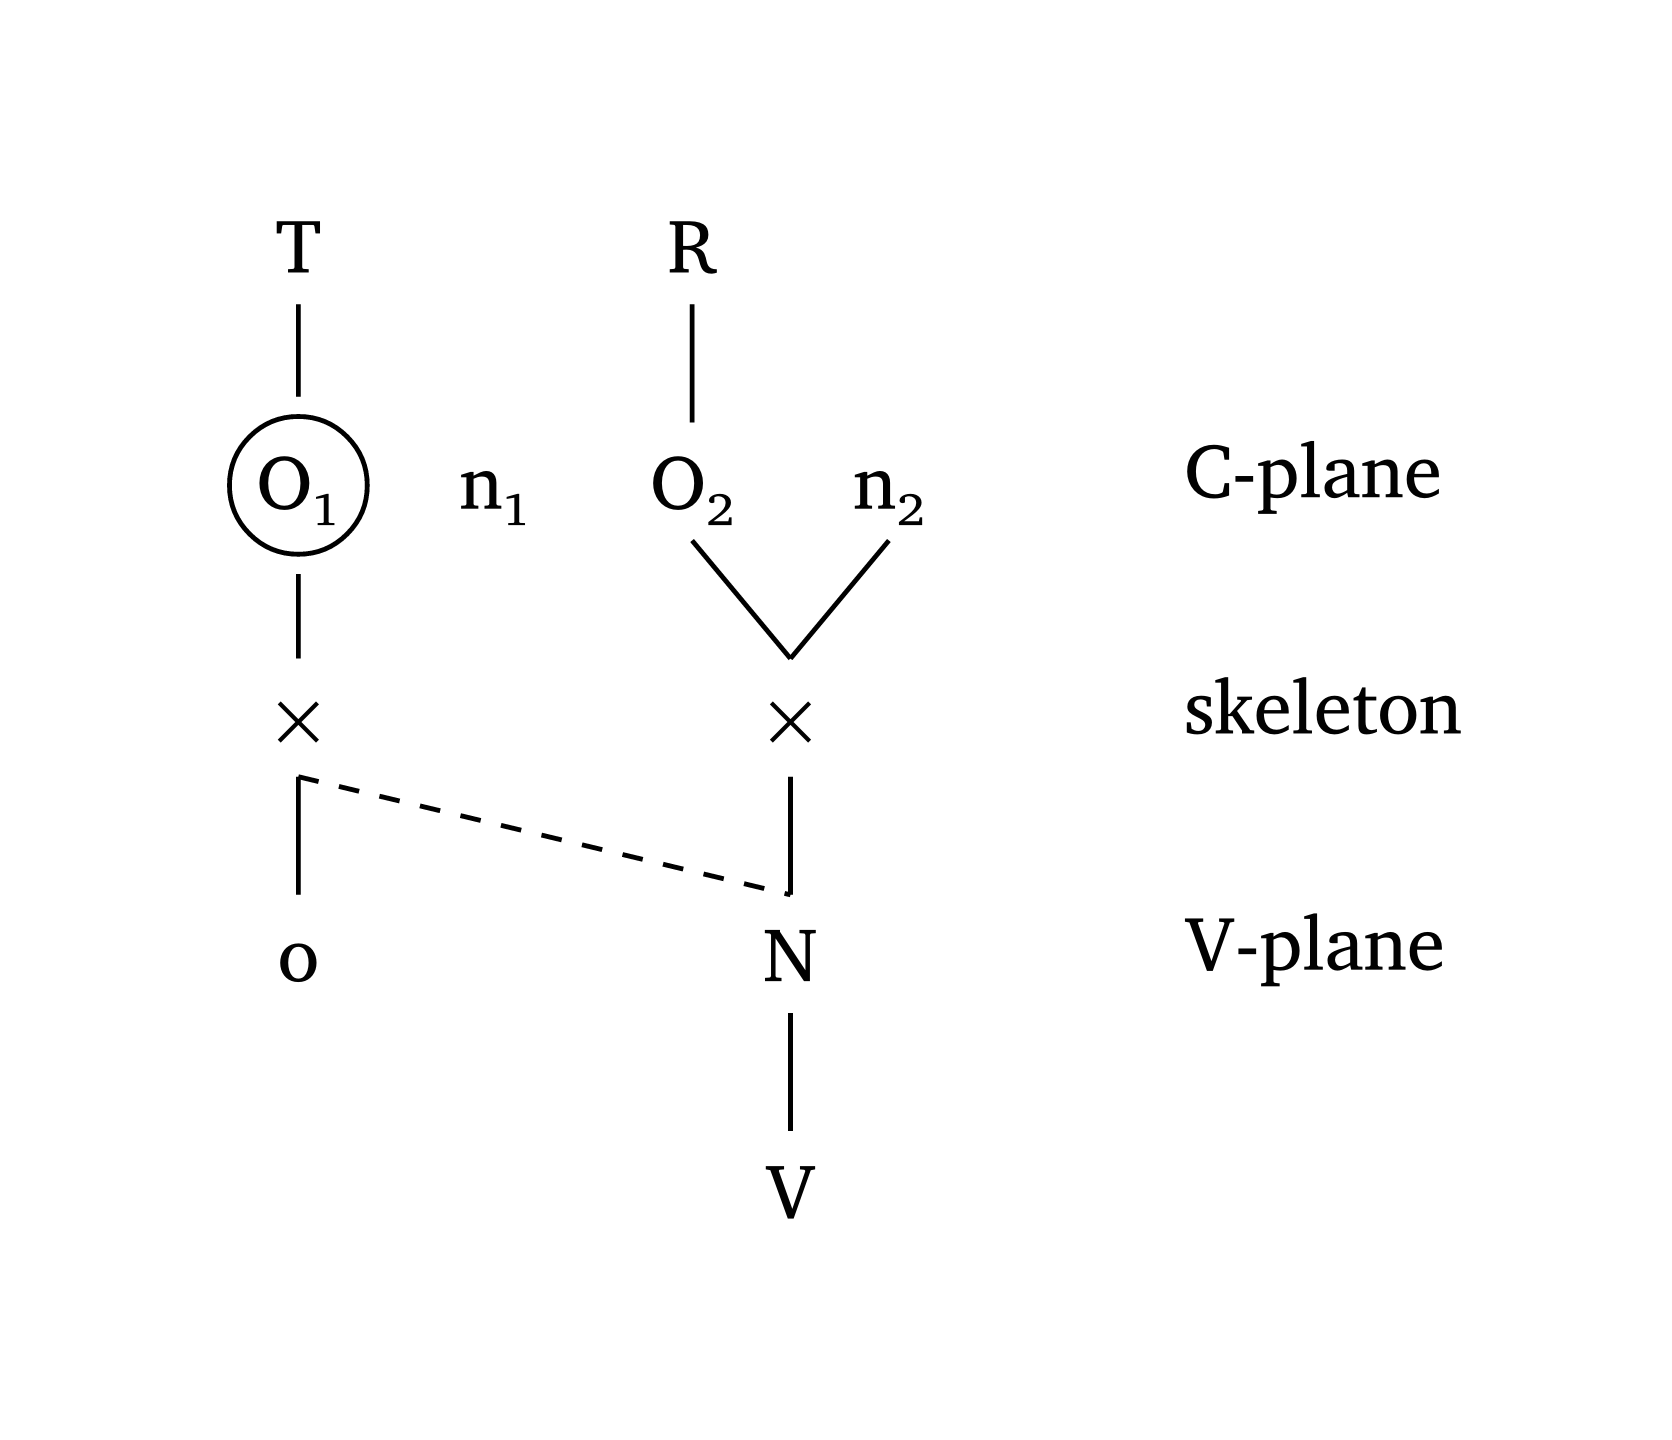
Phonologie du gouvernement
#multi-tier(
  levels: (
    ("O", "R", "", "O", "R", "O", "R"),
    ("", "N1", "", "", "N2", "", "N3"),
    ("", "x", "x", "x", "x", "x", "x"),
    ("", "", "s", "t", "E", "m", ""),
  ),
  links: (("r1", "x2"),),
  ipa: (3,),
  arrows: (
    ("t1", "s1"),
    ("r2", "r1"),
  ),
  arrow-delinks: ((1,)),
  spacing: 1,
)
Phonologie CV avec étiquettes de niveaux
#multi-tier(
  levels: (
    ("T", "", "R", ""),
    ("O1", "n1", "O2", "n2"),
    ("x", "", ("x", 2.5), ""),
    ("o", "", ("N", 2.5), ""),
    ("", "", ("V", 2.5), ""),
  ),
  links: (("n21", "x2"),),
  dashed: (("x1", "n1"),),
  level-spacing: 1.2,
  highlight: ("o11",),
  spacing: 1,
  stroke-width: 0.7pt,
  tier-labels: (
    (1, "C-plane"),
    (2, "skeleton"),
    (3, "V-plane"),
  ),
)
7 Géométrie des traits
La géométrie des traits présente des défis importants, notamment l’interface utilisateur : si trop de degrés de liberté sont disponibles, une fonction devient trop complexe. phonokit offre deux fonctions dédiées : #geom() pour les arbres à segment unique et #geom-group() pour les arbres multiples et les processus.
7.1 Arbres simples
Les arguments de #geom() sont nommés d’après les nœuds qu’ils ajoutent. Si vous ajoutez un nœud \(n\), la fonction construit automatiquement les nœuds parents nécessaires. Par exemple, ajouter voice: true ajoute également [laryngeal] ; ajouter anterior: true ajoute également [coronal]. Les arguments acceptent les valeurs booléennes et les chaînes : nasal: true ajoute [nasal], tandis que nasal: "+" ajoute [+nasal].
Figure 33 reproduit la représentation consonantique complète de Clements et Hume (1995, 292).
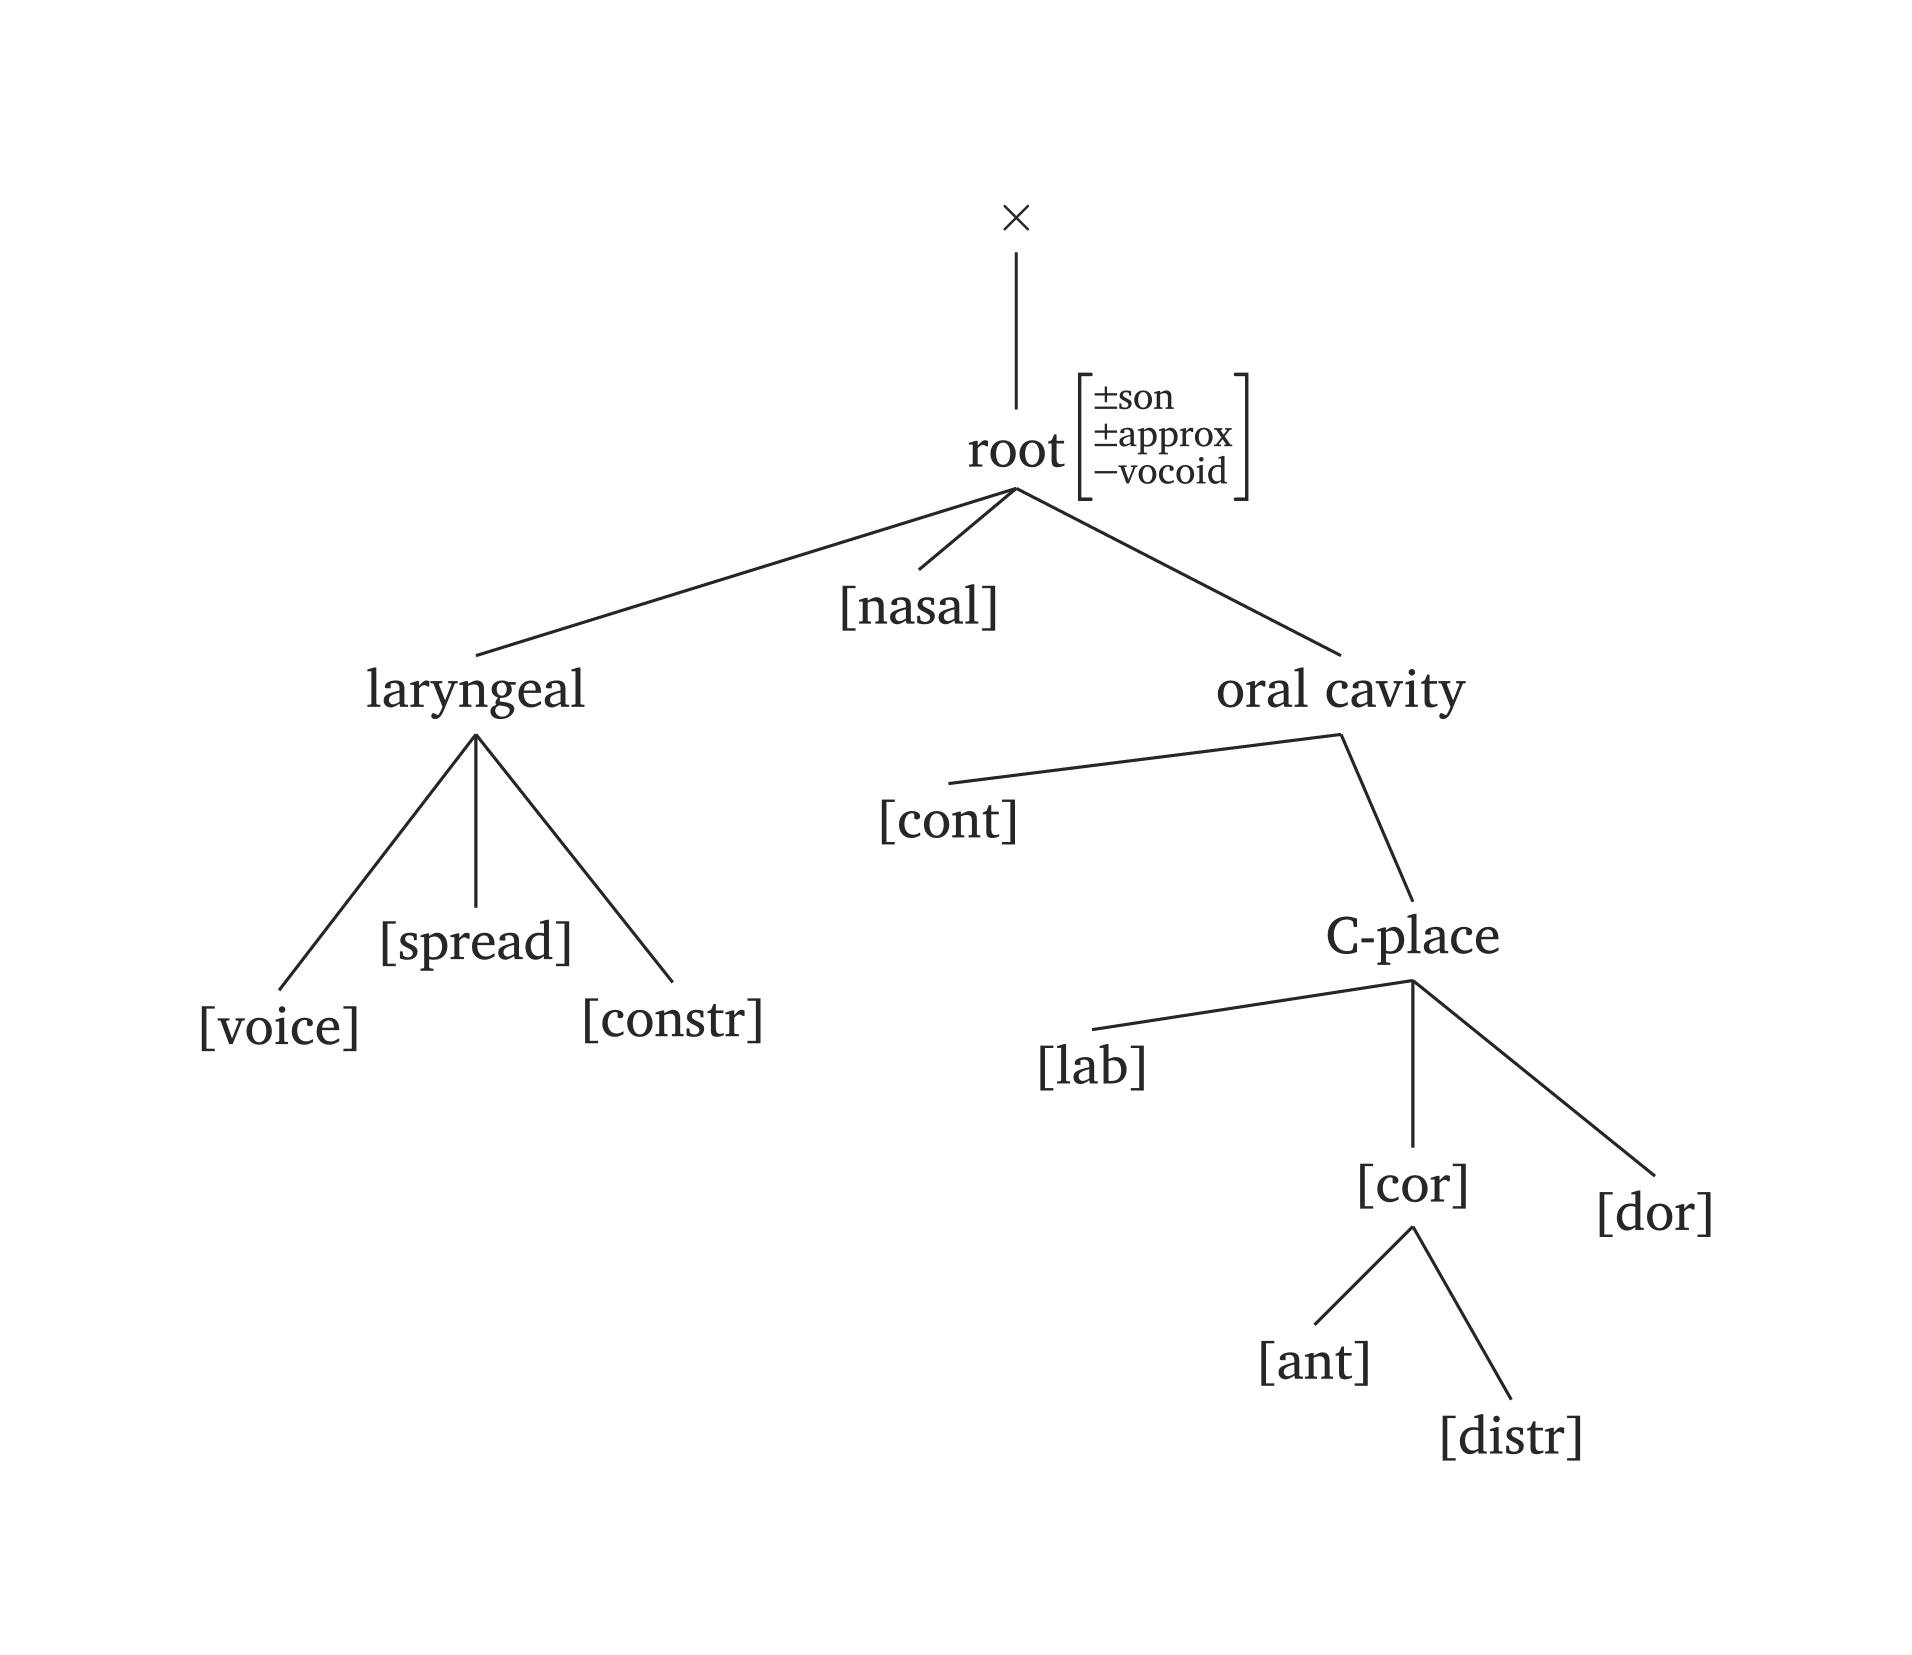
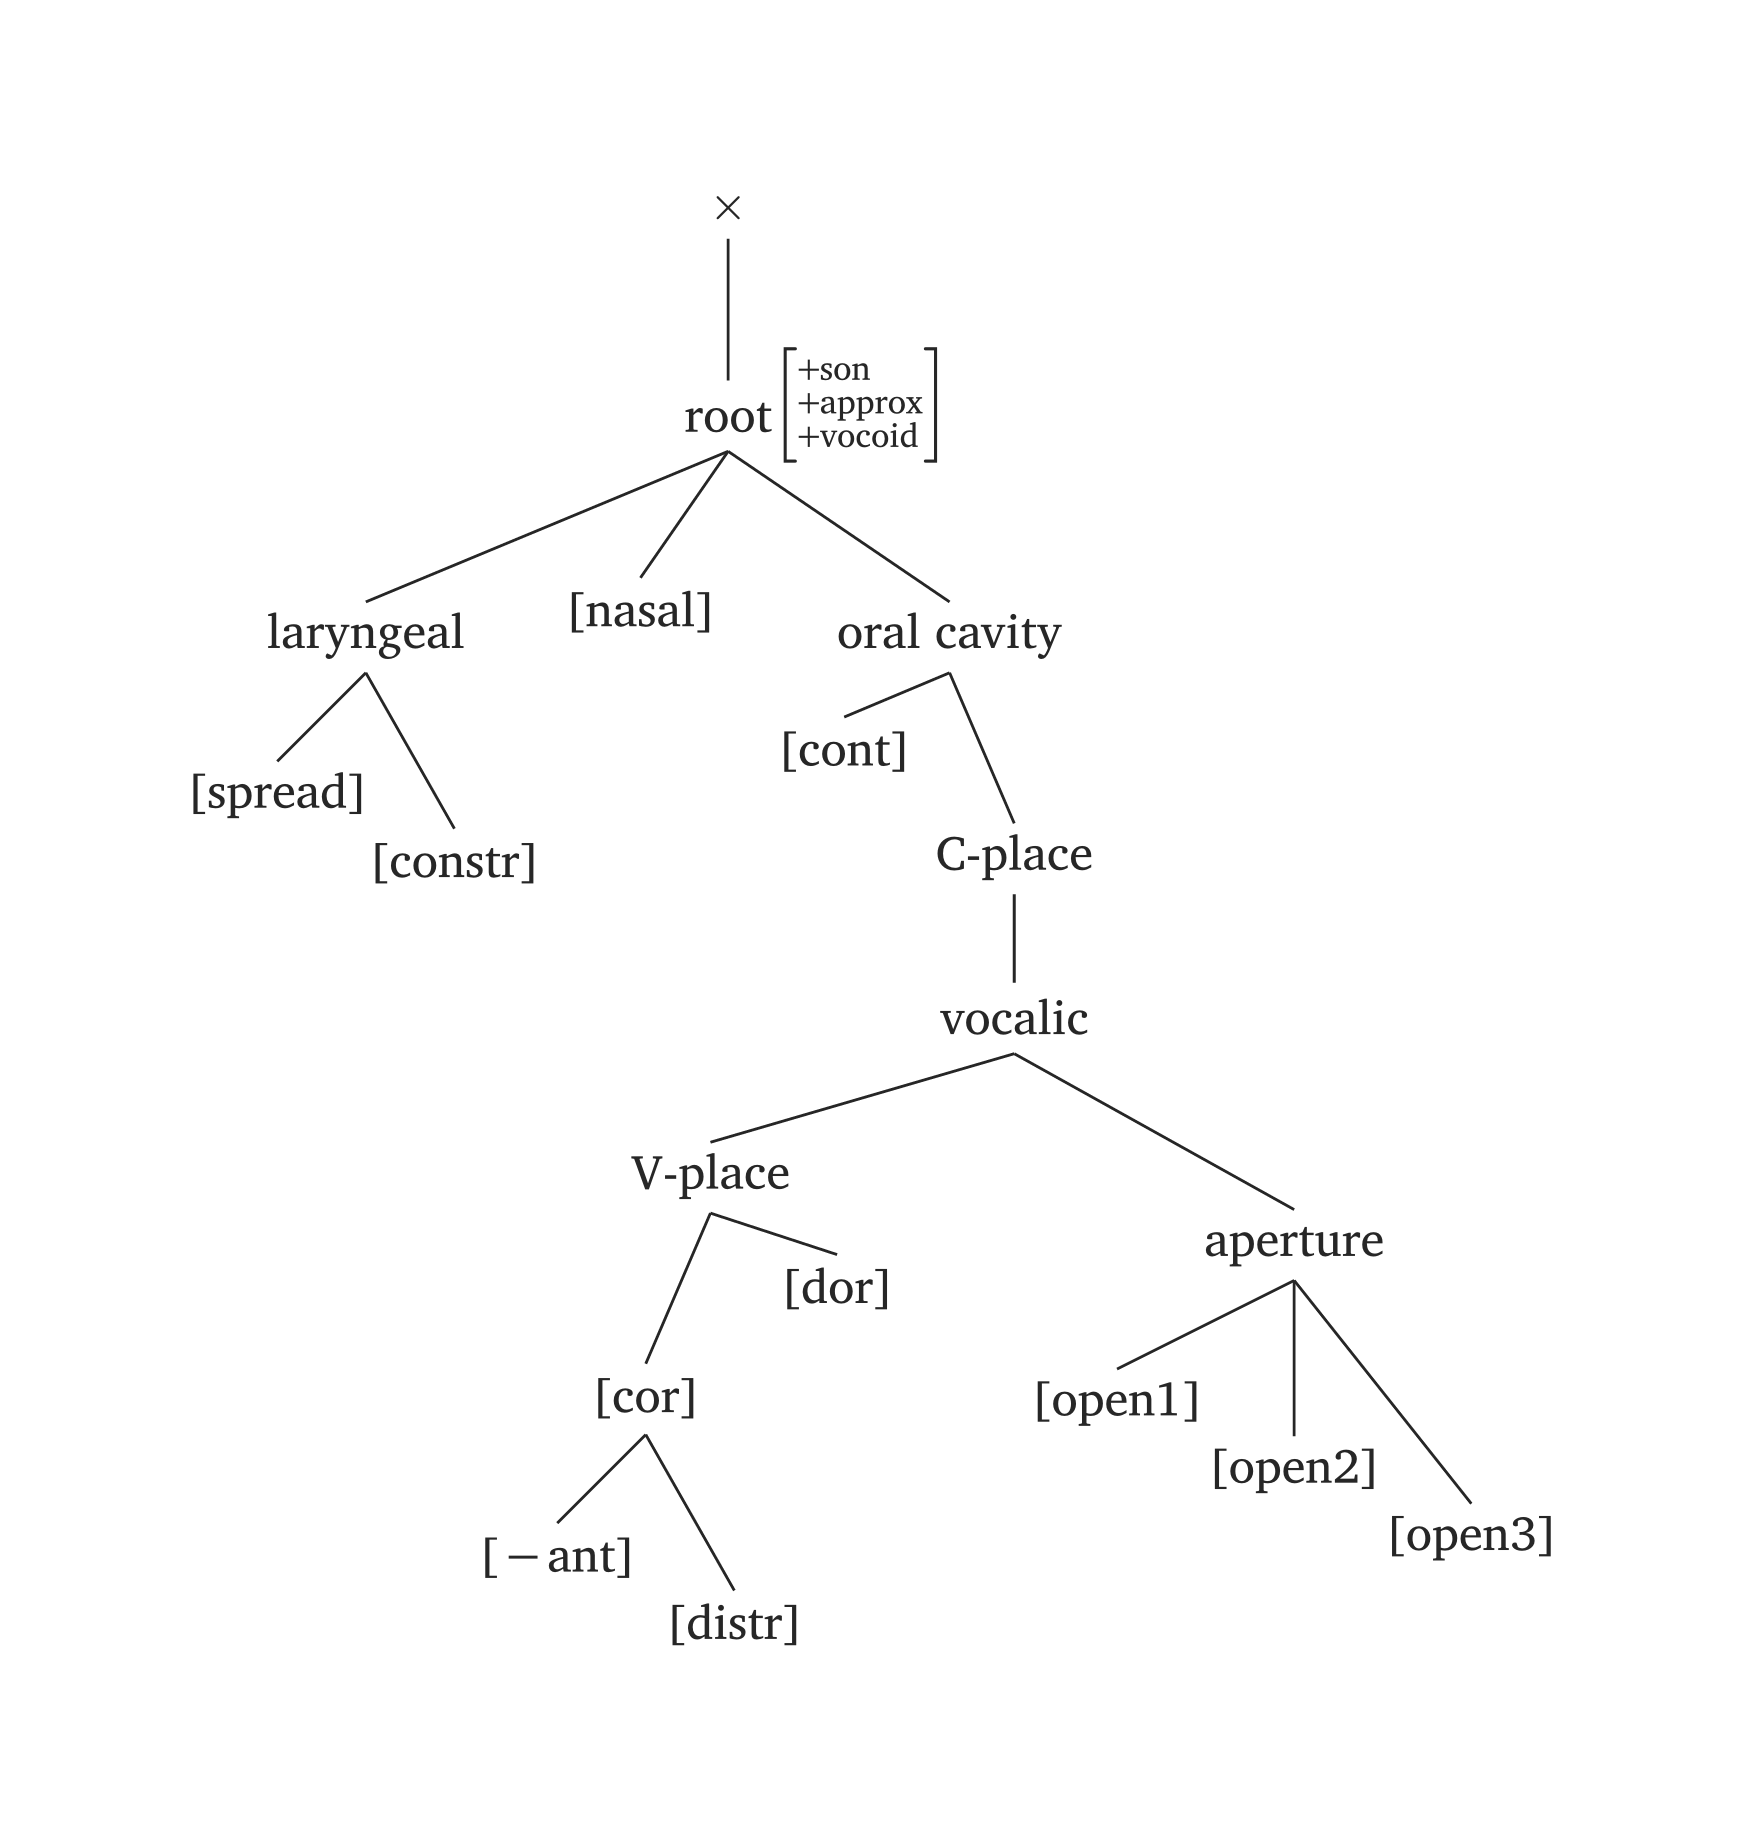
Géométrie des traits consonantiques complète
#geom(
  root: ("±son", "±approx", "-vocoid"),
  spread: true,
  constricted: true,
  nasal: true,
  voice: true,
  labial: true,
  anterior: true,
  distributed: true,
  dorsal: true,
  continuant: true,
)
Géométrie des traits vocaliques complète
#geom(
  root: ("+son", "+approx", "+vocoid"),
  spread: true,
  constricted: true,
  nasal: true,
  vplace: true,
  aperture: (true, true, true),
  coronal: true,
  anterior: "-",
  distributed: true,
  dorsal: true,
  continuant: true,
  scale: 0.9,
)
Plusieurs phonèmes sont prédéfinis dans #geom() via l’argument ph, en utilisant les mêmes conventions que #ipa(). Dans les figures ci-dessous, seul le code #geom(ph: "...") est nécessaire. Vous noterez également les unités temporelles ajoutées par défaut (x). Vous pouvez désactiver les unités temporelles en ajoutant timing: false, ou ajouter des mores à la place (timing: "mora" ou timing: "mu"). L’argument timing accepte également un tableau pour les voyelles longues : timing: ("x", "x"). Par exemple, si vous préférez les mores aux cases x, vous ajouteriez timing: ("mora", "mora") pour la voyelle longue dans Figure 36.
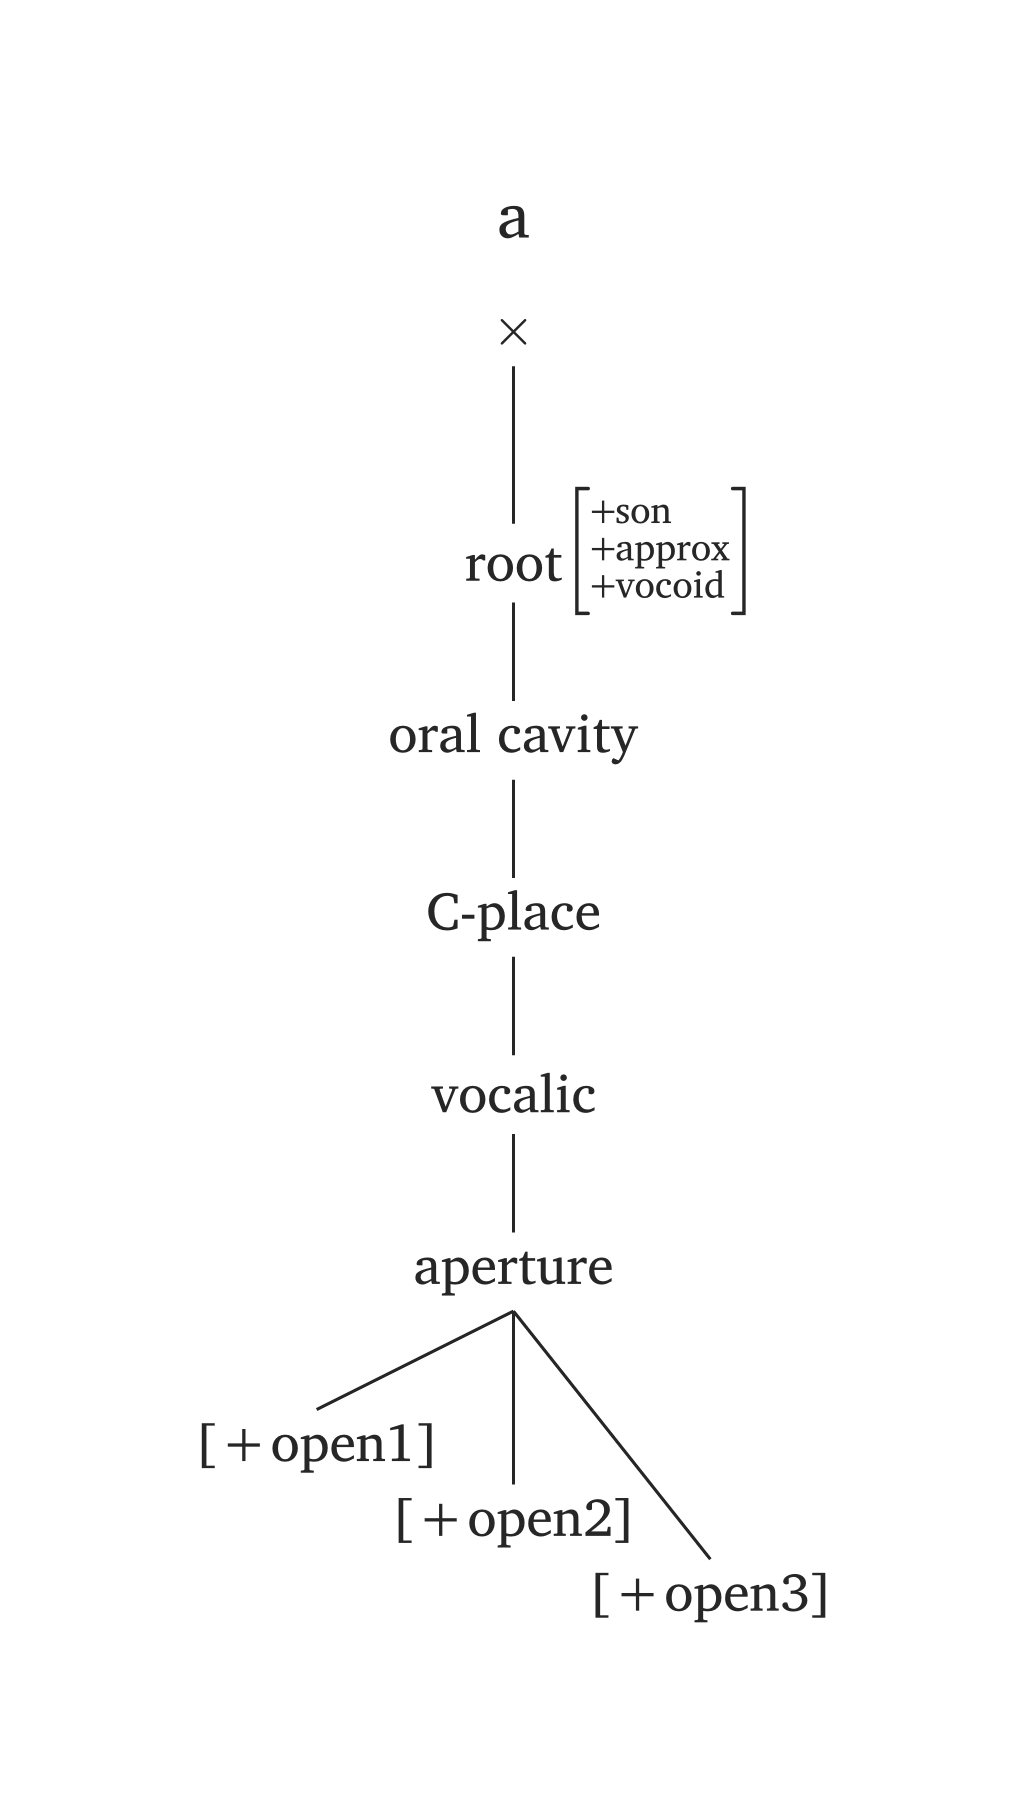
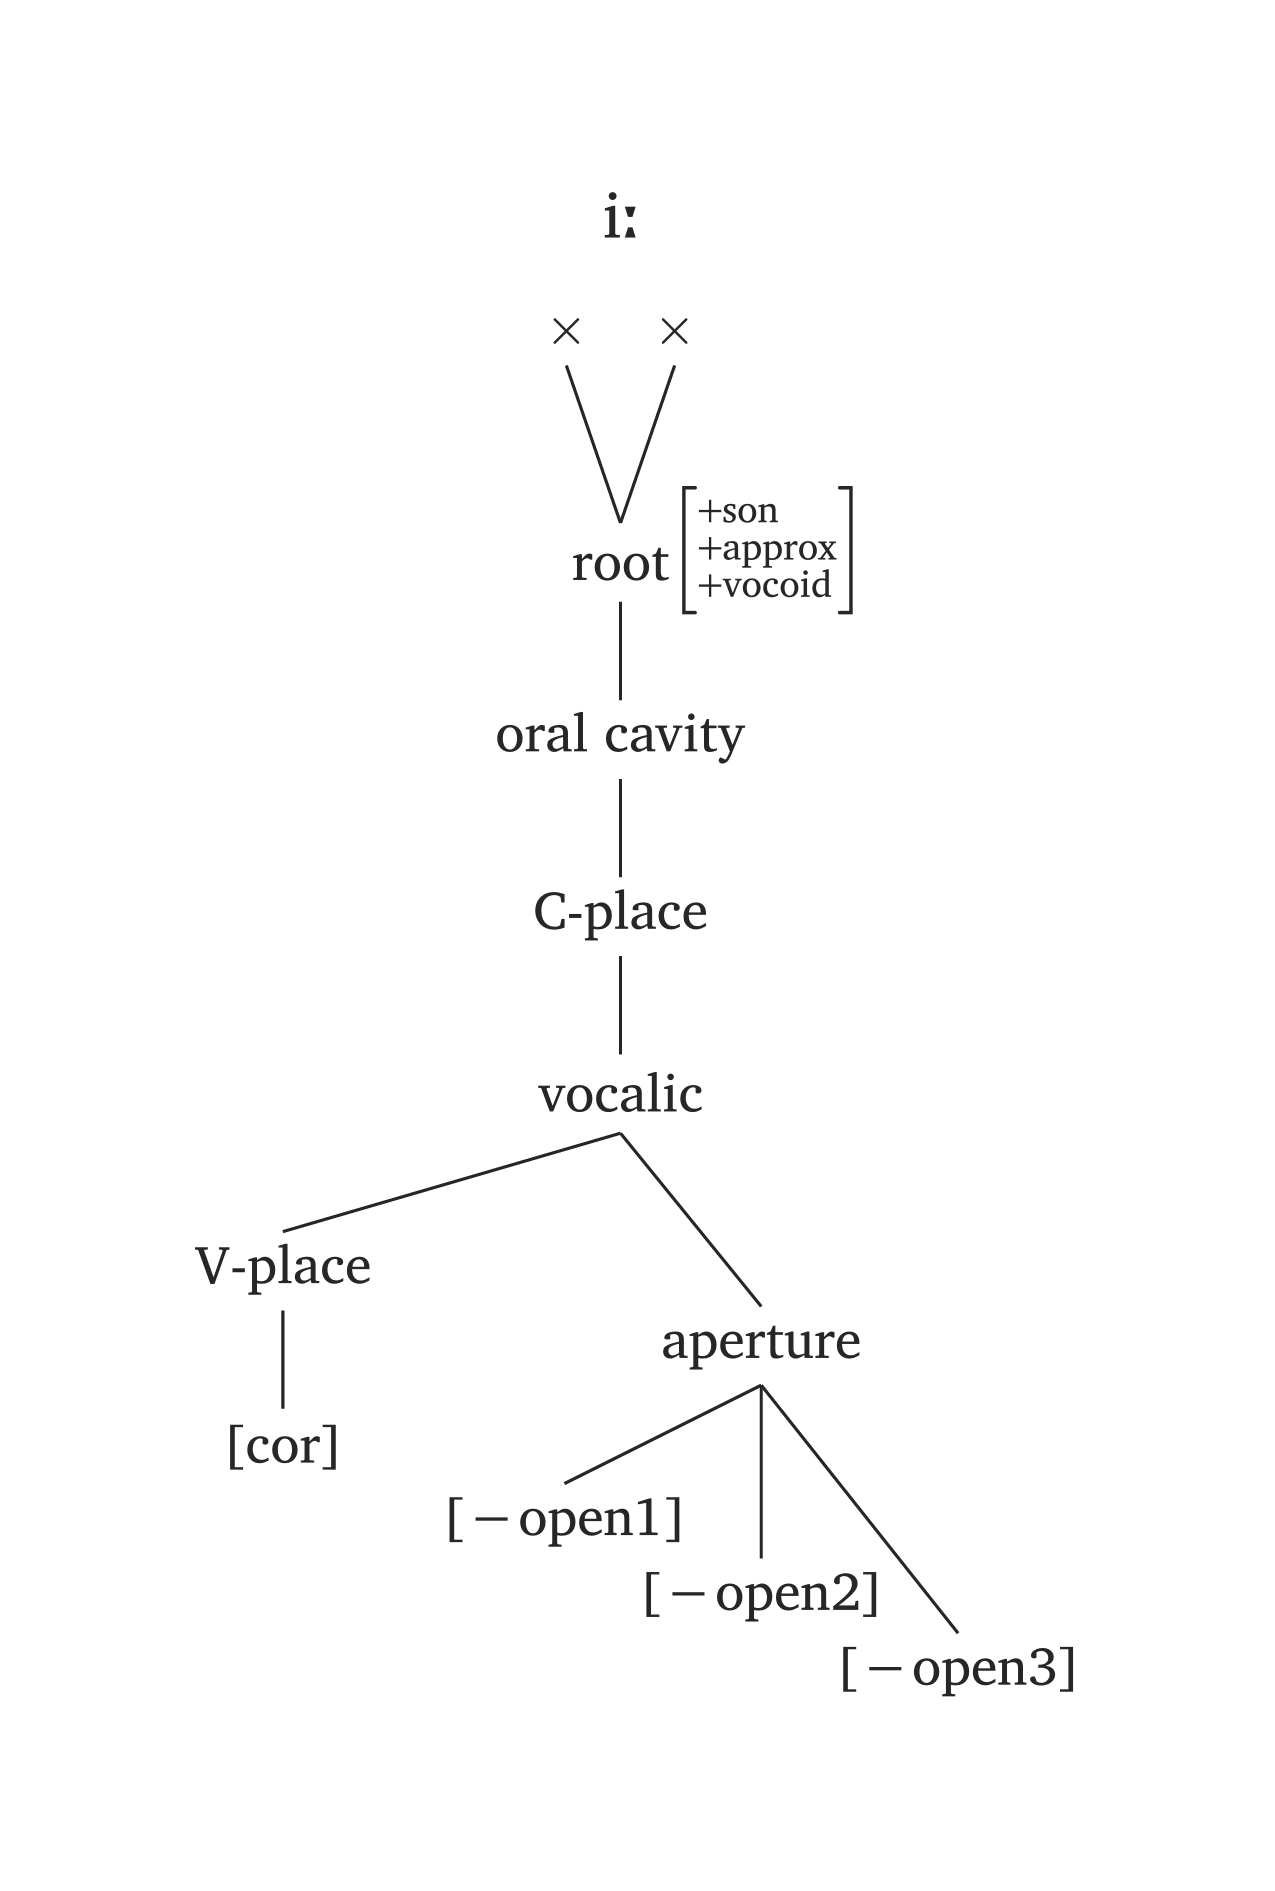
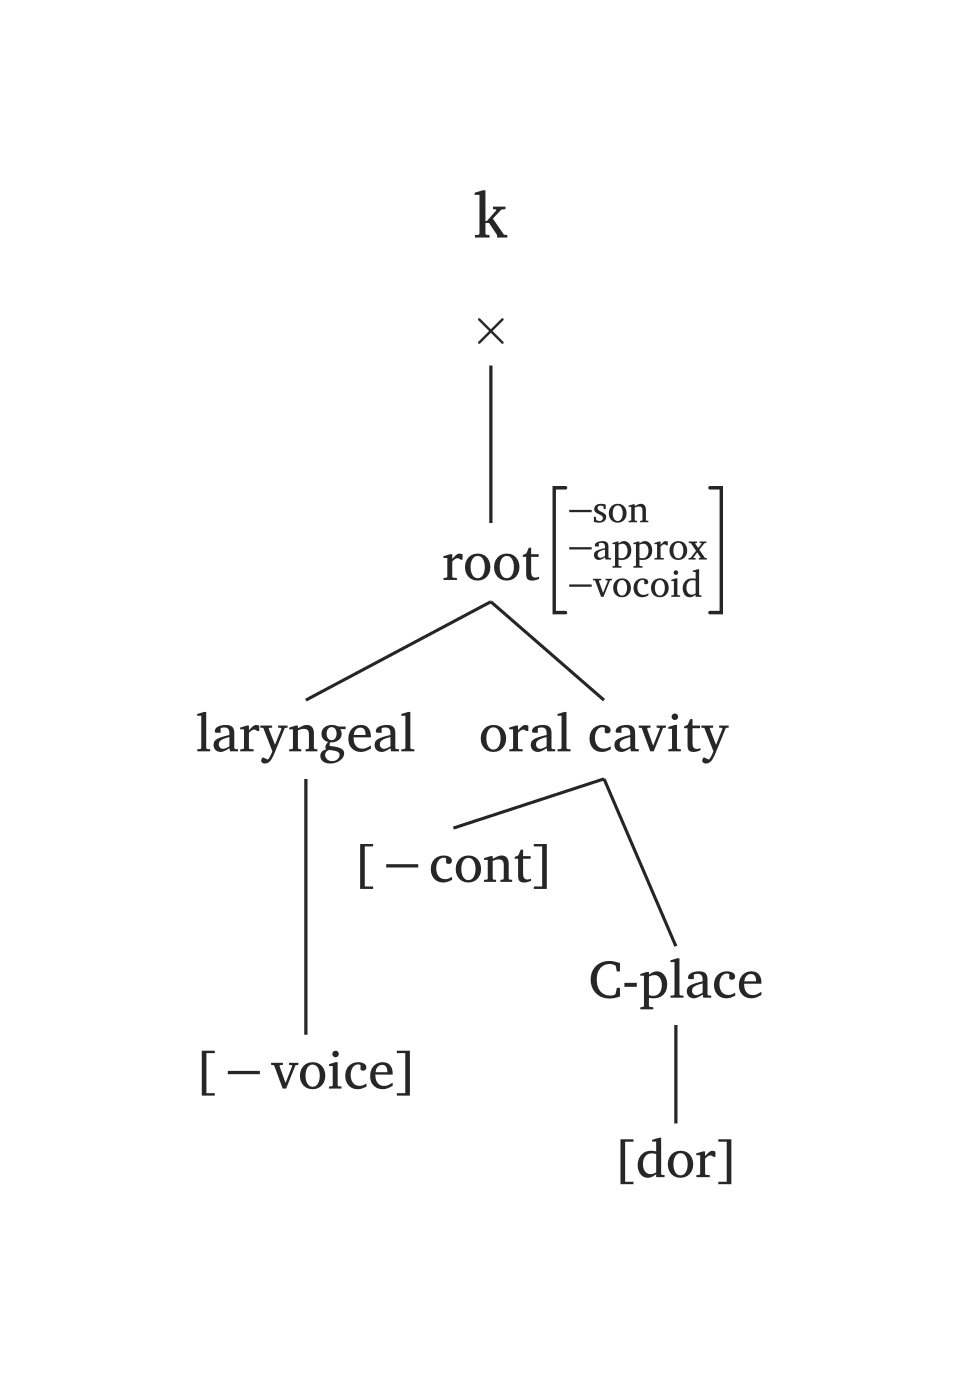
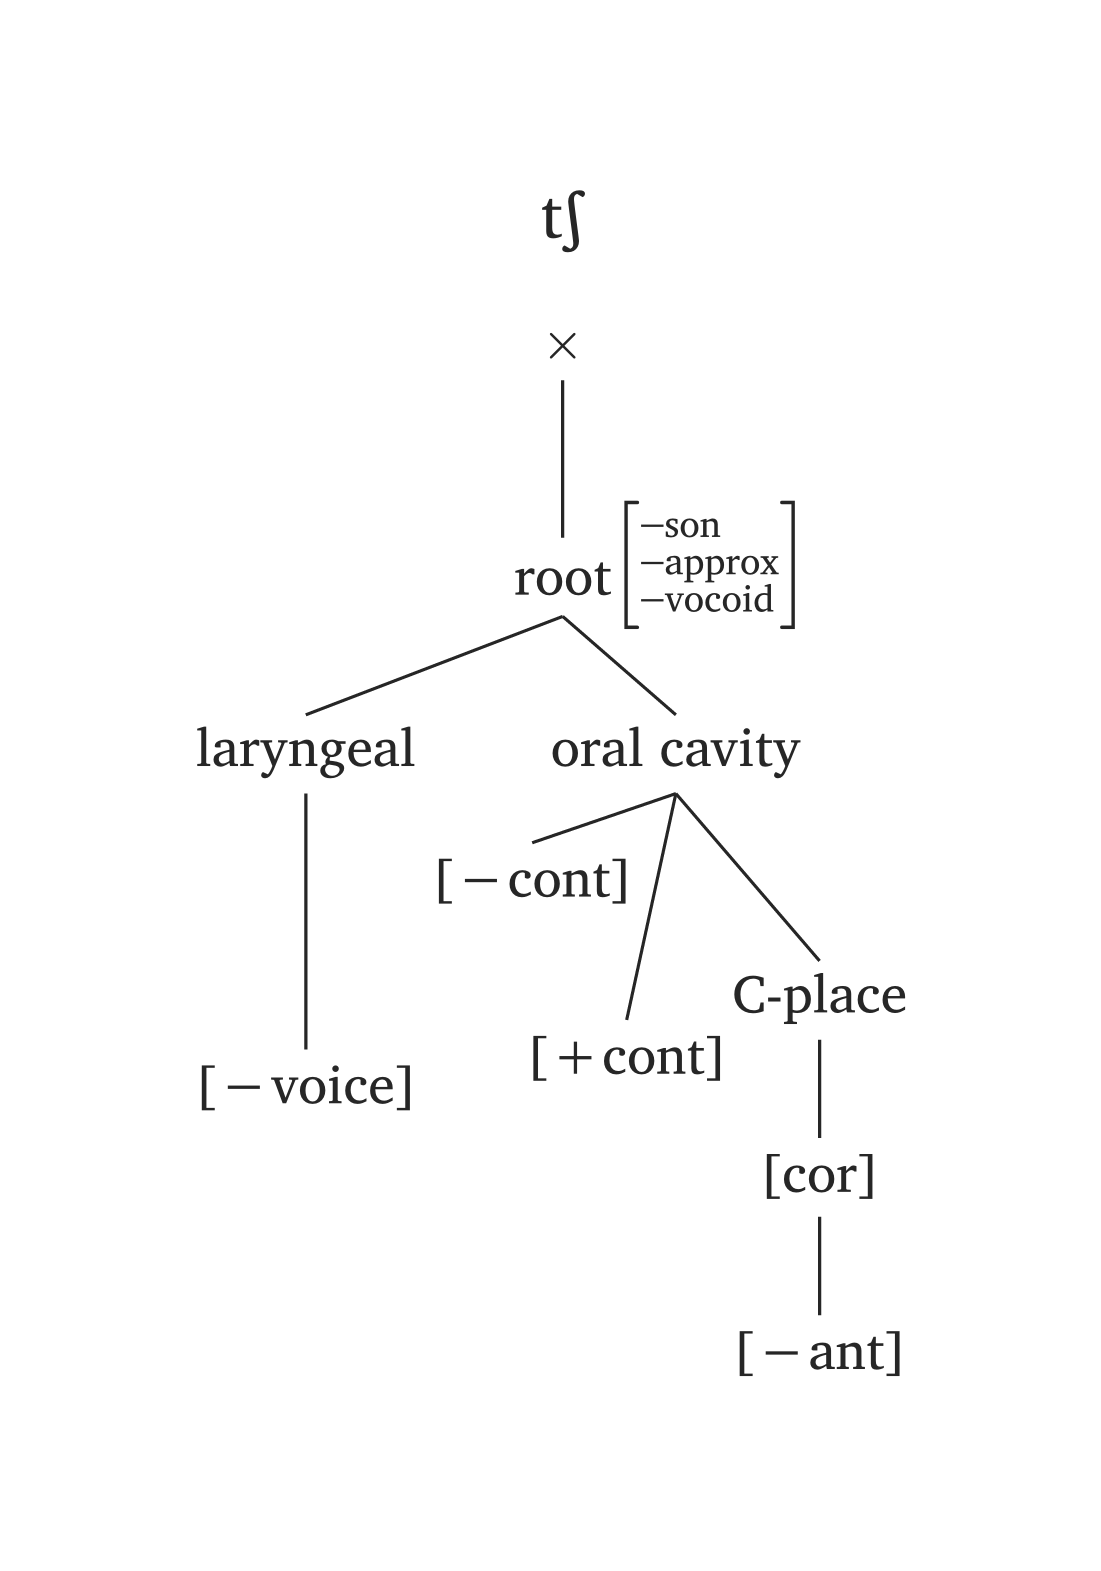
L’argument ph offre une syntaxe minimale, mais vous n’êtes pas limité aux prédéfinis. N’importe quel nœud peut être remplacé : par exemple, #geom(ph: "a", aperture: (true,)) remplace uniquement la spécification d’aperture pour le prédéfini /a/.
7.2 Arbres multiples
La fonction #geom-group() fonctionne comme un encapsuleur pour « coller » plusieurs arbres #geom() ensemble, permettant des flèches entre les arbres. Les arguments supplémentaires clés sont arrows, curved et delinks.
Les flèches référencent les nœuds par nom avec un indice d’arbre : "nasal2" fait référence à [nasal] dans l’arbre 2, "root1" à la racine dans l’arbre 1. L’argument ctrl ajuste les points de contrôle de la courbe de Bézier (directions de début et de fin). Figure 39 montre la propagation de [nasal].
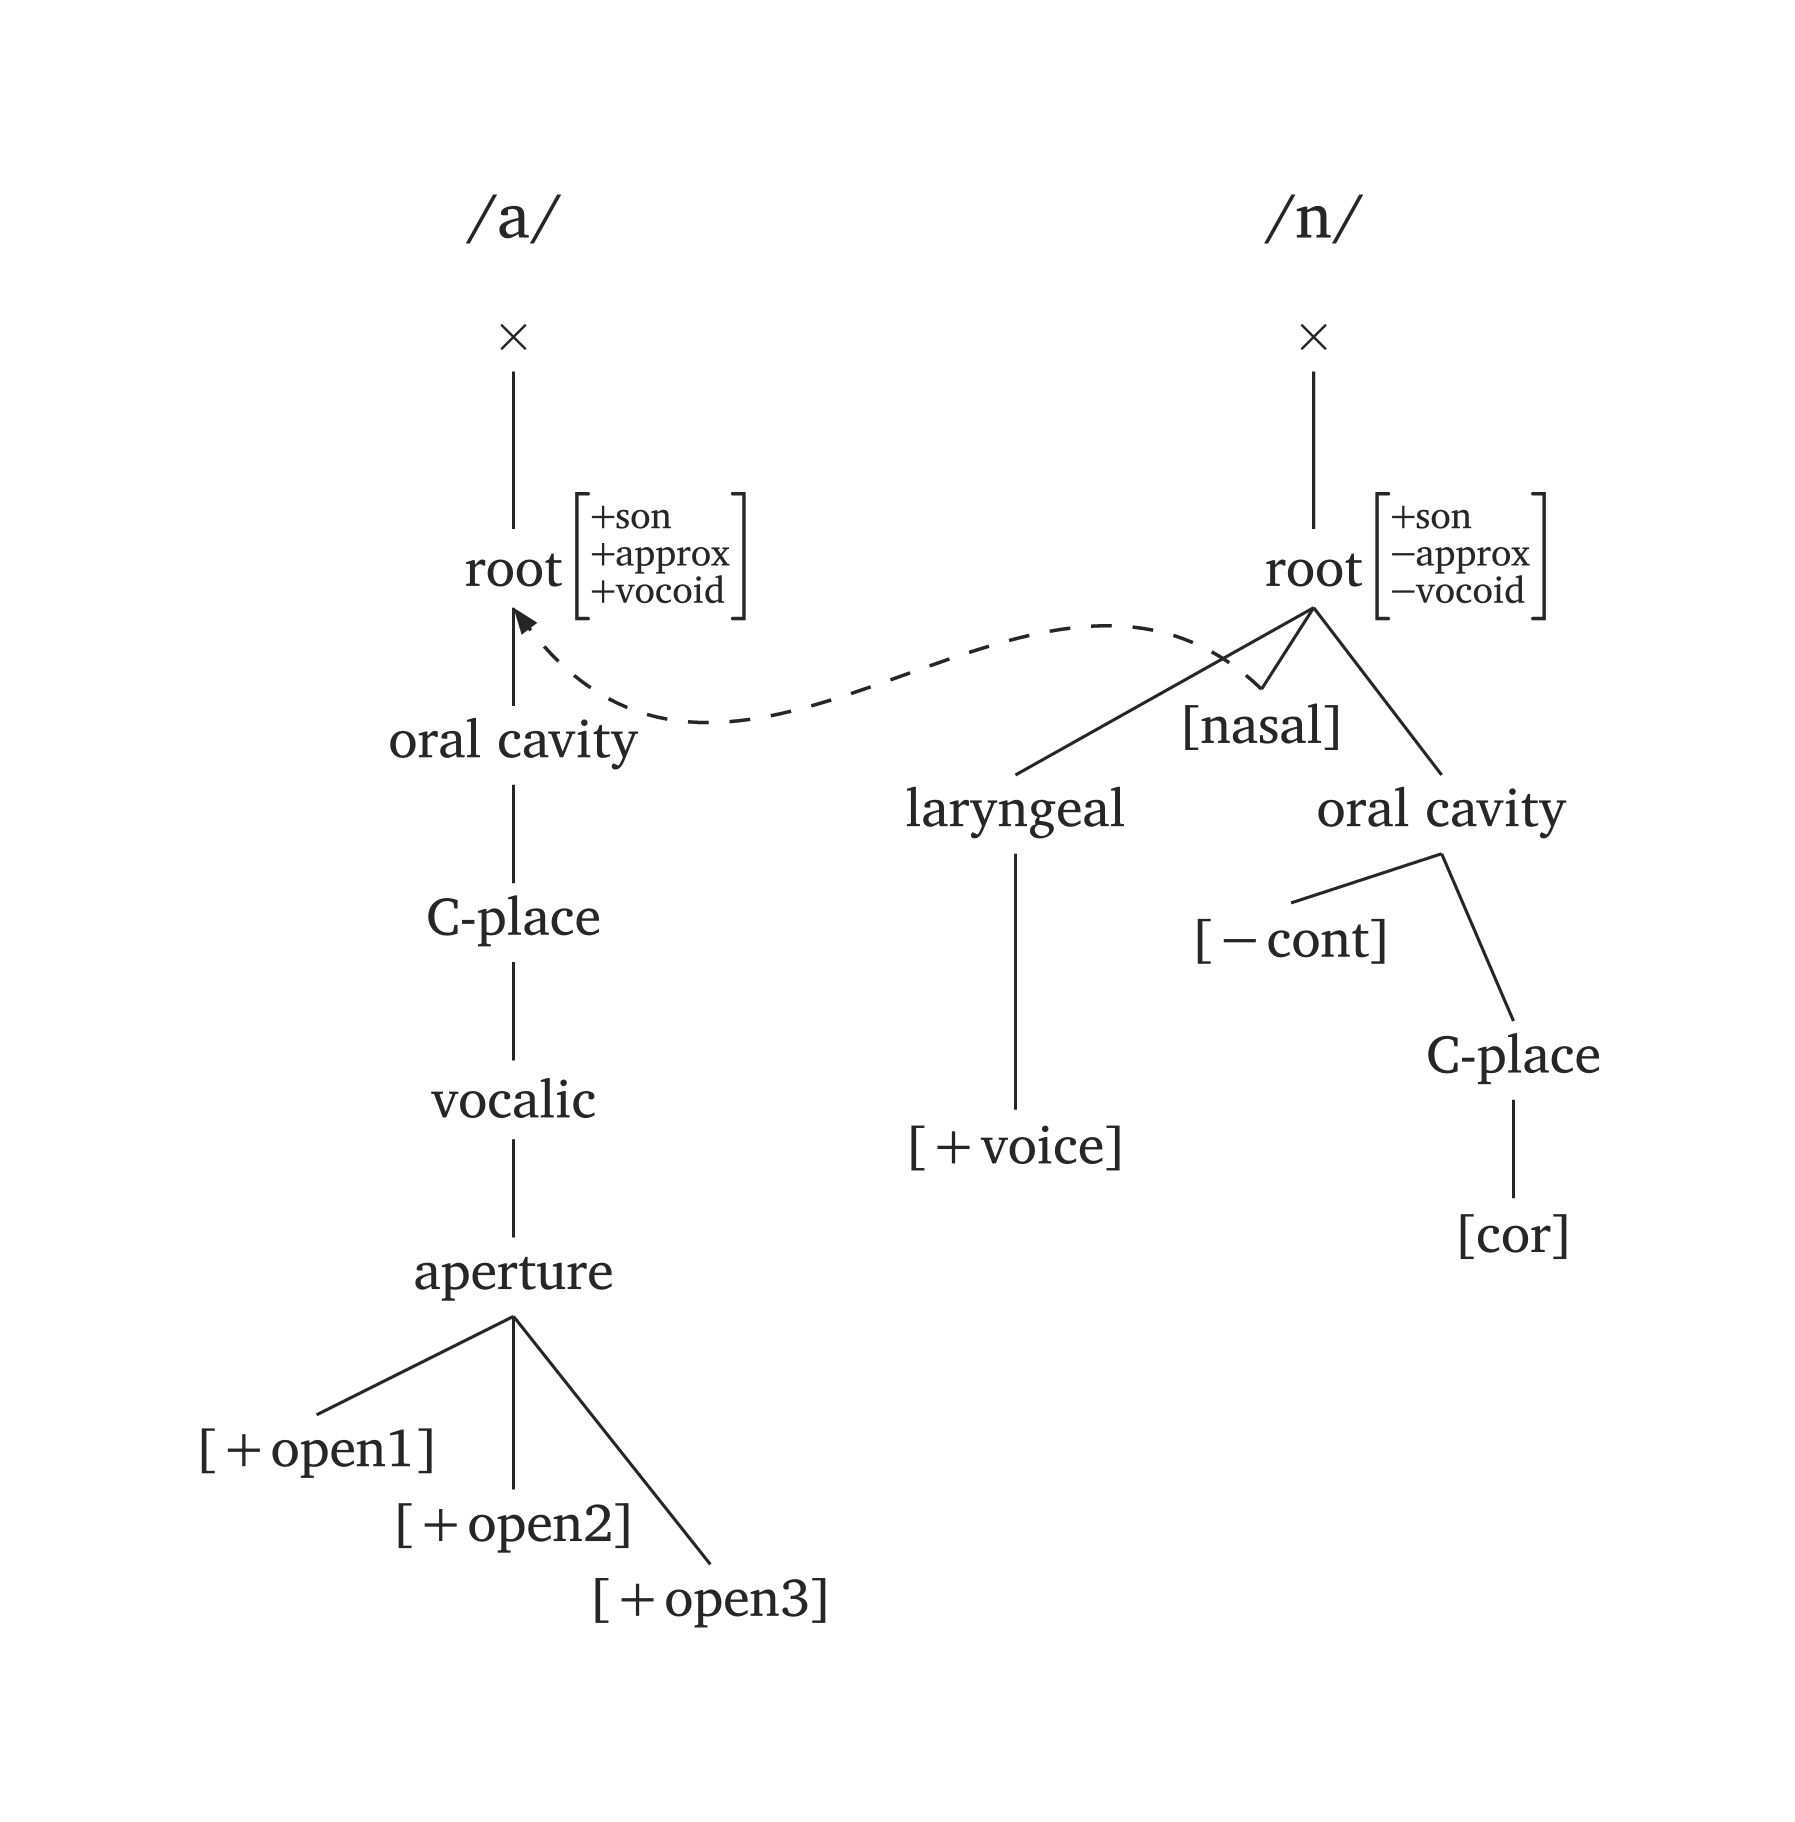
Nasalisation
#geom-group(
  (ph: "/a/"),
  (ph: "/n/"),
  arrows: (
    (from: "nasal2",
     to: "root1",
     ctrl: (1.1, -1.5)),
     ),
  curved: true,
  gap: 1,
)
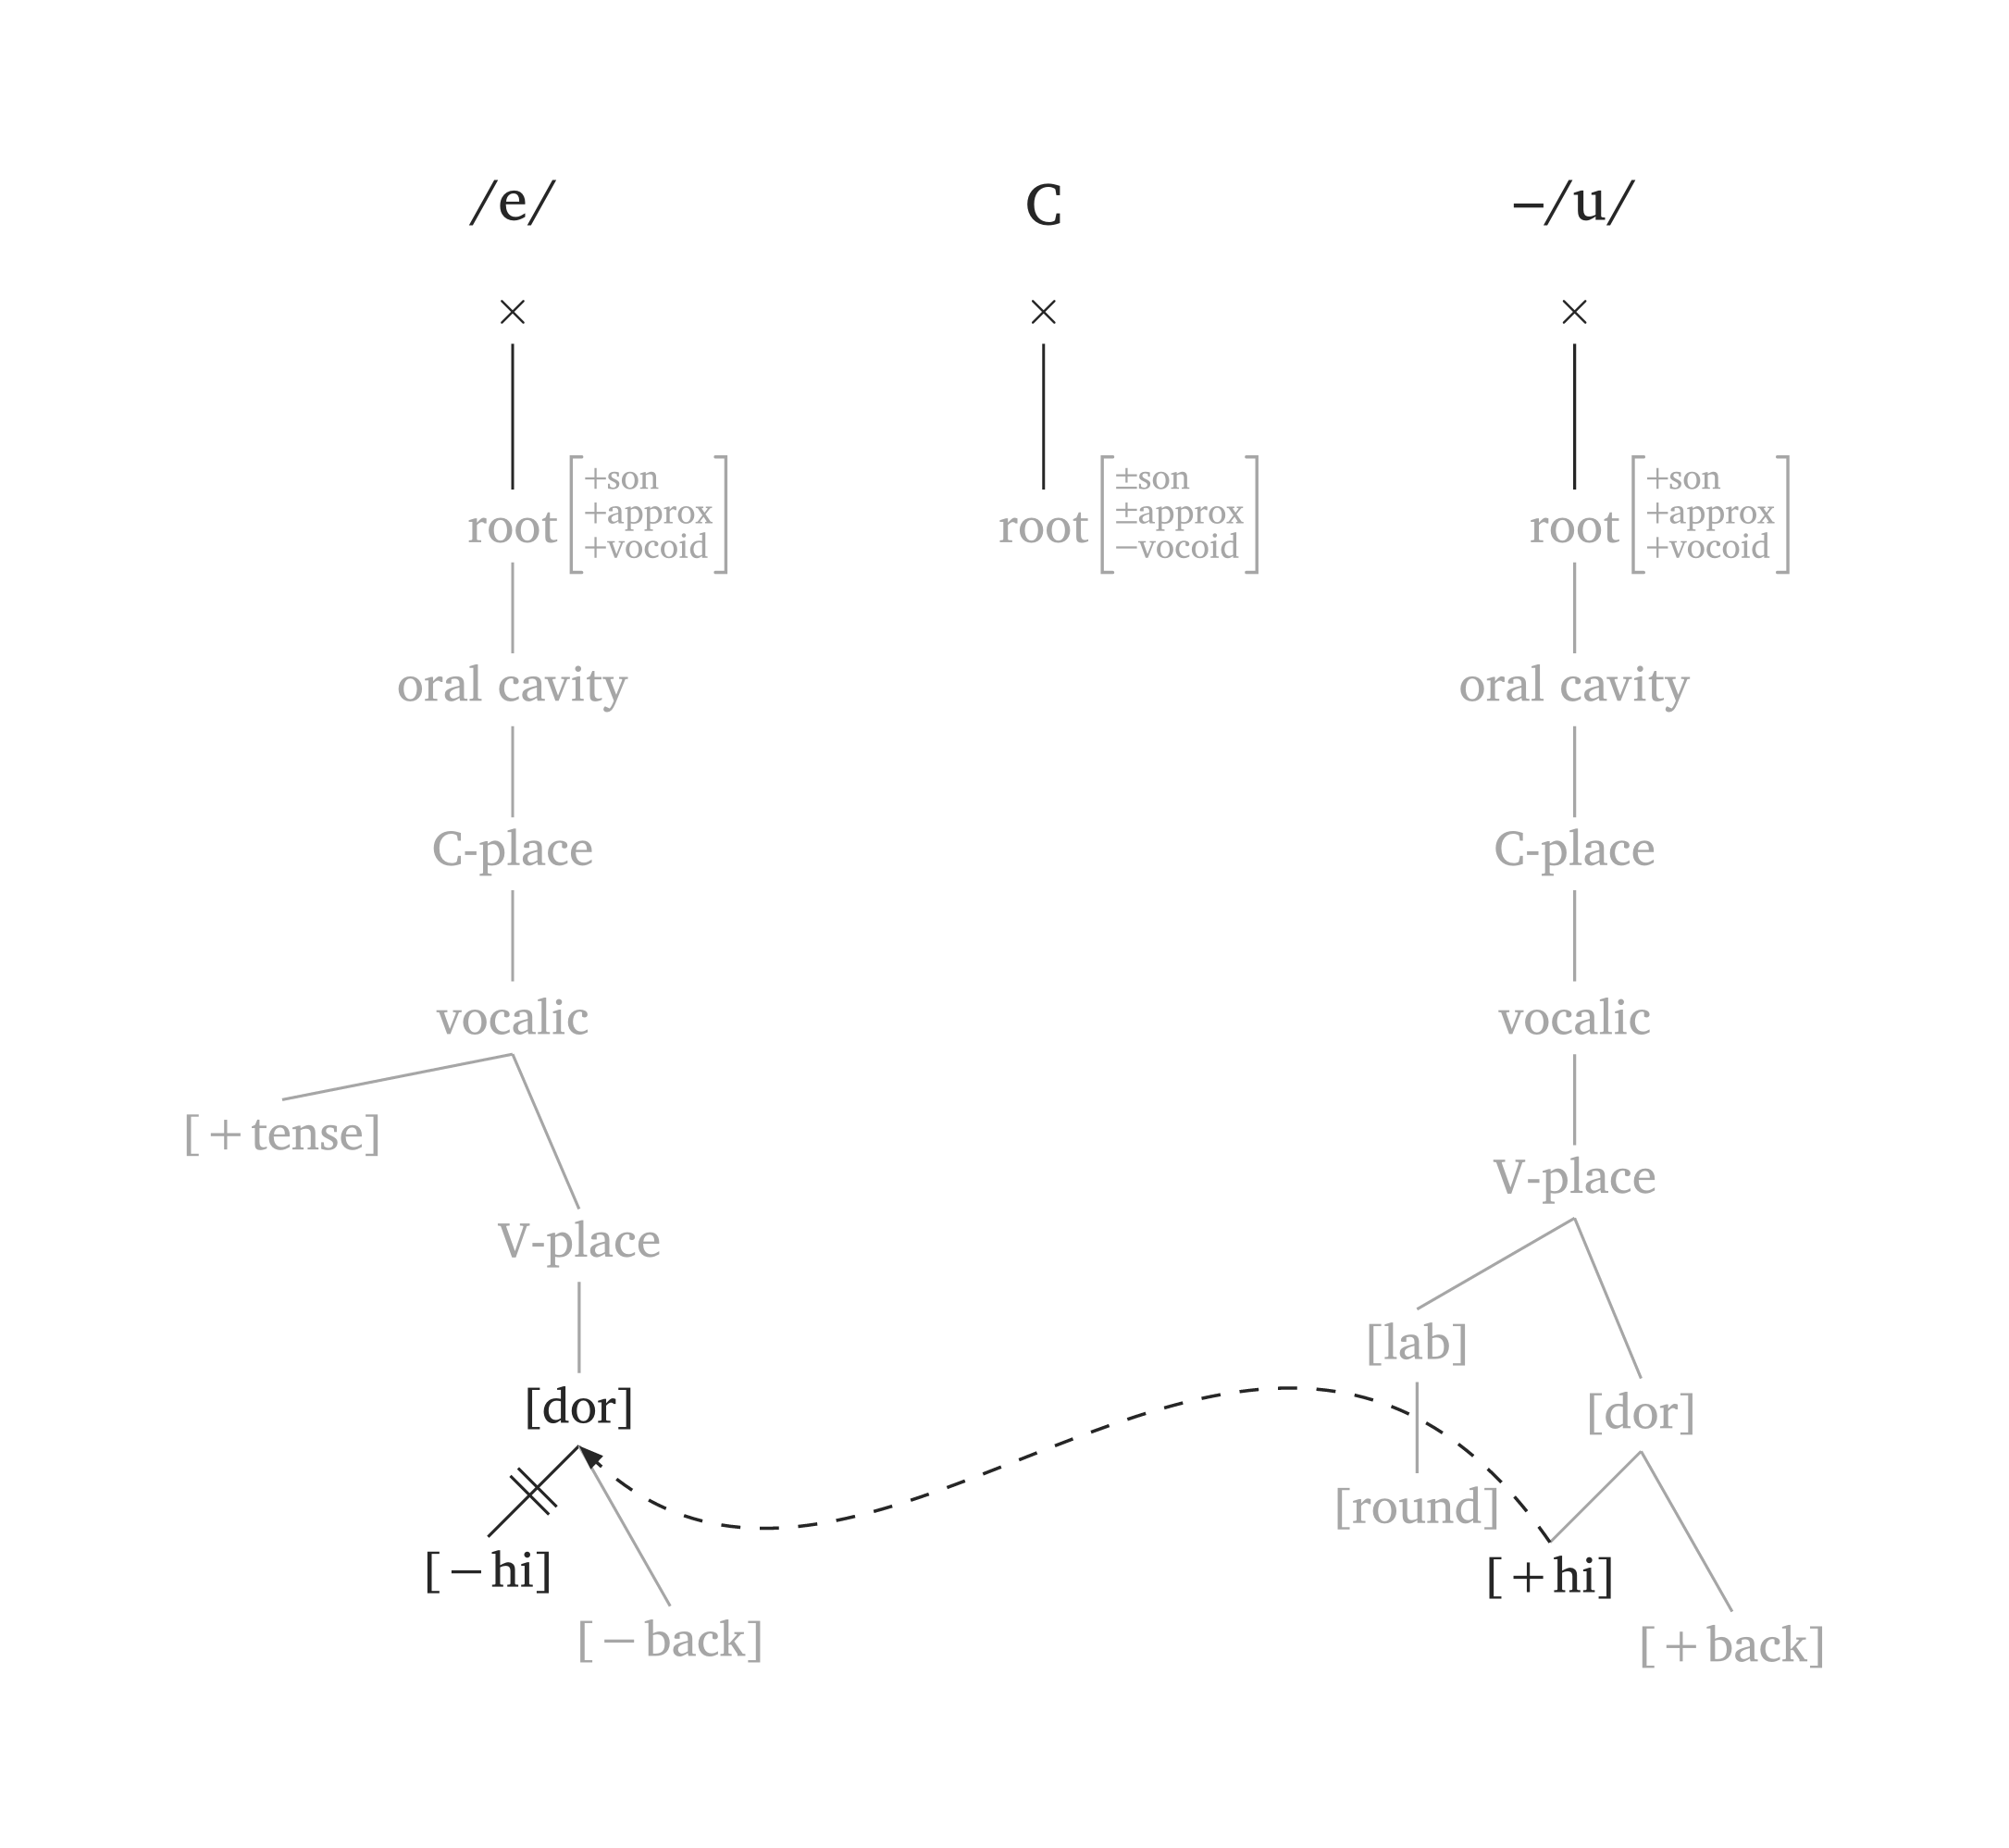
Par défaut, #geom() utilise le modèle de Clements et Hume (1995). Définir model: "sagey" utilise les traits de hauteur (Sagey 1986) au lieu de l’aperture. L’argument highlight assombrit la représentation entière et ne met en évidence que les nœuds spécifiés. Figure 40 illustre la métaphonie où /e/ → [i] / __ C₀ /u/ :
Métaphonie (modèle Sagey)
#geom-group(
  (ph: "/e/"),
  (ph: "\\C"),
  (ph: "/u/", prefix: "-"),
  arrows: (
    (from: "high3", to: "dorsal1", ctrl: (2.3, -1.5)),
  ),
  delinks: ("high1",),
  highlight: ("high1", "dorsal1", "high3"),
  gap: 1.5,
  model: "sagey",
)
8 Théorie de l’Optimalité
La fonction #tableau() génère des tableaux OT (Prince et Smolensky 1993). Elle prend six arguments : input, candidates, constraints, violations, winner et dashed-lines. L’argument violations requiert une structure imbriquée. winner et dashed-lines comptent tous deux à partir de zéro : winner: 0 sélectionne le premier candidat, et dashed-lines: (0,) met en pointillés la ligne après la première contrainte (utilisez dashed-lines: () pour n’en avoir aucune). Les cellules sont automatiquement grisées après une violation fatale (!), et le symbole du doigt pointeur ☞ est ajouté pour le gagnant.
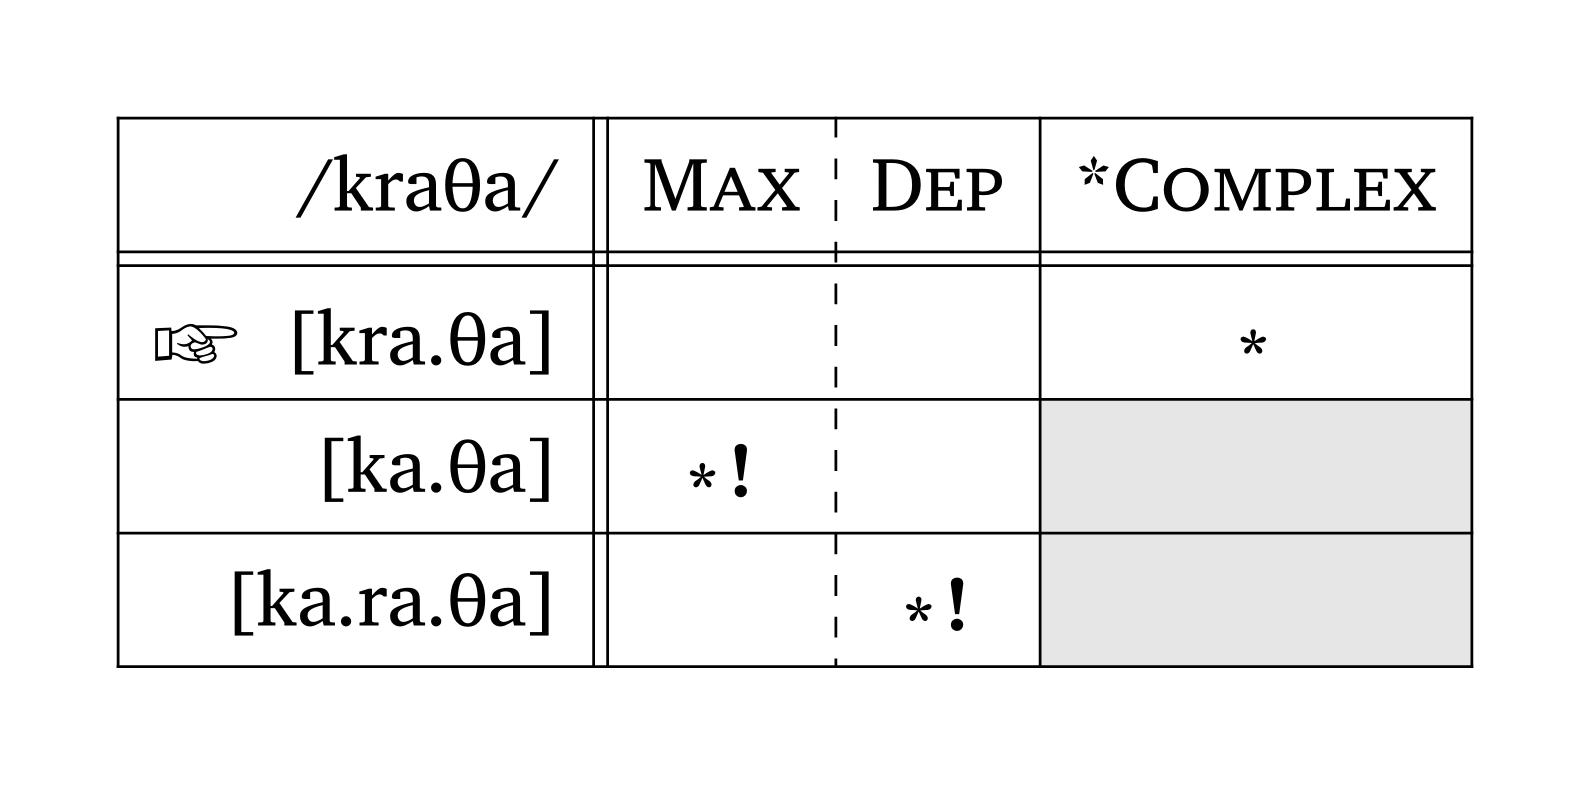
Tableau OT
#tableau(
  input: "/kraTa/",
  candidates: ("[kra.Ta]", "[ka.Ta]", "[ka.ra.Ta]"),
  constraints: ("Max", "Dep", "*Complex"),
  violations: (
    ("", "", "*"),
    ("*!", "", ""),
    ("", "*!", ""),
  ),
  winner: 0,        // position of winning candidate
  dashed-lines: (0,), // note the comma
  shade: true,      // true by default
  letters: true,     // a., b., c., ...
)
Une fonctionnalité intéressante de #tableau() est que la fonction grise automatiquement les cellules dès qu’une violation fatale est saisie (!). De même, elle ajoute le symbole « ☞ » pour le gagnant, dont la position est extraite de l’argument winner. Les candidats peuvent également être étiquetés avec des lettres (a., b., c., …) en définissant letters: true. Lorsque les lettres sont utilisées, le symbole ☞ est placé à gauche de la lettre du candidat gagnant.
De plus, #tableau() prend en charge les structures prosodiques comme candidats.1 Vous pouvez passer des appels de fonctions prosodiques en tant que contenu en utilisant des crochets, par ex., [#syllable("mat")]. Cette approche est recommandée car elle évite les conflits avec le caractère de guillemet simple, qui est également utilisé pour le marquage de l’accent dans la notation prosodique. Figure 42 montre un exemple avec des candidats #word(). Lorsque vous passez du contenu directement, vous contrôlez l’échelle via l’argument scale de la fonction elle-même (ceci est important car les structures prosodiques sont souvent trop grandes pour un tableau). Figure 42 montre également l’argument gloss au cas où davantage d’informations seraient nécessaires pour l’input. Cet argument requiert deux chaînes de caractères (forme orthographique et traduction).
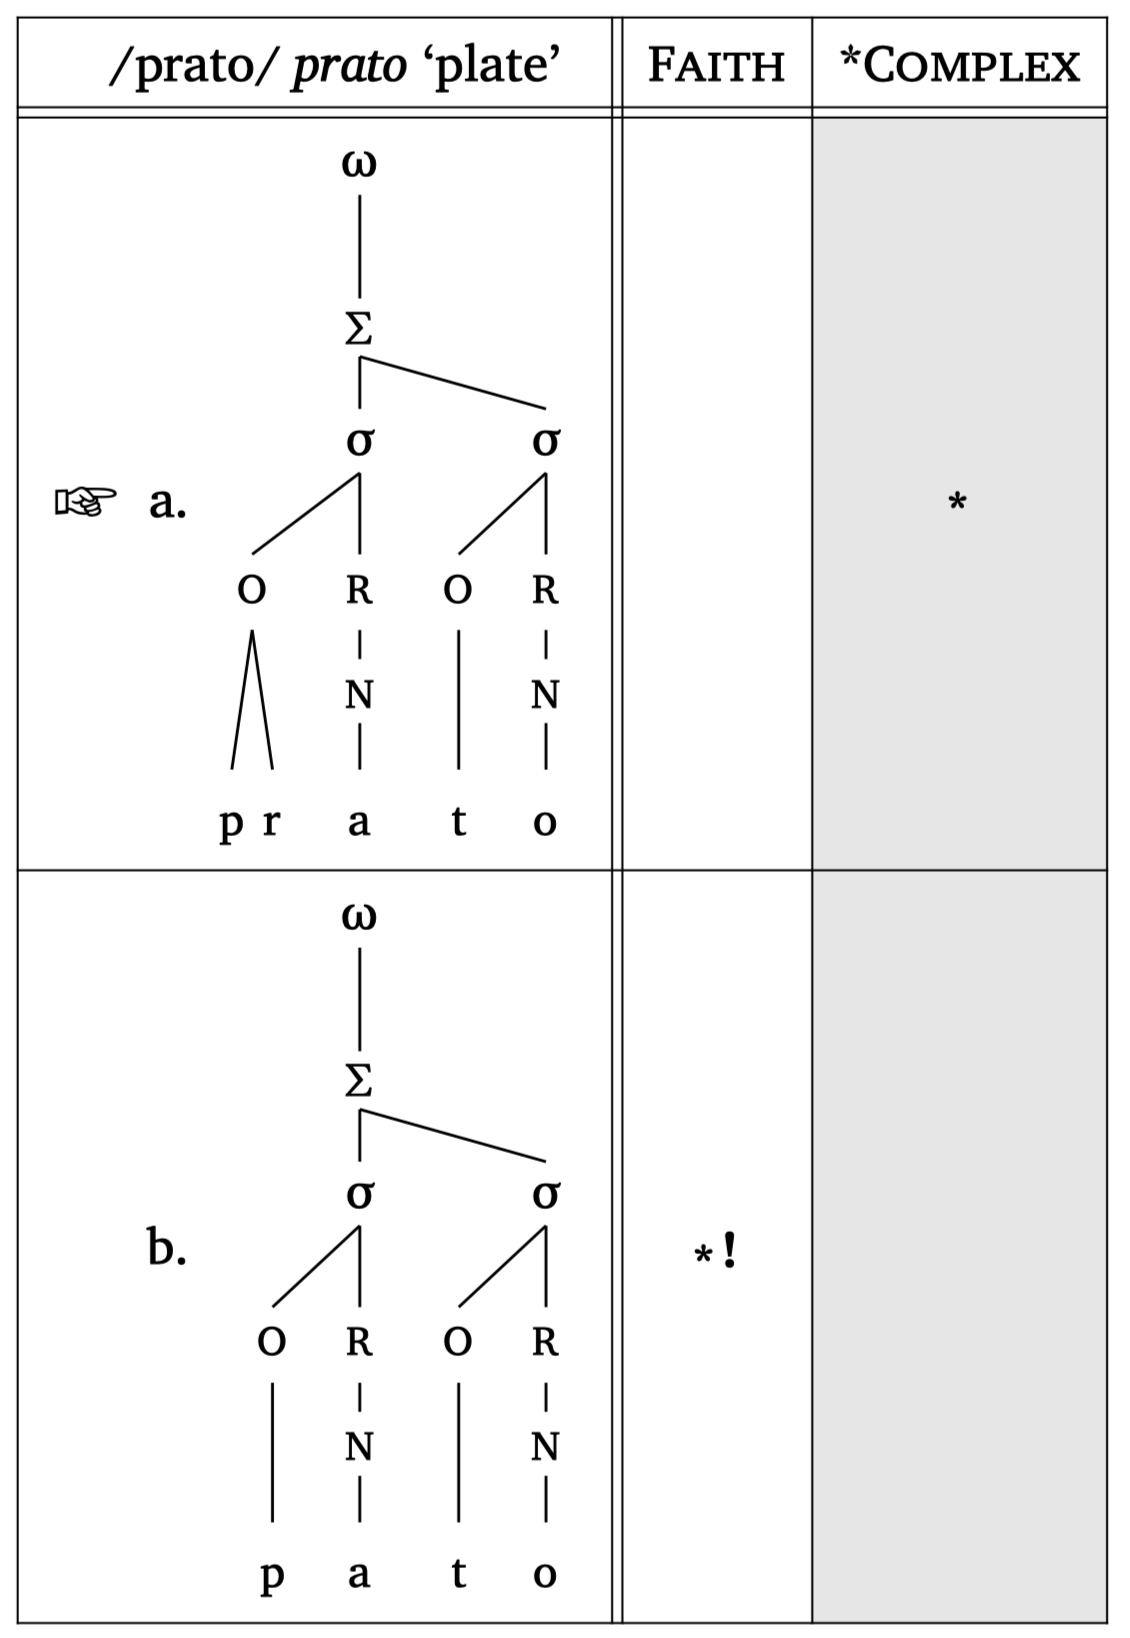
Tableau OT + prosodie
#tableau(
    input: "/prato/",
    candidates: (
      [#word("('pra.to)", scale: 0.8)],
      [#word("('pa.to)", scale: 0.8)],
    ),
    constraints: ("Faith", "*Complex"),
    violations: (
      ("", "*"),
      ("*!", ""),
    ),
    winner: 0,
    letters: true,
    gloss: ("prato", "plate"),
  )
Des diagrammes de Hasse pour le classement des contraintes peuvent être générés avec la fonction #hasse(). La fonction prend des tuples avec \(n\) éléments : un tuple à 2 éléments ("C1", "C2") trace un arc de classement ; un tuple à 1 élément ("C3",) crée une contrainte flottante. Le troisième élément d’un tuple contrôle le « stratum » (position verticale). Un quatrième élément peut spécifier le type de ligne : "dashed" ou "dotted".
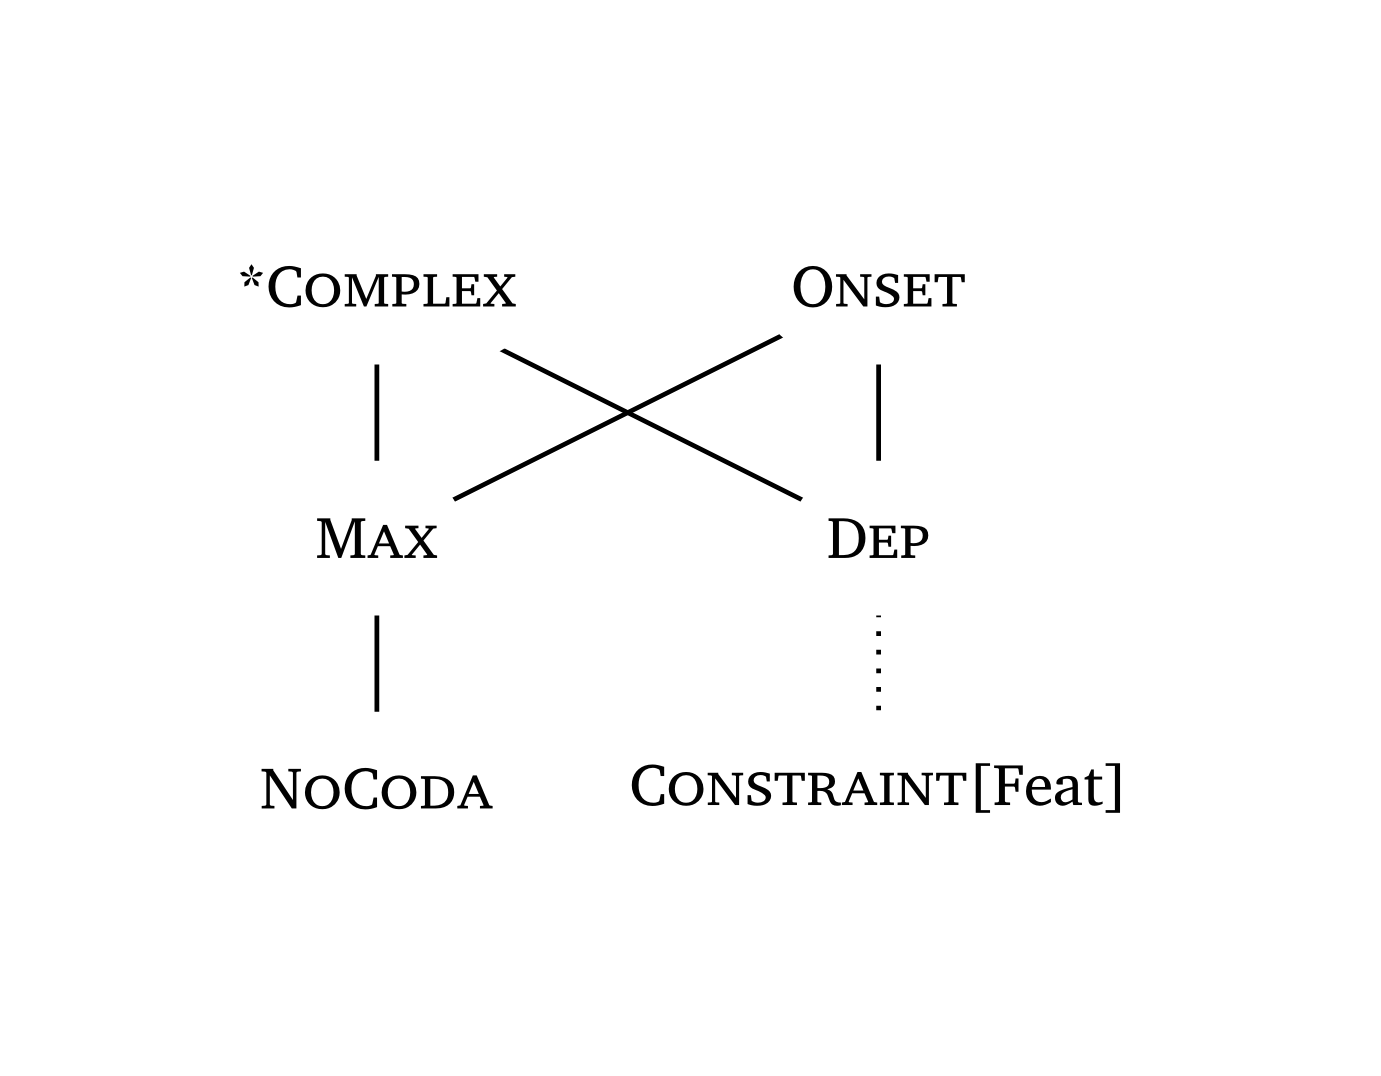
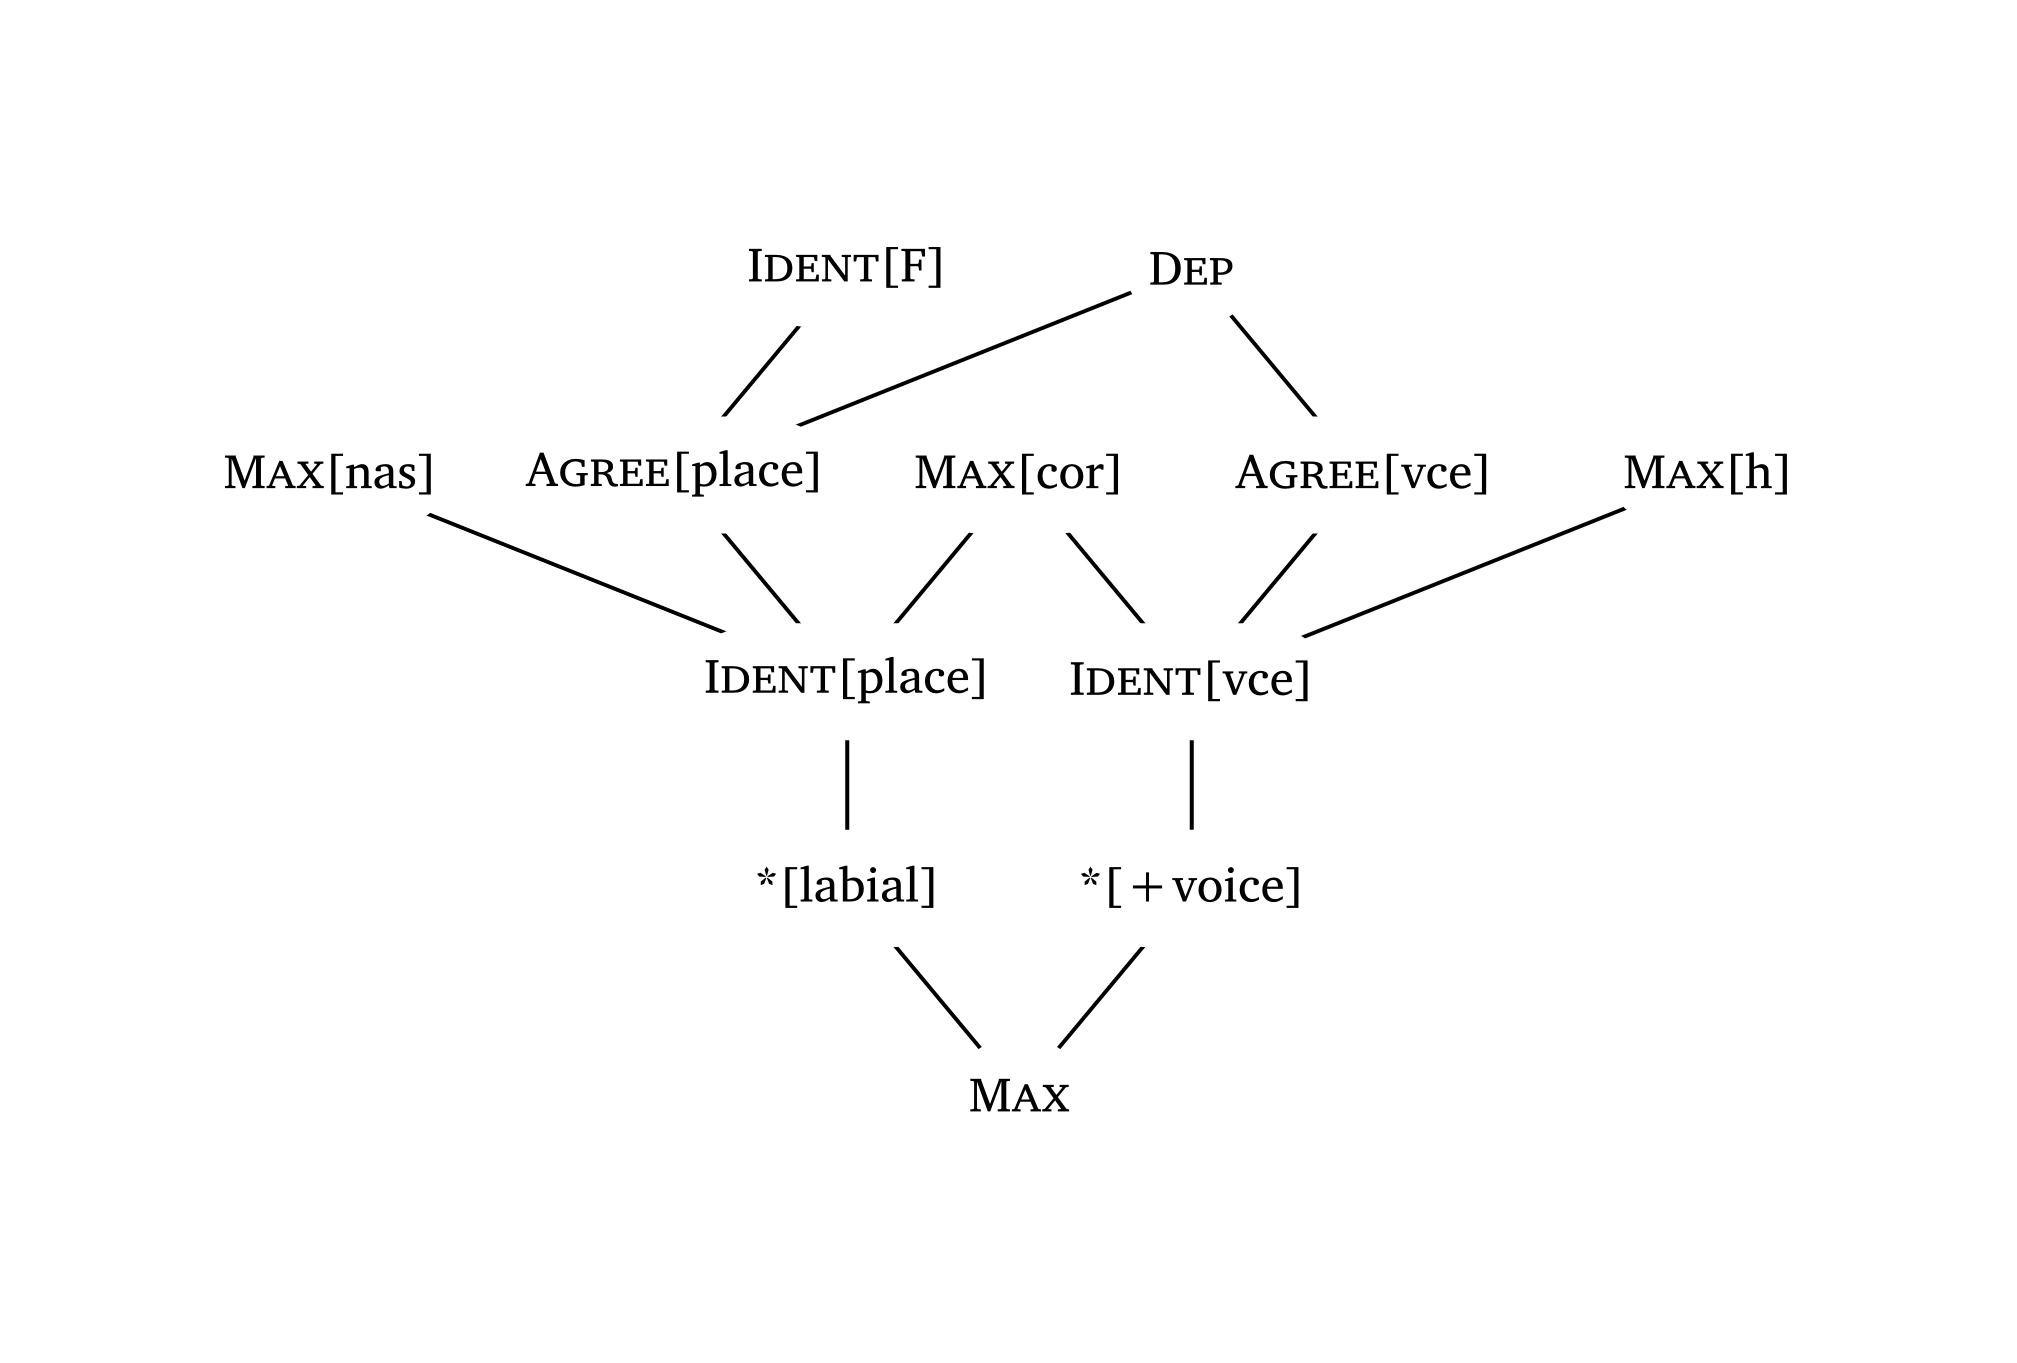
Les noms des contraintes sont automatiquement rendus en petites capitales (à l’exception des traits entre crochets).
Diagramme de Hasse avec lignes en pointillés
#hasse(
    (
      ("*Complex", "Max", 0),
      ("*Complex", "Dep", 0),
      ("Onset", "Max", 0),
      ("Onset", "Dep", 0),
      ("Max", "NoCoda", 1),
      ("Dep", "Constraint[Feat]", 1, "dotted"),
    ),
    node-spacing: 3,
  )
Diagramme de Hasse complexe
#hasse(
    (
      ("Ident[F]", "Agree[place]", 0),
      ("Dep", "Agree[vce]", 0),
      ("Dep", "Agree[place]", 0),
      ("Max[nas]", "Ident[place]", 1),
      ("Max[cor]", "Ident[place]", 1),
      ("Max[cor]", "Ident[vce]", 1),
      ("Max[h]", "Ident[vce]", 1),
      ("Agree[place]", "Ident[place]", 1),
      ("Agree[vce]", "Ident[vce]", 1),
      ("Ident[place]", "*[labial]", 2),
      ("Ident[vce]", "*[+voice]", 2),
      ("*[labial]", "Max", 3),
      ("*[+voice]", "Max", 3),
    ),
  )
9 Entropie maximale
La fonction #maxent() produit un tableau MaxEnt (Goldwater et Johnson 2003; Hayes et Wilson 2008). À partir des poids de contraintes et des violations, elle calcule automatiquement \(h_i\), \(e^{-h_i}\) et \(P(y|x)\) :
\[P(y|x) = \frac{e^{-\sum_{i=1}^n w_i C_i(y,x)}}{Z(x)}\]
La colonne \(h_i\) affiche le score d’Harmonie (somme pondérée des violations) ; \(e^{-h_i}\) est la probabilité non normalisée (score MaxEnt) ; et \(P_i\) est la probabilité prédite normalisée. La fonction imprime également des barres de probabilité dans la marge droite par défaut (visualize: true, en haut et en bas dans Figure 45) ; visualize: false les désactive (au milieu). Les candidats peuvent être triés du plus au moins probable avec sort: true (en bas dans Figure 45).
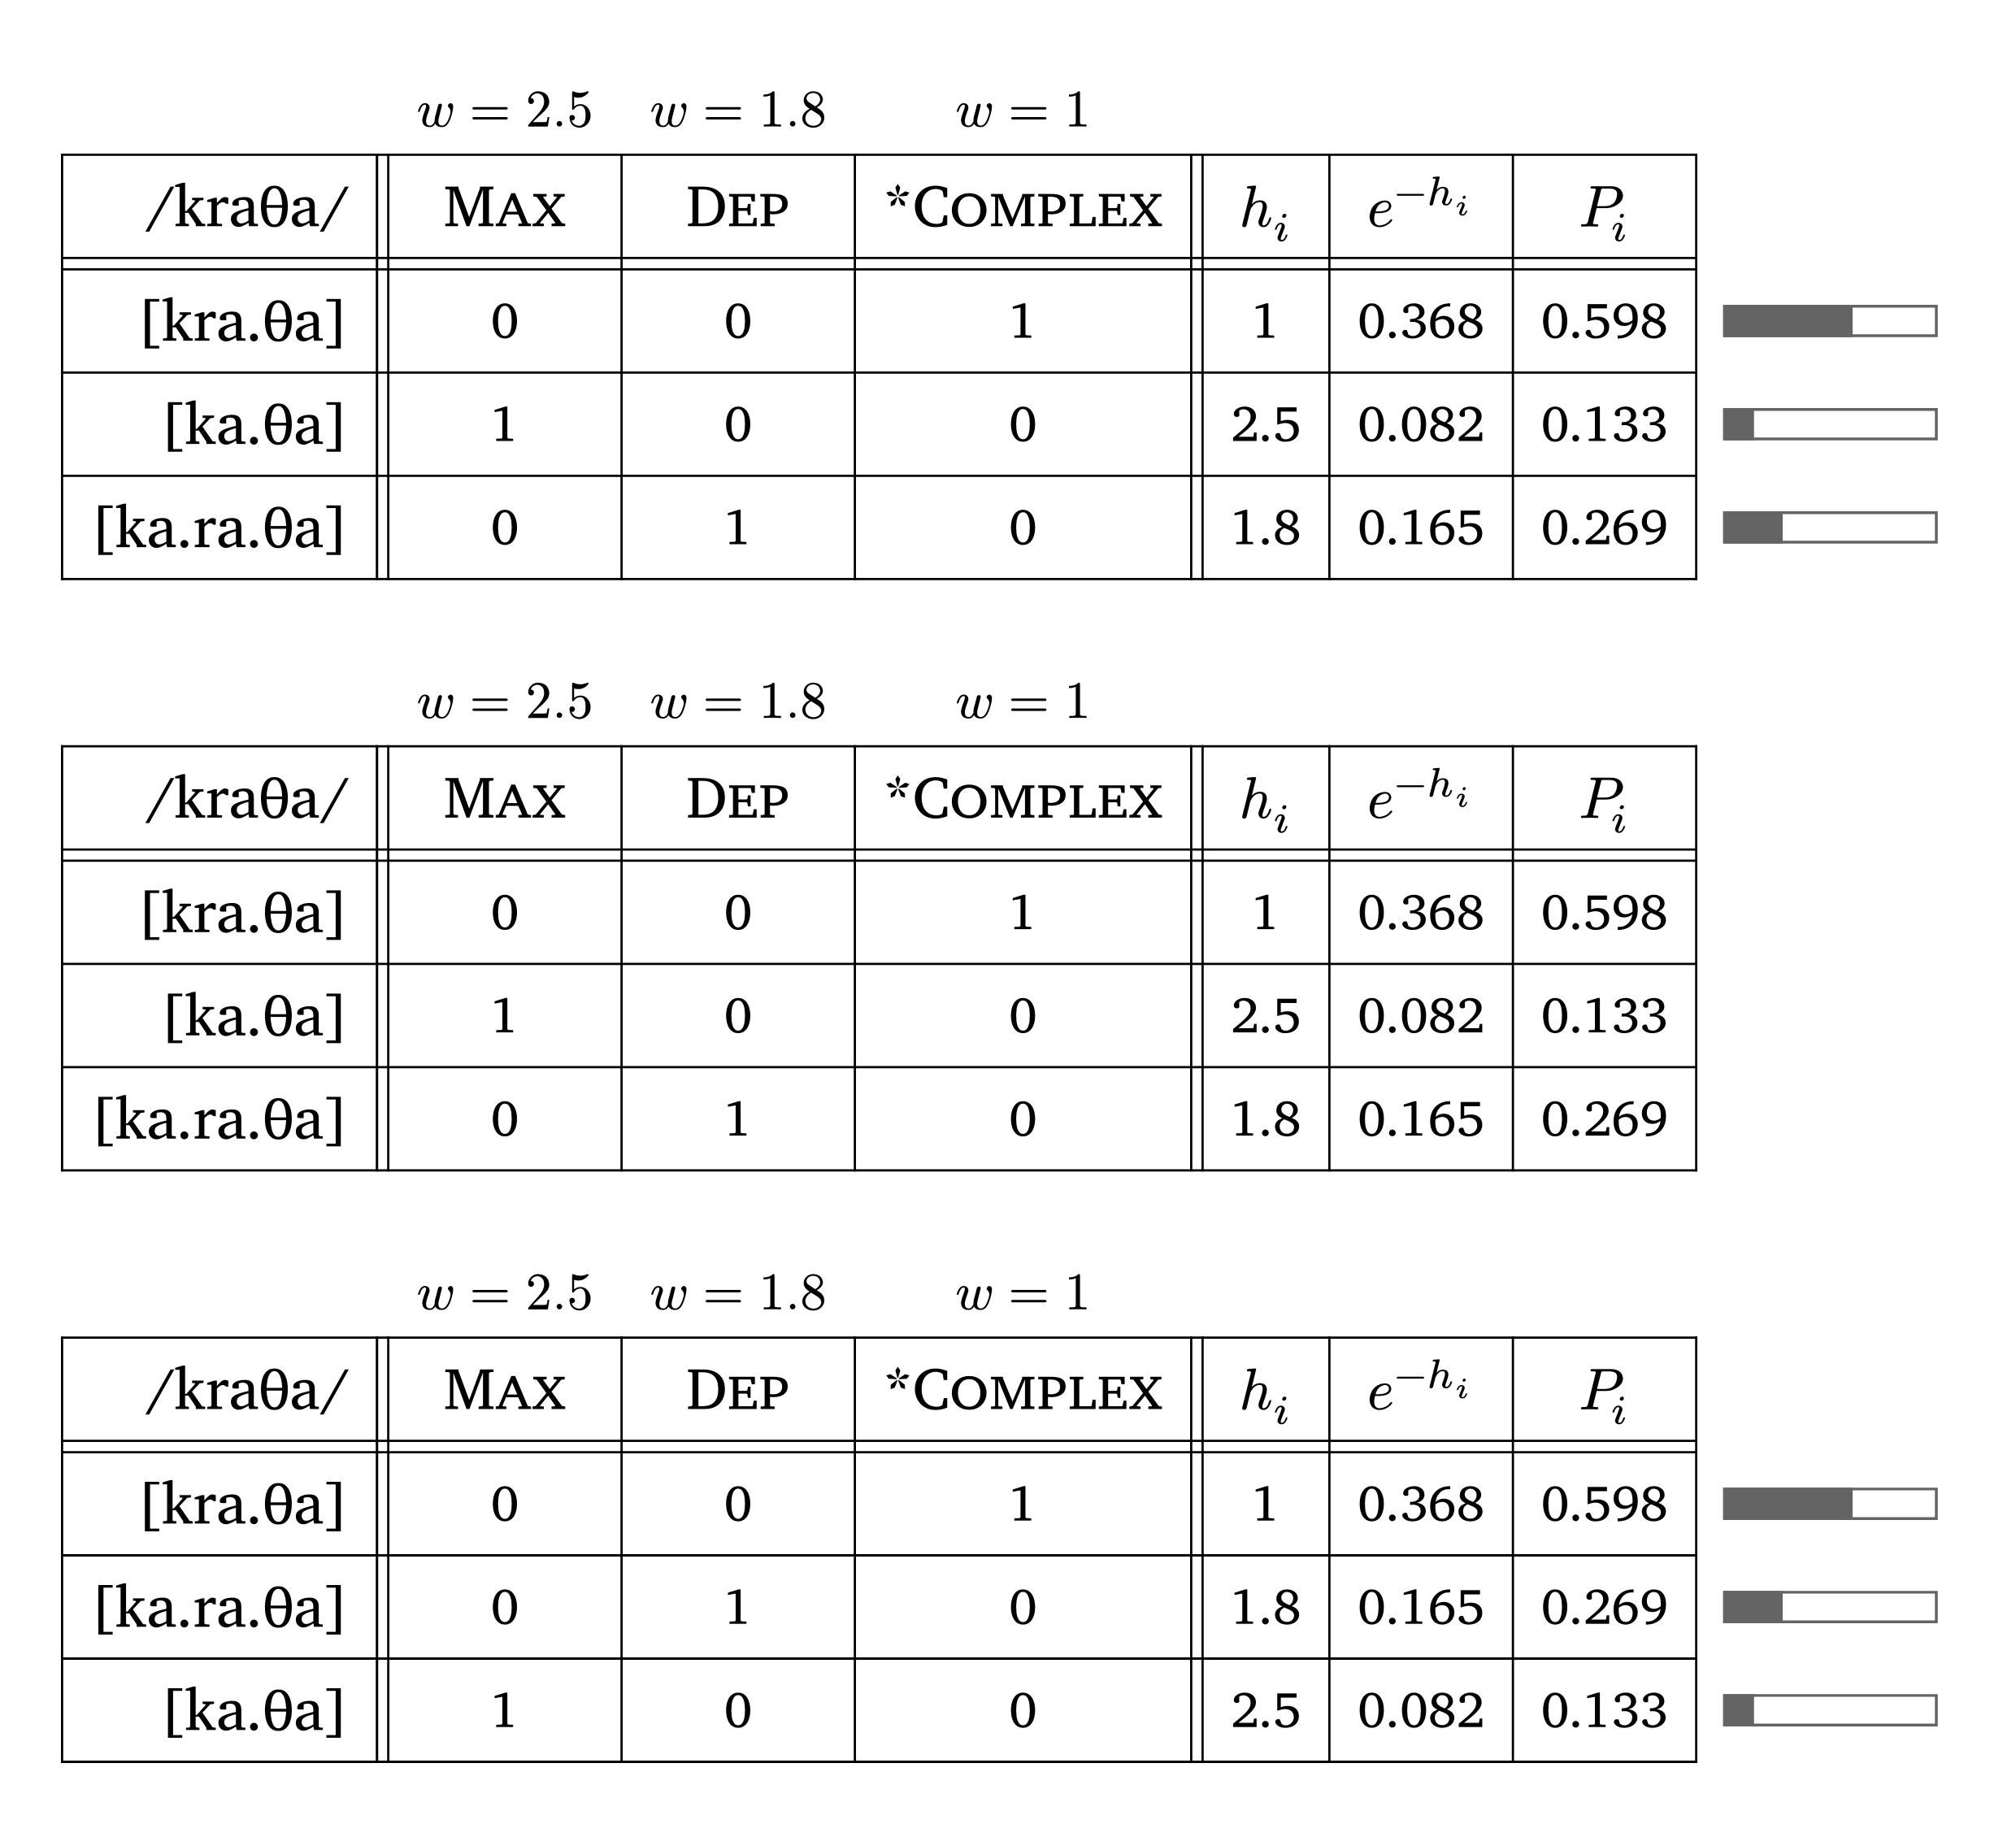
Tableau MaxEnt
#maxent(
  input: "/kraTa/",
  candidates: ("[kra.Ta]", "[ka.Ta]", "[ka.ra.Ta]"),
  constraints: ("Max", "Dep", "*Complex"),
  weights: (2.5, 1.8, 1),
  violations: (
    (0, 0, 1),
    (1, 0, 0),
    (0, 1, 0),
  ),
  visualize: true,  // show probability bars (default)
  sort: true,       // sort candidates from most to least probable
  letters: true     // assigned after sorting when sort: true
)phonokit dispose également de fonctions pour la Grammaire harmonique (#hg()) et la Grammaire harmonique stochastique (#nhg()). Ces fonctions partagent la même syntaxe que #maxent(), à une différence importante près : #hg() et #nhg() suivent la convention selon laquelle les violations sont des nombres négatifs et le candidat ayant l’harmonie la plus élevée l’emporte, tandis que #maxent() prend des violations positives. Si vous réutilisez un tableau violations provenant de #maxent(), il faut d’abord en inverser le signe. La fonction #nhg() dérive les probabilités en simulant des évaluations (par défaut : 1000) à partir des contraintes et violations, et peut afficher la colonne de bruit. Ces fonctions sont basées sur les conventions de Flemming (2021).
#hg(
  input: "/kraTa/",
  candidates: ("[kra.Ta]", "[ka.Ta]", "[ka.ra.Ta]"),
  constraints: ("Max", "Dep", "*Complex"),
  weights: (2.5, 1.8, 1),
  violations: (
    (0, 0, -1),   // note the negative violations
    (-1, 0, 0),
    (0, -1, 0),
  ),
)
10 Exemples numérotés
La fonction #ex() crée des exemples linguistiques numérotés. Dans sa forme la plus simple, elle reçoit directement le contenu, et le numéro est généré automatiquement : #ex[#ipa("/anba/") & #a-r & #ipa("[amba]")]. Utilisez & pour séparer les colonnes, comme dans les tableaux LaTeX ; le nombre de colonnes est déduit du nombre de séparateurs &. Pour les sous-exemples, utilisez la syntaxe de liste (-) : chaque élément reçoit automatiquement une lettre (a., b., …).
Pour utiliser cette fonction, ajoutez cette ligne après l’importation de la bibliothèque : #show: ex-rules
Exemple numéroté
// #import "@preview/phonokit:X.X.X": *
// #show: ex-rules  // <- add to your document
// ...
#ex(caption: "A phonology example",
    labels: (<ex-anba>, <ex-anka>),
    columns: (5em, 2em, 5em))[
      - #ipa("/anba/") & #a-r & #ipa("[amba]")
      - #ipa("/anka/") & #a-r & #ipa("[aNka]")
    ] <phon-ex>
Exemple numéroté ToBI
#ex(caption: "Some ToBI examples",
    title: [Autosegmental transcription of intonation in English @zsiga2013sounds],
    labels: (<ex-tobi1>, <ex-tobi2>),
    )[
      - You're a we#int("*L")rewolf?#h(1em)#int("H%", line: false)
      - I'm a wer#int("*H")ewolf.#h(1em)#int("L%", line: false)
    ] <tobi-ex>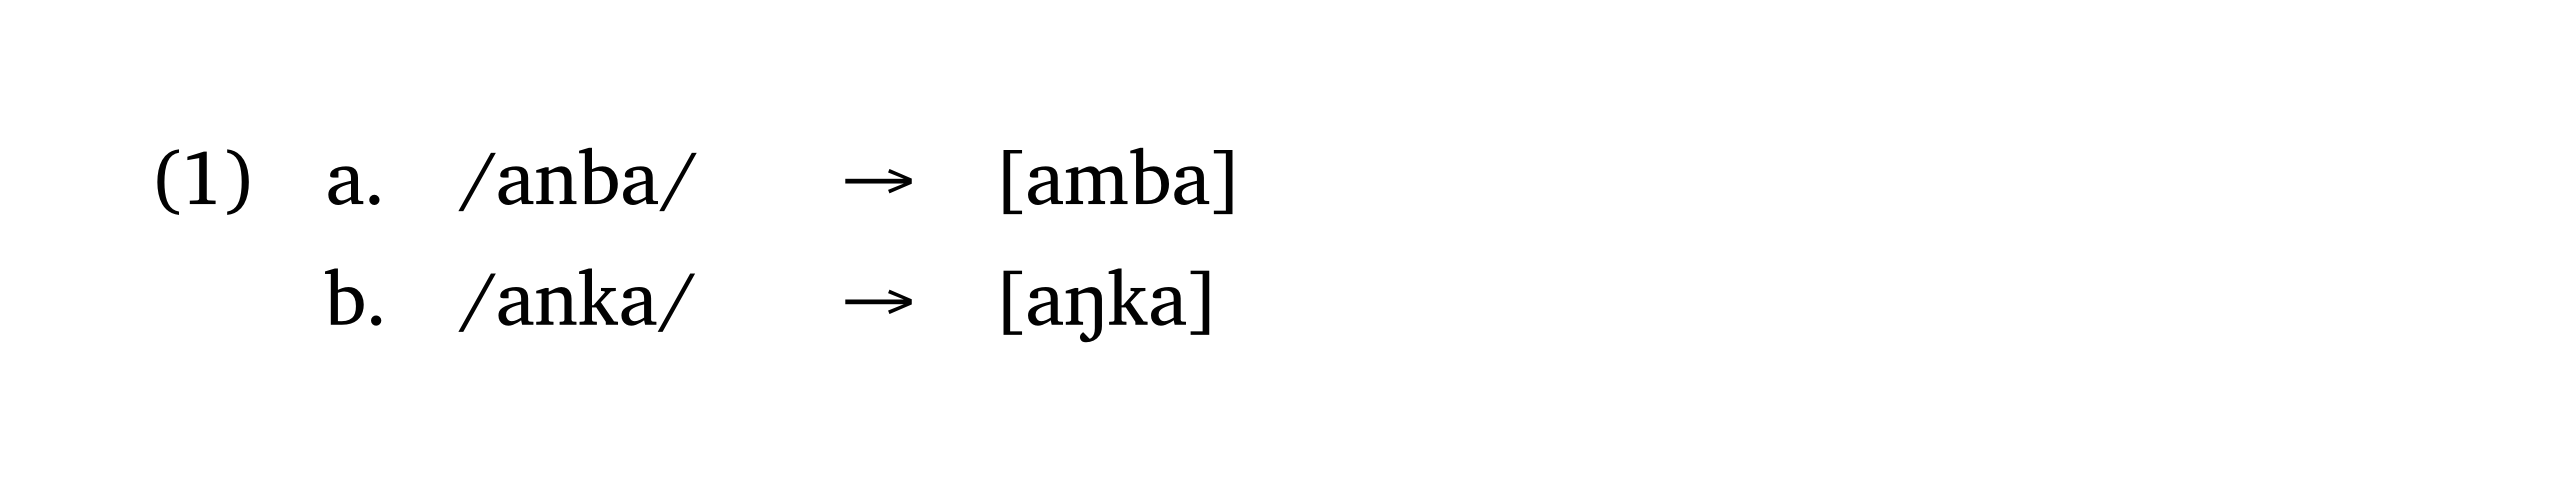
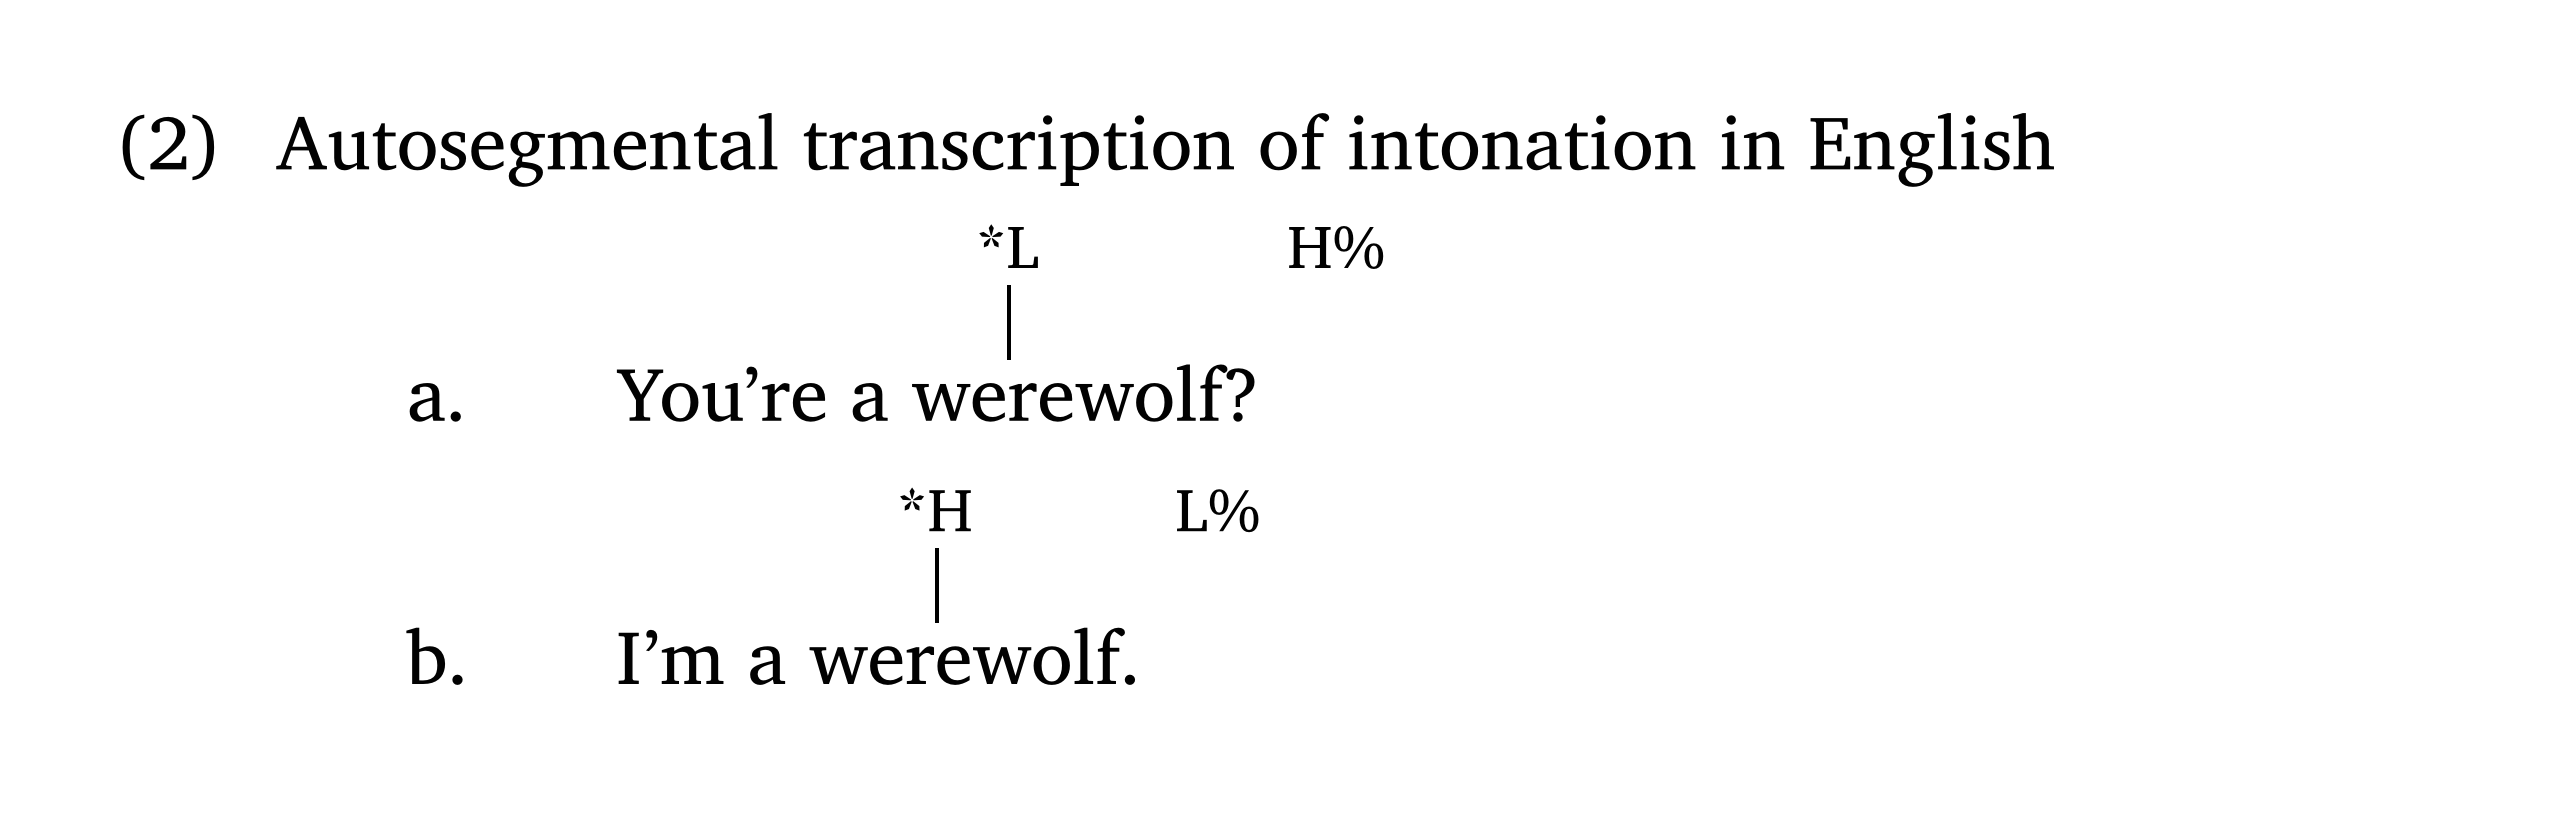
L’exemple entier peut être référencé comme @phon-ex, et les sous-exemples peuvent être référencés par leurs étiquettes (p. ex., @ex-anba) ; sans labels, seul l’exemple entier peut être référencé. L’argument columns est facultatif (les colonnes de données ont une largeur auto par défaut), mais spécifier les largeurs exactes garantit un alignement parfait entre les différents exemples du document.
L’argument facultatif title place un titre sur la même ligne que le numéro de l’exemple, avec les sous-exemples en dessous (Figure 47). L’argument caption dans #ex() n’est pas imprimé directement — il est là au cas où vous souhaitez créer une table des matières des exemples avec #outline(target: figure.where(kind: "linguistic-example")).
Copyright © Guilherme Duarte Garcia
Références
Notes de bas de page
Cela s’applique également aux autres fonctions basées sur les contraintes du package, abordées plus loin dans ce manuel.↩︎